Chiron 用实时上下文将 AI 事故调查准确率提升至多 50%,token 成本降至十分之一
来源标题:Real-time context lifted RCA accuracy up to 50% and reduced token cost to 1/10th
Chiron 通过流式引擎预计算系统上下文并直接提供给 AI 代理,使根因分析准确率最高提升 50%,token 成本降至原来的 1/10。该提升在不同前沿模型和代理组合下均成立,与模型和代理选择无关。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
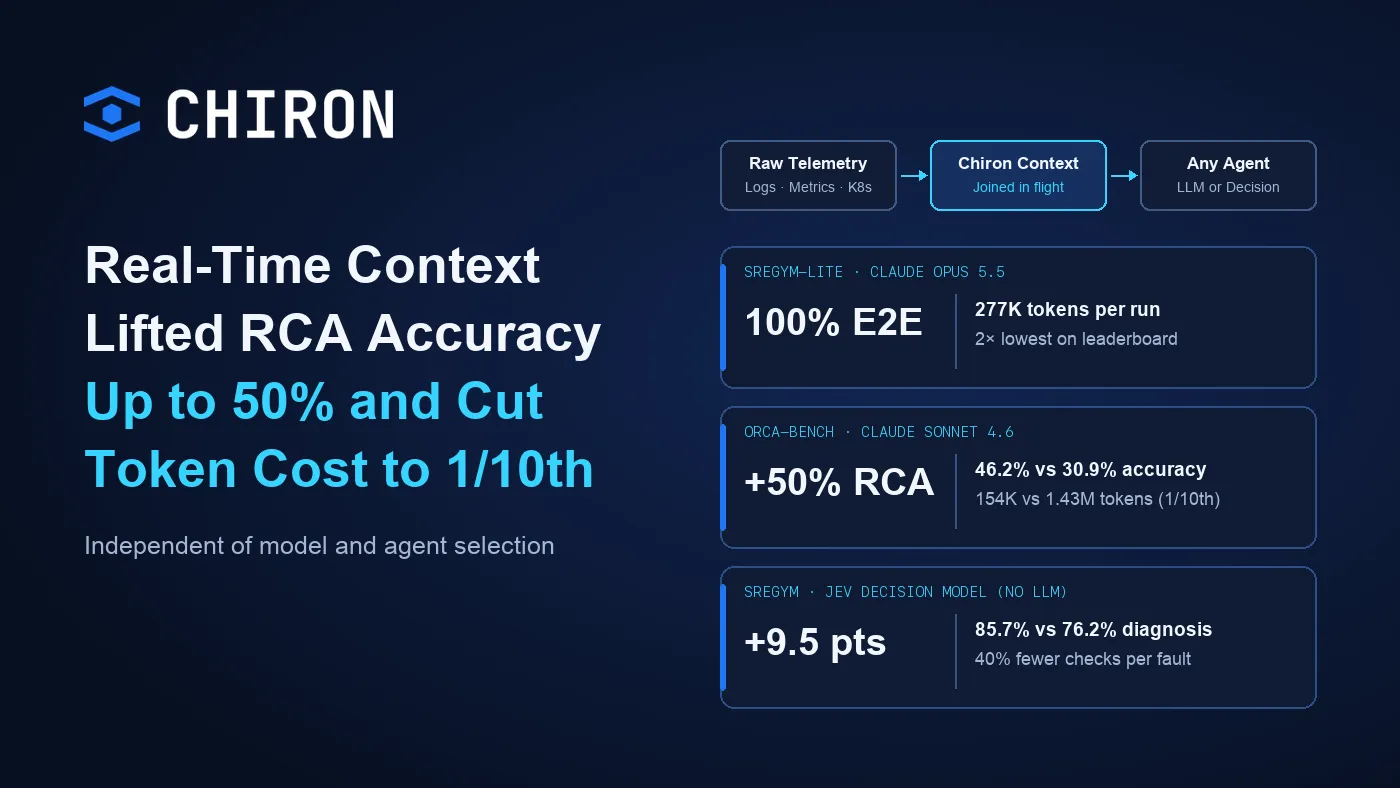
Chiron。 功能 使用场景 体验 关于我们 博客 估算日志节省量 预约演示 返回博客 实时上下文将 RCA 准确率提升高达 50%,并将 token 成本降至 1/10 提升效果与模型和 agent 的选择无关 当 AI agent 调查值班事件时,大部分时间都花在从原始遥测数据中构建上下文并将其拼接起来。它们在一个可观测性存储及其查询栈之上工作,通过查询来构建完整上下文,对多路遥测流执行 join,而每一路遥测流都有各自的粒度和基数挑战。 Chiron 的方法不同:它为 agent 提供预计算好的上下文数据。这之所以可行,是因为其流式引擎会在遥测数据到达时持续计算最新的系统状态。 我们尝试将 Chiron 构建的上下文数据(而非来自各种后端的原始遥测数据)提供给多个前沿模型,并在多个基准上测试了它们的准确率和 token 用量。结果非常令人鼓舞,本文将对它们进行讨论。 Chiron 通过在传输过程中以流式方式关联遥测数据,并在多个遥测流之间创建轻量级、已关联的上下文,从而促进 AI 驱动的调查。这为 AI agent 提供了预先拼接好的上下文,包括症状到原因的关联,而如果让 agent 自己从原始遥测数据中推导,这些关联的成本会很高。 这一模式在不同模型之间成立,甚至在不同类型的 agent 之间也成立——从基于 LLM 的 agent 到完全没有 LLM 的决策模型。这表明,你未必需要最昂贵的模型才能获得更好的结果。有了正确的上下文,你可以从已经在使用的模型中获得显著更多的收益,这也打破了普遍说法:要想获得更好的 AI SRE 表现,就必须使用更好、更先进的模型。有了更好的上下文数据,你可以在使用现有模型的同时,同时获得更低的推理成本和更高的准确率。 关于提升 AI agent RCA 质量的说法,已在知名基准上进行了测试。 SREGym 是一个面向 AI SRE agent 的开放基准,由 UIUC 构建。它会在一个运行中的 Kubernetes 集群上破坏真实应用,故障范围从错误配置到运行时变更,这些都会扰乱常规流程和检查,并要求 agent 在同一次运行中说出根因并修复它。 针对 SREGym,我们在上下文状态 API 之上构建了只读 MCP 工具。每个工具都读取实时状态,而不查询原始遥测数据。 简报的编写方式使其导向验证。每条线索都会说明它为何与故障相关,这样 agent 就可以核验这一说法,而不是盲目相信它,并确保不会给出虚构的方向。这些关联来自已关联的上下文:因为症状、工作负载和变更已经在传输过程中完成了 join。 下面是一份真实简报的开头,来自一次运行:一个异常的准入 webhook 将某个 service 的内存限制从 256MB 改写为 16Mi,导致 pod 调度失败: SYMPTOMS(自首次变更以来新增):
- nginx-thrift(1 个 pod):运行中的内存限制为 16Mi,pod 模板设置为 256Mi LEADS(症状附近的变更;请逐条核验,这些不是结论):
- [可在创建时重写 pod,并影响到出故障的 nginx-thrift] MutatingWebhookConfiguration gatekeeper-mutating-webhook-configuration: objectSelector 设置为 {}(另有 9 个字段)于 06:42:25Z
- [仅时间] MutatingWebhookConfiguration kyverno-resource-mutating-webhook-cfg ...
- [仅时间] MutatingWebhookConfiguration cert-manager-webhook ... (最新数据为 1 秒前。此处不可见:secret 值、进程内存、请求 trace) 简报告诉 agent 三件事: Claude Code 搭配 Chiron 和 Claude Opus 5.5(中等努力)在每一次尝试中都诊断并修复了每一个 SREGym-Lite 故障:100% 诊断、缓解和端到端完成,每次运行 277K tokens,在排行榜上所有条目中 token 数最低,且比第二名低 2 倍。已发布在 SREGym 排行榜上。 我们还验证了,已关联的上下文应当有助于处理它的任何语言模型。在 SREGym 上,我们测量了 Jev 决策模型在有和没有 Chiron 时的表现,并确保循环中没有 LLM。 来自 TypeSafe 的 Jev 通过选择要运行哪些检查并权衡它们返回的结果来进行诊断。我们在相同设置下运行了单独的 Jev 和带上下文数据的 Jev,覆盖 21 个故障。 LLM agent 和决策模型的工作方式完全不同,除了提供给它们的上下文之外没有任何共同点。使用 Chiron 时,两者都减少了探索,并且正确率更高。这正是上下文层的意义:它改善你已有的消费者,无论其能力如何。 ORCA-bench 用于在一个运行中的电商 OpenTelemetry Astronomy Shop 应用上测试事件调查,该应用约有 20 个服务处于负载之下,真实故障通过 feature flag 注入。agent 会收到来自真实 SRE 人员或客户报告的信息,例如“顾客购买时遇到问题”,然后它必须找出解释事件如何发生的每一个根因并引用证据。由 LLM 裁判对报告评分。 在论文中,agent 通过 Grafana 后面的 Prometheus、Jaeger 和 OpenSearch 进行调查。在我们的运行中,Claude Sonnet 4.6 改为读取已关联状态,覆盖 526 个公开事件工单和 138 个安静窗口对照(即未注入故障)。 与使用 Grafana 的 Sonnet 相比,上下文数据将准确率提高了 50%,同时 token 用量减少了 10 倍。
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。