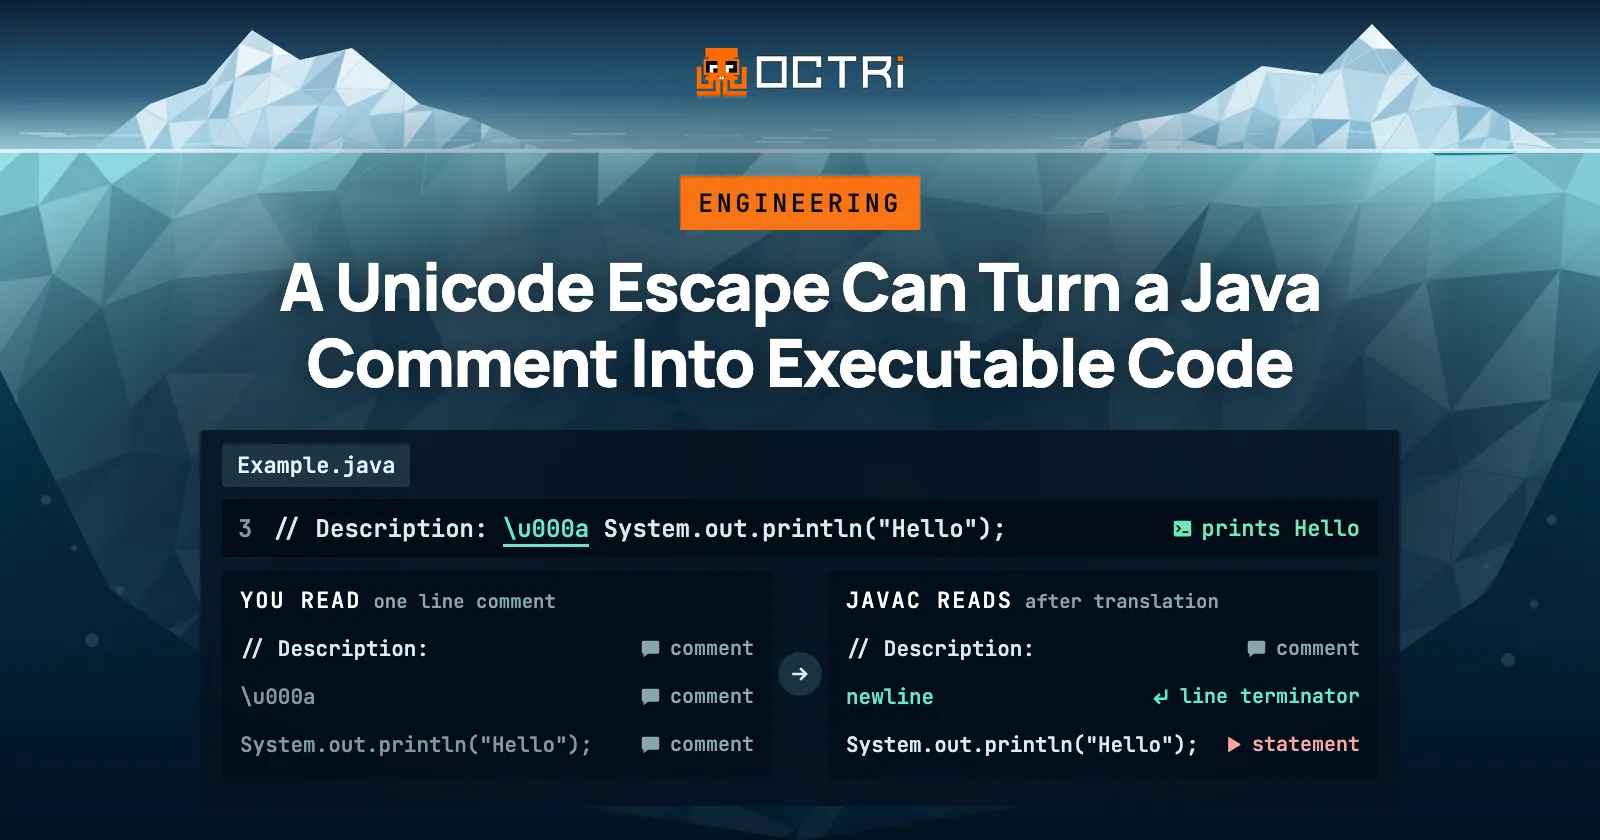
未转义的 Unicode 字符可将 Java 注释变为可执行代码
来源标题:A Unicode Escape Can Turn a Java Comment into Executable Code
如果 SDK 生成器在将 OpenAPI 文档复制到 Java 源代码时未对 Unicode 转义进行转义,注释中的 \u000a 会被编译器当作换行符处理,使其后的代码脱离注释并被执行。该行为已在 OpenJDK 21 上复现,且属于 Java 语言规范长期以来的规定。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
当SDK生成器把OpenAPI规范中的文档说明复制到源代码里,却没有做转义处理时,会发生什么?
这个Java程序本该什么都不做。
它包含一个小类,类里有一个main()方法,还有一行看起来是注释掉的文本。我用javac编译并运行了它,结果却出乎意料。
class Example {
    public static void main(String[] args) {
        // Description: \u000a System.out.println("Hello");
看第三行。System.out.println()语句出现在//之后,按理说应该属于注释的一部分。
\u000a这个序列代表换行符。根据Java语言规范,Unicode转义在编译器识别注释、字符串和其他token之前就已经被处理了。
等到Java处理到注释时,源码实际上已经变成了这样:
class Example {
    public static void main(String[] args) {
        // Description:
        System.out.println("Hello");
编译器看到一个完全合法的程序,于是执行了这条语句。
我用OpenJDK 21复现了这个现象。这是Java语言规范的一部分,而且已经存在很长时间了。
真正有意思的是,那条原始注释可能是从哪儿来的。
开发者大概不会故意写这种东西。但代码生成器在从API规范复制描述时,却很可能产出非常相似的内容。
而生成器必须足够了解Java编译器,才能防止这种情况发生。
OpenAPI文档用结构化数据来描述API。
它包含端点路径、请求参数、响应schema、认证要求,以及客户端与服务器通信所需的其他信息。
paths:
  /users:
    get:
      summary: List users
      description: Returns the users available to the caller.
SDK生成器读取这份文档,生成对应的客户端方法。
/**
 * Returns the users available to the caller.
 */
public List<User> listUsers() {
    // ...
}
描述变成了生成SDK中的文档。开发者可以在IDE里把鼠标悬停在方法上,读到来自API规范的说明。
这是个有用的功能,实现起来似乎也很直接。
读取描述。放进注释里。写出源文件。
只不过,这段描述属于另一种语言。
在OpenAPI文档里,它是一个字符串。YAML解析器把它当作数据。它没理由关心这个字符串里是否包含Java注释定界符、Ruby插值语法或PHP结束标签。
一旦生成器把同样的字符串写进源文件,这些字符就获得了新的含义。
语言编译器不知道它们来自OpenAPI文档。它看到的只是构成程序一部分的字符。
这就是生成器必须守住的边界。
OpenAPI文档                           SDK生成器
description: YAML中的字符串    →    结构化数据变成源代码
                                      ↓
                                  上下文感知编码器
                                  针对Java注释进行转义
                                      ↓
直接文本插入                          描述保持为注释
字符串原样复制                        Java源码结构不变
                                      ↓
程序结构改变
一个Java序列离开了注释
描述从结构化数据跨越到源代码的边界
Java的例子展示了这条边界失效的一种方式。其他语言也有各自的方式,去解释那些在规范里看起来无害的文本。
PHP似乎是下一个自然的考察对象,因为它与注释和源文件边界之间有着不同寻常的关系。
PHP文件可以在PHP代码和PHP标签之外的内容之间切换。这对模板和服务器渲染页面很有用,但也引入了在生成源代码时不容忽视的行为。
<?php
// Description: Returns the current user.
通常的预期是,//之后的所有内容一直到换行符为止都保持注释状态。
但结束标签?>会终止当前的PHP代码块,即使它出现在单行注释里也是如此。
PHP手册明确记录了这一行为。
我用PHP 8.5复现了它。行注释里的结束标签让解释器退出了PHP模式。当后续出现开始标签时,PHP又恢复了代码执行。
对于手写PHP的人来说,这个行为可以理解。PHP的开始和结束标签是其语法的基本组成部分。
但对SDK生成器来说,这又创造了一个周边模板未必能按预期容纳输入的地方。
假设生成器用PHP行注释来记录一个方法。描述来自OpenAPI文件,模板作者以为注释前缀会让其中的内容变得无害。
这个假设只有在生成器考虑了PHP标签处理的前提下才成立。
Java的Unicode处理和PHP的标签转换是两种不同的机制,但它们给生成的源代码造成了同样的问题:作为文档提供的字符,能够影响语言对文件的解析方式。
补救措施必须在源代码到达编译器或解释器之前就实施。
在PHP中,这意味着在写注释时处理标签定界符。在Java中,这意味着在注释被识别之前就考虑Unicode转义的处理。
而注释只是问题的一部分。
文档字段并不是OpenAPI中唯一的自由文本值。
规范中还包含示例、默认值、枚举值以及其他字符串,生成器经常把它们复制到源代码字面量中。
Ruby提供了一个很好的例子,说明为什么这些值同样需要小心处理。
假设规范中包含这样一个示例:
example: 'Result: #{1 + 1}'
预期的值是字面字符串Result: #{1 + 1}。
现在想象一个Ruby生成器构造出下面这个常量:
EXAMPLE = "Result: #{1 + 1}"

(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。