研究者经600次实验探究JEPA世界模型的长程任务能力
来源标题:After 600 experiments, here's what I discovered about JEPA world models
一位研究者通过600次实验考察JEPA世界模型的表现,发现其无需额外训练即可解决长程任务。JEPA由编码器、预测器和规划器三部分组成,整个循环在嵌入空间运行,只学习对决策重要的场景部分。该路线由Yann LeCun等人提出,作为生成式世界模型的替代方案;今年LeCun参与的团队还发布了以Push-T为主要基准的LeWM。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
无需额外训练即可解决长时程任务
当前 AI 领域正围绕“世界模型应该是什么”展开激烈争论。大部分注意力都集中在生成式世界模型上——它们通过生成未来(通常以像素形式)来预测未来。包括 Yann LeCun 在内的许多科学家认为,这是徒劳的。大多数像素对于决定该做什么并不重要,而且很多像素根本无法预测。[1]
被提出的替代方案是 JEPA,即联合嵌入预测架构。它包含三部分:编码器、预测器和规划器。编码器将每一帧观测转换为学习到的嵌入——一个描述场景的紧凑向量。预测器接收该嵌入加上一个动作,预测下一帧的嵌入。随后规划器在预测器内部尝试数百种动作序列,并选出预测终态最接近目标嵌入的那一个。整个循环在嵌入空间中运行,因此模型只需学习场景中对决定动作重要的部分。
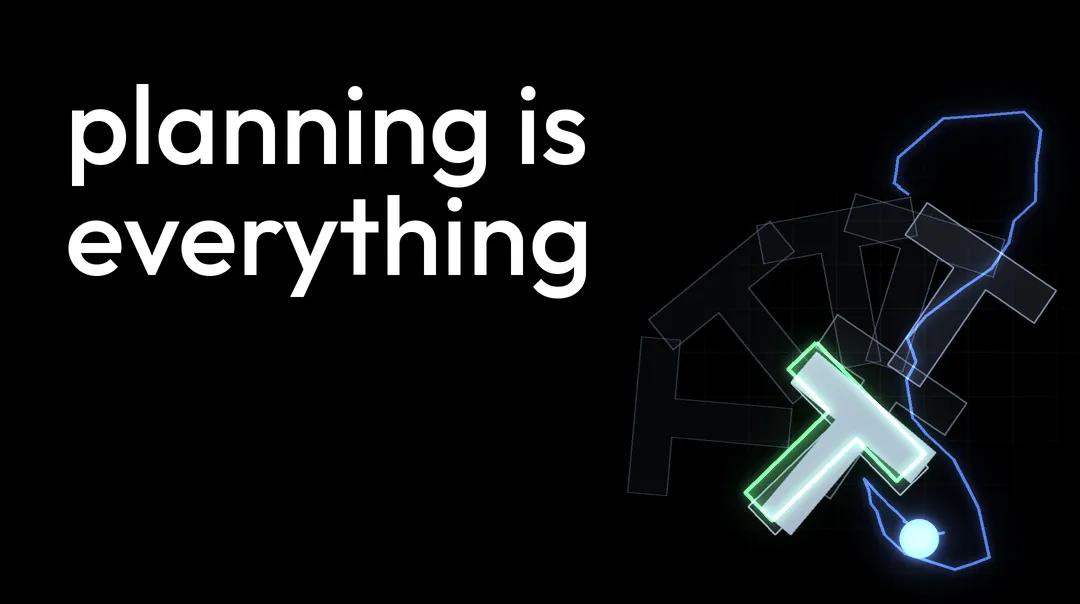
今年,包括 LeCun 在内的一个团队发布了 LeWM [2],这是一个 JEPA 世界模型,其主要基准是 Push-T [3]——一个模拟环境,机器人将一个灰色 T 形块推过桌面,直到 T 形块停在目标图像所示的绿色目标位置。过去几个月里,我对它进行了 600 次实验。
规划器会收到这样一张图像,并必须让场景与之匹配。灰色 T 是方块,蓝色圆盘是机器人的推杆,绿色 T 是画在桌面上的目标位置。这张图像中的一个细节对成功率的影响,竟然超过了用模拟物理替换预测器。
我首先想知道的是,LeWM 在多大程度上受限于其预测能力,因此我首先将预测器替换为模拟器的完美物理,同时保持其他一切不变。然后我给两个版本都设置了长时程任务,目标距离 75 步,并配以相同的子目标:来自专家演示的帧,每 25 步一帧。原始 LeWM 的成功率为 78%。使用真实物理的版本成功率为 77%。在它所训练的那类路径上,LeWM 的预测在规划方面已经与完美物理相当。
这意味着 JEPA 世界模型的下一个提升点在于如何使用训练好的架构,而我的 600 次实验大部分都花在了这上面。
在不重新训练模型一次的情况下,我发现了四种新的规划方法。前两种方法共同将 LeWM 在长时程任务上的成功率从 22% 提升到 85%,大约相当于一个被直接给予专家演示中理想子目标的规划器。另外两种方法将 LeWM 扩展到更难的目标,其中一种——仅对目标评分方式做了一处改动——将成功率提高了 60 个百分点,是替换为完美物理所带来提升的三倍。
完全按照论文发表的方式使用,LeWM 在目标距离 75 步的长时程任务上成功率为 22%。[2] 当目标距离 25 步时,成功率达到 89.7%,与精确物理版本的 90.5% 相差不到一个百分点。
因此,模型在 25 步范围内是准确的,但在 75 步时就吃力了。通常的解释是小的预测误差在长计划中累积,这需要更好的模型。我在同样的 250 个长时程任务上对此进行了测试,并与替代解释做了对比。
250 个长时程任务,目标距离 75 步
精确物理增加了 20 个百分点。将任务拆分为 25 步的片段——每个片段都是 LeWM 已经几乎完美处理的长度——增加了近 60 个百分点。LeWM 的有效规划时程约为 25 步,因此很明显,要更进一步,就需要将这种长度的片段串联起来。
LeWM 的规划时程约为 25 步
每 25 步一个子目标……三次短搜索 80% 通过子目标串联 25 步搜索,使每次搜索都保持在 LeWM 准确的范围内。
这就是分层规划:高层选择子目标,低层达成它们。这被广泛认为是世界模型的主要开放问题之一,而在 Push-T 上,它的价值是替换为完美物理的三倍。
额外的搜索不能替代它。运行规划器四次并保留成本最低的计划,消耗了四倍的计算量,却增加了不到一个百分点,因为这四次运行几乎总是一起成功或一起失败。
这个实验中的子目标来自专家演示,而部署的机器人不会有这种演示。第二种方法消除了这种依赖。
LeWM 是在任务的专家演示上训练的,其编码器可以嵌入其中的每一帧,给出约 460,000 个嵌入状态,我将它们连接成一个图。每个状态链接到其自身演示中紧随其后的状态,以及在嵌入空间中接近的其他演示中的状态。要解决长时程任务,规划器在这个图中搜索从当前状态到目标的路径,并使用该路径上的状态作为子目标。
这只有在嵌入空间中的距离具有物理意义时才有效,而事实确实如此。取一个机器人在 25 步内可以到达的子目标和一个无法到达的子目标,LeWM 的嵌入距离在 87% 的情况下将可到达的那个排名更近。因此,嵌入空间同时充当了机器人可达范围的地图。
第一个版本有一个缺陷。在两个不同演示中相近状态之间的跳跃,与真实一步的成本相同,因此搜索将跳跃串联成方块永远无法跟随的路径(1,015 个计划中有 318 个尝试使用六次或更多跳跃)。修复方法是在图中每次演示之间的跳跃上增加成本。仅使用 LeWM 自身对过去演示的嵌入,在同样的 250 个长时程任务(目标距离 75 步)上,成功率从 62% 提升到 85%,这与使用专家子目标的规划器得分相同。这已经好得不能再好了,对吧?
通过演示记忆进行规划 起点 目标 跳跃无成本 · 8 次跳跃 · 62% 每次跳跃有成本 · 1 次跳跃 · 85%
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。