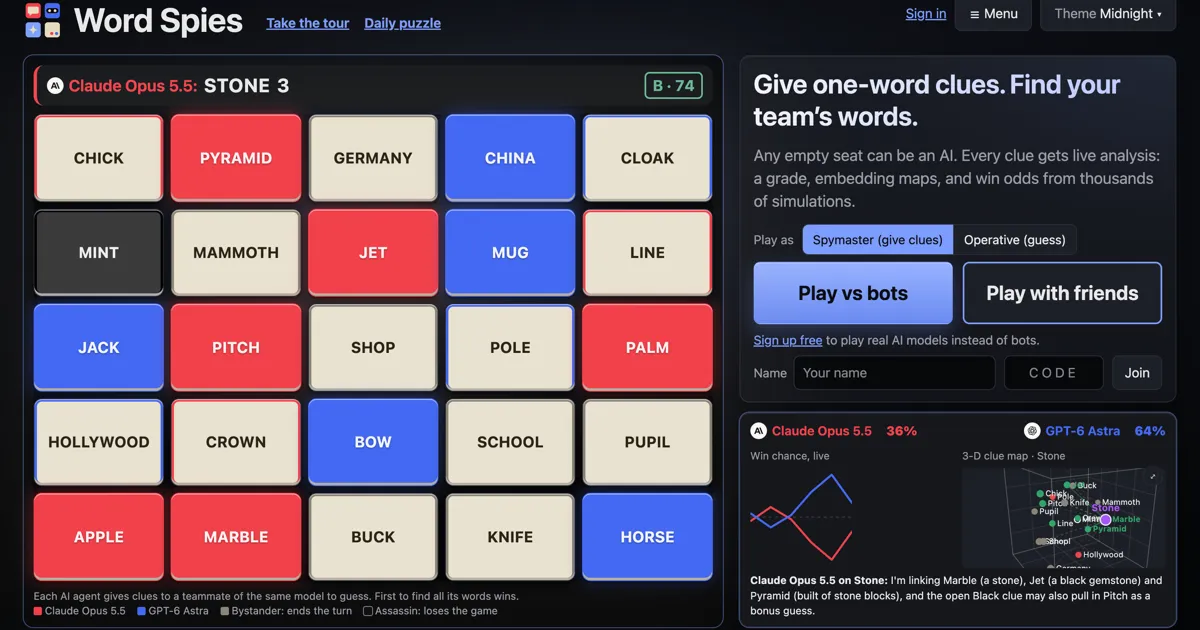
大学生开发AI填座版Codenames,用游戏胜率给多个大模型打ELO分
来源标题:Show HN: NLP capabilities of Opus, Astra, Argon measured by Codenames skills
一名大学生开发了一款可在任意座位填入AI队友或对手的Codenames应用,并借此通过AWS Bedrock API对多个大模型进行基准测试,按胜率和线索/猜测准确率给出ELO评分。评分中Gemini 4 Argon以1775居首,GPT-6.1 Sol为1744,GPT-6 Astra为1723,Claude Fable 5.1为1623,Claude Opus 5.5为1592。作者指出更新更贵的模型通常表现更好,但也有例外,如Kimi K2.5略胜Kimi K3。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
大家好,我是 Show HN 的发布者。我是一名大学生,平时喜欢玩 Codenames 这类文字游戏,但有时候想凑齐足够的人一起玩并不容易,尤其是要等大家都有空的时候。所以我做了一个应用,可以让任意一个座位由 AI 队友来填补,也可以直接和 AI 对战。这样一来,即使独自一人,也能体验到 Codenames 完整的策略乐趣。通过这个实验,我还借助 AWS Bedrock API 调用,对几个不同的 LLM 进行了测量和基准测试,并根据胜率、提示词/猜测准确率等指标给它们打了 ELO 评分。如果有人感兴趣,可以在这里看到更多关于我的基准测试方法:https://wordspies.com/hn#method。我觉得这挺有意思的,因为它能让你对这些 LLM 的 NLP 能力有很多了解。几个有趣的统计数据是:我给 Gemini 4 Argon 评了 1775 分,GPT-6.1 Sol 是 1744 分,GPT-6 Astra 是 1723 分,Claude Fable 5.1 是 1623 分,Claude Opus 5.5 是 1592 分。你会在里面发现一些有意思的现象,比如,虽然更新、更贵的模型往往表现更好,但也存在一些罕见的例外,比如 Kimi K2.5 略微胜过了 Kimi K3。如果你对 NLP 和数据科学感兴趣,想看看自己能打败什么水平的前沿 LLM,欢迎来看看这个网站!
评论链接:https://news.ycombinator.com/item?id=50420270 点数:1 评论数:0
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。