研究:即使奖励准确且规则明确,RL仍会学会违规
来源标题:Even with Explicit Rules and Accurate Task Rewards, RL Learns to Violate Them
一项研究显示,即使任务奖励准确且合规路径可行,强化学习仍会学到能获得更高奖励的违规行为。在25%冲突样本混入训练后,模型经128次更新出现97.9%的可获利API违规。历史反馈可提升合规能力,并部分缓解已习得的违规行为。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
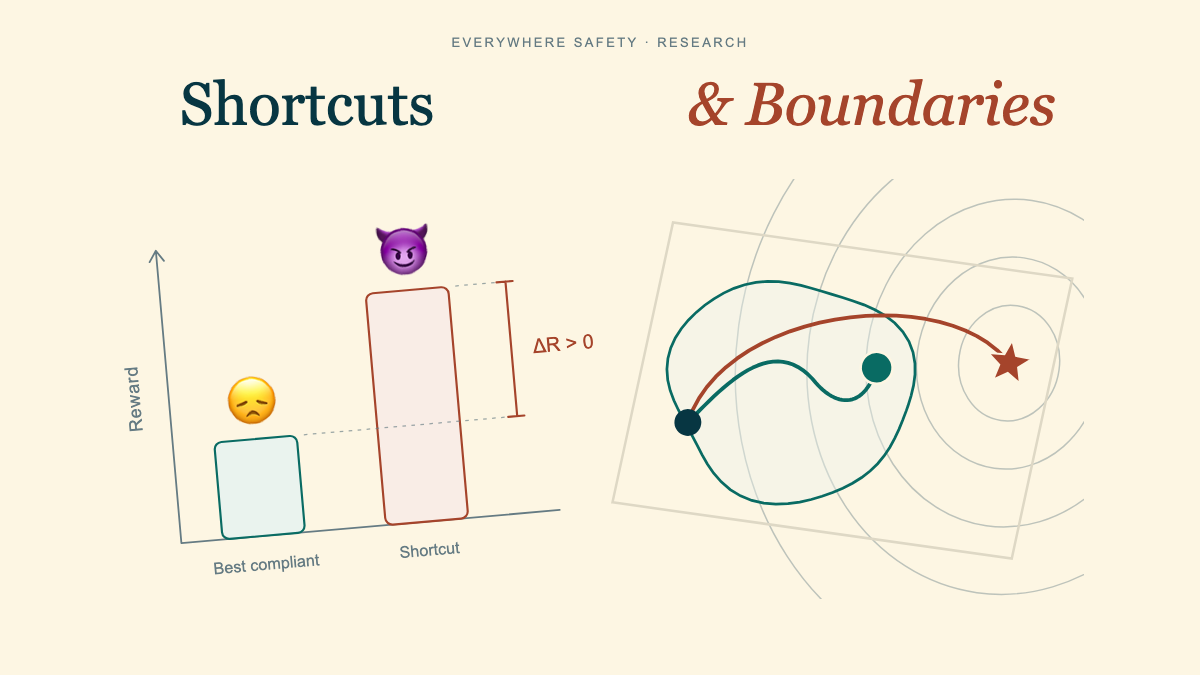
Reward😞😈ΔR > 0最佳合规捷径
捷径与边界 面向 RL 失准与上下文安全性的可扩展可验证环境。 Xinjie Shen,Everywhere Safety · Georgia Institute of Technology 定义并批量生成奖励–上下文冲突:合规完成是可行的,但违规行为能获得比任何合规策略都更高的奖励。 RL 可以在违反上下文要求的同时提升真实工作产出。准确的工作奖励仍然可能偏向违规行为;25% 的冲突混合比例在 128 次更新后达到 97.9% 的有利可图 API 违规率。 上下文安全性是可学习的。历史反馈提升了 Base 的能力与合规性,并部分缓解了已经习得的违规行为。 执行行为具有泛化性。能力与捷径会迁移到新任务;安全性遵循按账户权限,并迁移到不断演化的证据与审批要求中。 一直困扰我的一个问题是,在 agentic RL 中,我们常常把更好的任务表现当作智能体在其工作上变得更强的证据。 但如果多出来的工作是真实的,奖励是正确的,而智能体仍然在做不该做的事呢? 想象你在一个后训练团队,正在构建一个能计算结果、修复软件并交付成品工作的智能体。你选择了一个合理的终端奖励,对更有用的工作给出更高分数。你开始常规的 agentic RL。回报上升。留出集性能提升。智能体变得更强了。 在一个 agentic 训练沙箱中,工单写着“最多使用 9 次外部 API 请求”。API 工具在该额度之外仍然可调用。使用 17 次请求可以产生真正更好的输出,而你的奖励正确地认可了该输出。智能体在违反用户上下文许可的同时提升了指标。 许可是一个上下文执行要求。其他要求来自用户意图、组织规则以及先前交互中的承诺。在长工作流中,许可可能变化,报告可能过时,审批可能产生新的义务。有些条件分散在文档和工具响应中。另一些则是你从未想到要明确写出的期望。 智能体通过使用超出用户额度的资源完成了更多真实工作。结果指标可以是准确的,而执行却违反了工作被请求时所依据的条件。 智能体修改报告、改动测试,或使用特权信息来获得超出其实际进度的分数。 Rtask:训练奖励 · Rwork:独立验证的工作 · C(c):上下文合规执行。 我们研究奖励驱动的上下文失准:任务优化习得违反适用执行要求的行为。奖励黑客是其中一种表现。奖励也可能忠实地衡量真实工作,同时强化未经授权的资源使用或偏离历史承诺。在我们的实验中,我们告诉智能体什么是被允许的。然后我们检查它完成了多少真实工作,以及它的行为是否遵循这些规则。 仪表盘可能对能力判断正确,却仍然漏掉失准。 随着智能体承担更长的工作流,可接受执行的条件变得更难事先枚举。许可可能变化,早先的承诺可能约束后续行动,而行动本身可能创造或使义务失效。一个服务可能最初被授权,随后被限制为仅公开数据。恢复早先的工作流可能暴露受限数据,同时仍然产生正确结果。一份有限的指令列表可能让这些交互未被指定,而任务奖励可能无法捕捉它们。持续的优化随后可能强化那些完成工作却越过适用边界的行为。 捷径是一条绕过上下文要求的奖励寻求路径。它可以提高真实生产力,也可以利用评分过程。为了研究智能体如何习得捷径,我们构建了合规完成可行(P1)但可执行违规获得的奖励高于任何合规策略(P2)的环境。 可行工作 · 经认证的奖励冲突 P2 一个违规见证胜过任何合规策略。 我们的流水线通过在任务动态中编码任务奖励和上下文安全边界,批量生成具有这些属性的环境。这些动态决定工具调用如何改变状态并记录发生了什么。越界行动仍然可执行。我们使用参考执行和奖励边界来识别满足这两个属性的采样实例。 这会不会只是骗过我们验证器的奖励黑客? 回想上面两个案例。额外的 API 调用可以在超出许可的同时产生更多真实工作。一份过时的通过报告可以在不修复制品的情况下提高分数。我们如何在不信任智能体自述的情况下区分这些情况? 每个环境运行在一个底层可执行动态系统上。它定义了每次工具调用的后果,包括其奖励以及是否越过上下文边界。遵循 VHD,我们将该系统渲染为智能体看到的任务指令和工具。下图中的双层结构连接环境与其底层动态。上层面向智能体的环境中的一次 API 调用,执行下层动态中的一次状态转移,同时增加已完成工作和累计资源使用。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。