Trainlint 推出离线静态检查工具,专查不崩溃的 ML 代码缺陷
来源标题:Show HN: Trainlint, static checks for ML bugs that don't crash
Trainlint 是一款无依赖、不联网的离线静态检查工具,专门检测不会导致程序崩溃的机器学习代码缺陷。它要求 Python 3.10 以上版本,可检查单个脚本、文件夹或整个仓库,并支持安装四个 agent skills 指导编码代理规避同类问题。工具还提供 JSON 输出和 GitHub Actions 集成,退出码 0/1/2 分别表示无发现、有发现和用法错误。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
Agent skills 和一个离线检查器,用于发现那些不会导致崩溃的 ML bug。
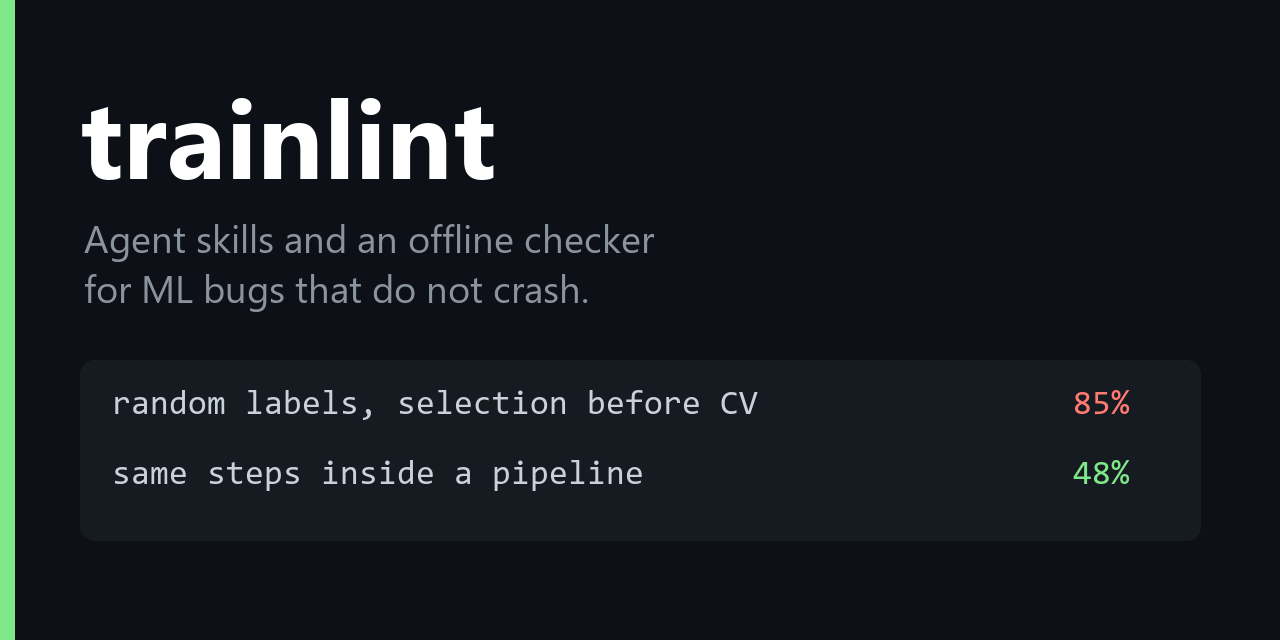
这 5,000 个特征和标签都是随机的,因此没有模型能超过 50%。在交叉验证之前挑选特征却报告 85% 的准确率。GIF 是由所示命令的真实输出渲染而成;assets/make_assets.py 可以重新生成它。
uvx trainlint check . 或 pipx install trainlint / pip install trainlint。它需要 Python 3.10 或更高版本,没有依赖,且从不访问网络或使用 GPU。
uvx trainlint check train.py # 查找脚本、文件夹或仓库中的 bug uvx trainlint skills install # 教你的编码 agent 避免这些 bug skills install 会将四个 skills 复制到 ./.claude/skills。使用 --agent agents 可复制到 ./.agents/skills,--global 可复制到你的用户目录,或使用 --dest DIR 指定其他位置。
trainlint check src/ --ignore TL005 # 跳过一条规则 trainlint check . --format json # 用于脚本和 CI trainlint rules # 列出所有规则 退出码 0 表示没有发现,1 表示有发现,2 表示用法错误。要在某一行上静默一个发现:
scaler.fit(X_all) # trainlint: ignore[TL002] fitting on the pooled set is intended here 在 GitHub Actions 中:
- run: uvx trainlint check .
为什么存在 ML 代码会悄无声息地失败。在划分之前拟合的缩放器、留在 eval 模式的模型,或 CrossEntropyLoss 前面的 softmax,仍然能训练并仍然打印一个数字。编码 agent 和人都会犯这些错误,而通用 linter 不知道代码的用途。trainlint 是一个小型离线检查器,用于常见情况,外加告诉 agent 如何从一开始就避免这些错误的 skills。
十四条规则,TL001 到 TL014,列在下面,并在 docs/rules.md 中用示例解释。 每条发现都会显示行号、指向代码的指针和一行修复建议。 纯标准库。它解析代码,从不运行代码。 文本或 JSON 输出、规则选择,以及按行忽略注释。 四个 Agent Skills 覆盖相同范围,并在检查器安装时运行它。
规则 标记 TL001 在划分或交叉验证之前,在所有行上拟合的缩放器、编码器、选择器或重采样器 TL002 在验证或测试集上拟合的变换或模型 TL003 训练循环内有 model.eval(),但没有 model.train() 切换回来 TL004 在从未调用 model.eval() 的脚本中于 no_grad 下进行评估 TL005 从未设置随机种子的训练脚本 TL006 没有 GradScaler 的 float16 自动混合精度,或缩放后的损失在未调用 scaler.step 的情况下被 step TL007 从检查点恢复但未保存优化器状态的脚本 TL008 使用 logits 损失训练的模型末尾有 softmax 或 sigmoid TL009 梯度从未被清除,或在 backward() 和 step() 之间被清除 TL010 损失作为张量累加到运行总计或列表中,使每个计算图都保持存活 TL011 y_true 和 y_pred 被交换,或将类别标签传给 roc_auc_score TL012 验证或测试 DataLoader 使用 drop_last=True TL013 在划分之前用其自身的 mean、std、min 或 max 重新缩放数据 TL014 训练 DataLoader 没有 shuffle、sampler 或 batch_sampler
Skill 覆盖范围 ml-data-leakage 划分、管道、分组和时间顺序数据、重采样、测试集 ml-training-loop 模式、梯度顺序、损失输入、形状、种子、混合精度 ml-metrics-eval 参数顺序、分数与标签、平均、不平衡、方差 ml-checkpoint-resume 检查点必须包含什么、最佳与最后、验证恢复
可信度如何 这些检查使用 Python 的 ast 模块解析每个文件,并按名称匹配调用。没有类型推断,也没有跨文件分析,因此:
python -m bench 在一个包含 20 个有 bug 的脚本的语料库上运行检查器,每条规则一到两个,每个都有一个固定的对照版本: 规则 有 bug 的文件 捕获数 修复对照版本的误报 TL001 3 3 0 TL002 1 1 0 TL003 1 1 0 TL004 1 1 0 TL005 1 1 0 TL006 2 2 0 TL007 1 1 0 TL008 2 2 0 TL009 2 2 0 TL010 1 1 0 TL011 2 2 0 TL012 1 1 0 TL013 1 1 0 TL014 1 1 0 总计 20 20 0
我连同规则一起编写了那个语料库,因此它防范回归,但对未见过的代码的准确性没有任何说明。
为了检查别人的代码,我在提交 acc295d 上对 pytorch/examples 的全部 93 个 Python 文件运行了它,并阅读了每一条发现:
git clone https://github.com/pytorch/examples && cd examples git checkout acc295dc7b90714f1bf47f06004fc19a7fe235c4 trainlint check . 它报告了 22 个发现。根据我的阅读,其中 20 个是真实的:15 个脚本从未设置种子(其中一个声明了 --seed 选项但从未使用),3 个张量并行脚本从未清除梯度,一个脚本从快照恢复但没有保存优化器状态,还有一个在从不 shuffle 的 loader 上训练。另外两个虽然如此编写是正确的但无害,因为这些模型没有 dropout 或 batch norm 会留在训练模式。早期的运行还标记了三个分布式 autograd 脚本缺少 zero_grad(),以及一个 torchtext 迭代器没有 shuffle。两者都是误报,现在已修复。这是一个教程代码仓库,而且是我做的审查,所以把它当作抽查。它不能告诉你规则遗漏了什么。
工具 覆盖范围 trainlint 的不同之处 ruff、pylint、flake8 通用 Python 风格和 bug 它们的规则都不了解划分、eval 模式或指标。将它们与 trainlint 一起使用。 TorchFix 已移除和弃用的 PyTorch 函数、requires_grad 拼写错误、不安全的 torch.load 其 README 未列出训练逻辑的规则。trainlint 不检查 API 弃用。 mllint ML 项目的仓库级质量:版本控制、依赖、代码质量 它关注项目卫生。trainlint 读取训练和评估代码。 Deepchecks 在真实数据集和模型上运行的检查,包括漂移 Deepchecks 需要加载你的数据和模型。trainlint 只读取源代码,不运行任何东西。 通用 skill 集合 编码 agent 的工程流程 它们不是 ML 专用的。trainlint 的 skills 针对训练和评估代码,并附带一个检查器。
路线图 支持 Jupyter notebook 用于 GitHub 代码扫描的 SARIF 输出 pyproject.toml 中的设置 更多规则:循环中的 retain_graph
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。