Claude Fable 5.1 重写单个权重矩阵,使0.8B模型分类准确率翻倍
来源标题:We rewrote one weight matrix to teach a 0.8B model conversation classification
Claude Fable 5.1 通过闭式解重写 Qwen3.5-0.8B 的一个权重矩阵,在无需微调的情况下将该模型客服对话分类准确率从 0.41 提升至 0.83。整个过程没有梯度步骤、适配器或新增参数,仅通过测量模型自身激活值完成修改,在留出对话集上验证了效果。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
研究|我们重写了一个权重矩阵,让一个0.8B模型学会对话分类
navigateopenescclose 任务 数据 模型内部 改动 结果 结论 研究2026年11月6日 · 9分钟阅读 作者:Esha Dinne,创始人兼CTO;Arnab Maiti,研究工程师 3,5841,024dWW,第24层第1层3,5841,024dWW,第24层第1层
Claude Fable 5.1拿来了Qwen3.5-0.8B——一个小型开放模型——在没有微调的情况下,把它在某个分类任务上的准确率翻了一倍:没有梯度步骤,没有适配器,没有新增参数。Fable测量了模型自身的激活值,并以闭式解重写了一个权重矩阵。在留出对话上的准确率从0.41提升到了0.83。
Fable的任务是把客户支持对话分类到预定义场景中。例如,如果客户联系零售商要退回购买的商品,模型应将该对话分类为“退货请求”。如果客户在询问包裹的下落,正确标签则是“订单状态与配送追踪”。
系统提示提供了一份场景名称列表,每个名称附有一行描述,随后是对话记录。模型必须识别出最符合客户意图的场景,并给出其准确名称。
该任务涵盖五个领域:零售、电信、银行、航空和SaaS,每个领域12个场景(共60个)。我们同时考虑了不同长度的语音风格和聊天记录,以及一些具有挑战性的案例——在这些案例中,客户真实的意图直到对话后段才变得清晰。
我们使用了一个包含3,600段对话的合成数据集,每段对话标注一个场景,并按三种方式划分:
快速回顾一下模型如何生成答案。提示被切分为token。对于每个token位置,模型维护一个包含1,024个数字的向量,它的24层中的每一层都会读取该向量并对其添加一些内容。在提示的最后一个位置,从第24层输出的向量会经过最终归一化和unembedding矩阵,从而为词汇表中的每个token给出一个分数。得分最高的token就是答案的第一个token,因此对于这个任务,模型的答案就是12个列出的场景名称中得分最高的那个。
第1至24层(每层包含注意力+MLP)最终向量:1,024个数字最终归一化和unembedding输出词,例如Return request模型自己的答案:41%正确提示:场景列表、对话记录,然后是“Category:”第1至24层(每层包含注意力+MLP)最终向量:1,024个数字最终归一化和unembedding输出词,例如Return request模型自己的答案:41%正确
模型如何生成答案。基础模型的准确率为41%。
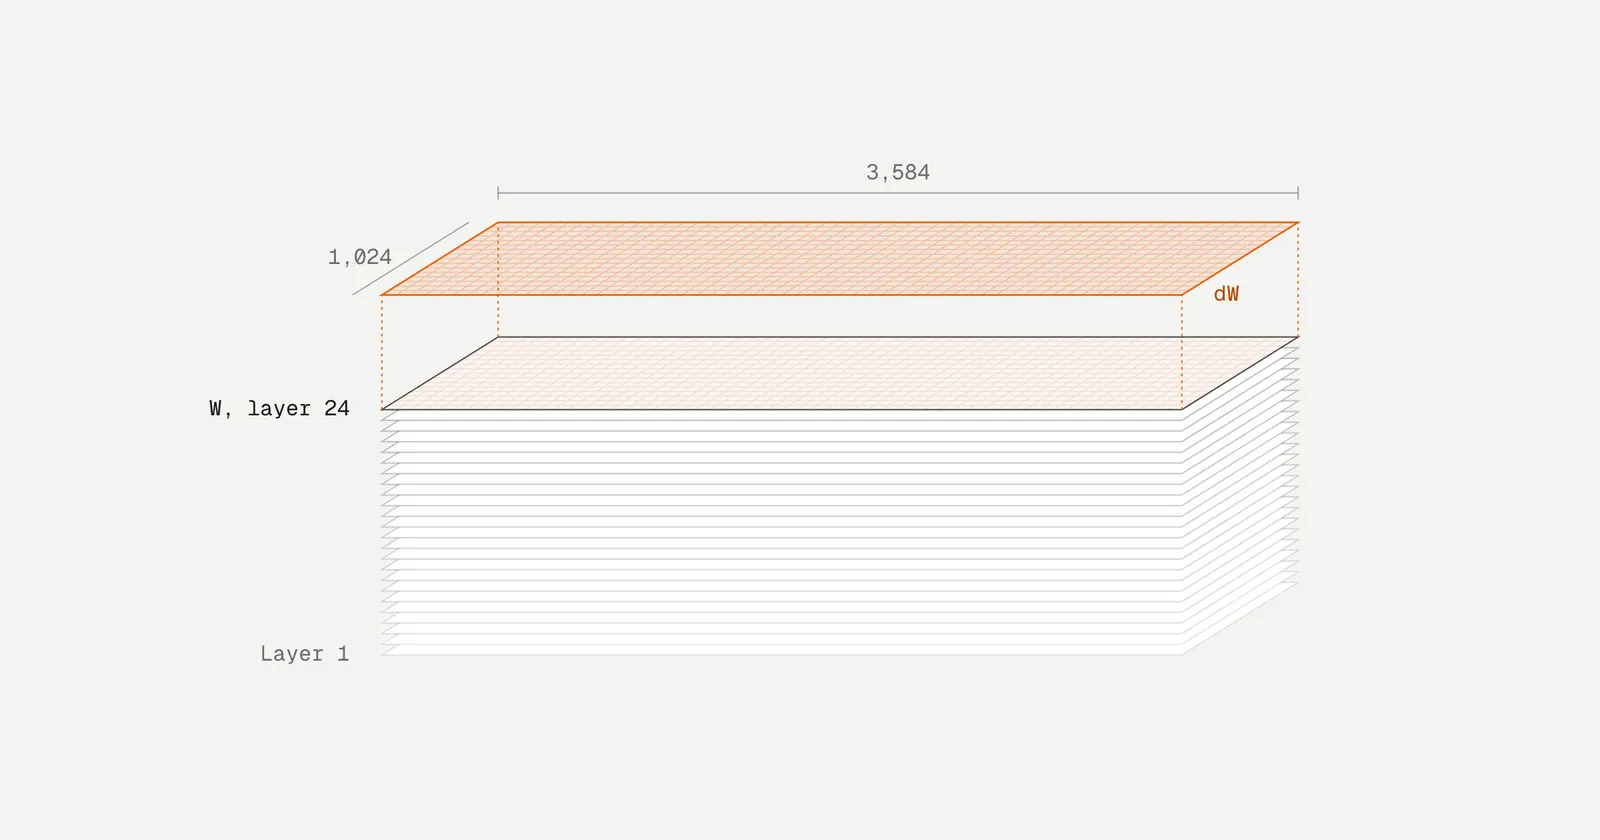
第1步:记录模型计算了什么。Fable在1,800段拟合对话上运行了未经改动的模型。在每段对话的答案位置,它保存了每一层输出的向量(每段对话24个向量)以及最后一层MLP的3,584个隐藏激活值——也就是下投影矩阵所乘的那些数字。
第2步:检查场景是否已经存在于这些向量中。为此,Fable构建了一个最近原型探针。原型就是某个场景的平均向量。取出标注为“退货请求”的30段拟合对话,取它们各自在第24层之后产生的向量,对这30个向量求平均。结果是一个单一向量,代表了“退货请求”对话在该层模型内部通常的样子。对该领域其他11个场景做同样处理,就得到12个原型。要分类一段探针从未见过的对话,取它在同一层之后的向量,测量它到12个原型中每一个的距离,然后以最近的那个作为答案。整个过程没有任何训练:探针仅由12个平均值构成,别无其他。
第1至13层第14至24层最终向量输出词模型自己的答案:41%正确Claude Fable 5.1在每一层之后探测向量:将每个场景的30个拟合向量平均为一个原型,按最近原型为验证对话打标签低于60%正确高于70%正确(第19层79%,第24层75%)提示第1至13层第14至24层最终向量输出词模型自己的答案:41%正确Claude Fable 5.1在每一层之后探测向量:将每个场景的30个拟合向量平均为一个原型,按最近原型为验证对话打标签低于60%正确高于70%正确(第19层79%,第24层75%)
Fable用最近原型读出方式探测模型。从第14层开始场景就可读,但模型自己的答案只有41%的正确率。
探针显示了什么。在600段验证对话上,使用第24层之后的向量,探针的准确率为75%;使用第19层之后的向量,准确率为79%。而模型自己的答案——由完全相同的第24层向量计算而来——准确率只有41%。
第3步:定位故障。模型已经算出了场景,这一知识仍存在于它的最终向量中。出问题的是最后一步——把最终向量转换为场景名称的那一步:它在每个领域都偏向少数几个名称。例如,在航空测试对话中,基础模型240个答案里有184个是“航班被航空公司取消”或“航班变更或改签”,尽管12个场景每个只出现了20次。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。