Ellf 推出虚拟 NLP 工程师,帮企业自建私有 AI 模型
来源标题:Ellf · Your virtual NLP engineer for agentic development
Ellf 发布虚拟 NLP 工程师,帮助团队在内部构建定制且完全私有的 AI 方案。它可把业务问题拆成可执行步骤,借助 LLM 蒸馏出更小更快的任务专用组件,并覆盖数据准备、模型训练与评测等环节。目标是让团队摆脱对又慢又贵的 LLM API 的依赖,同时保证数据隐私。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
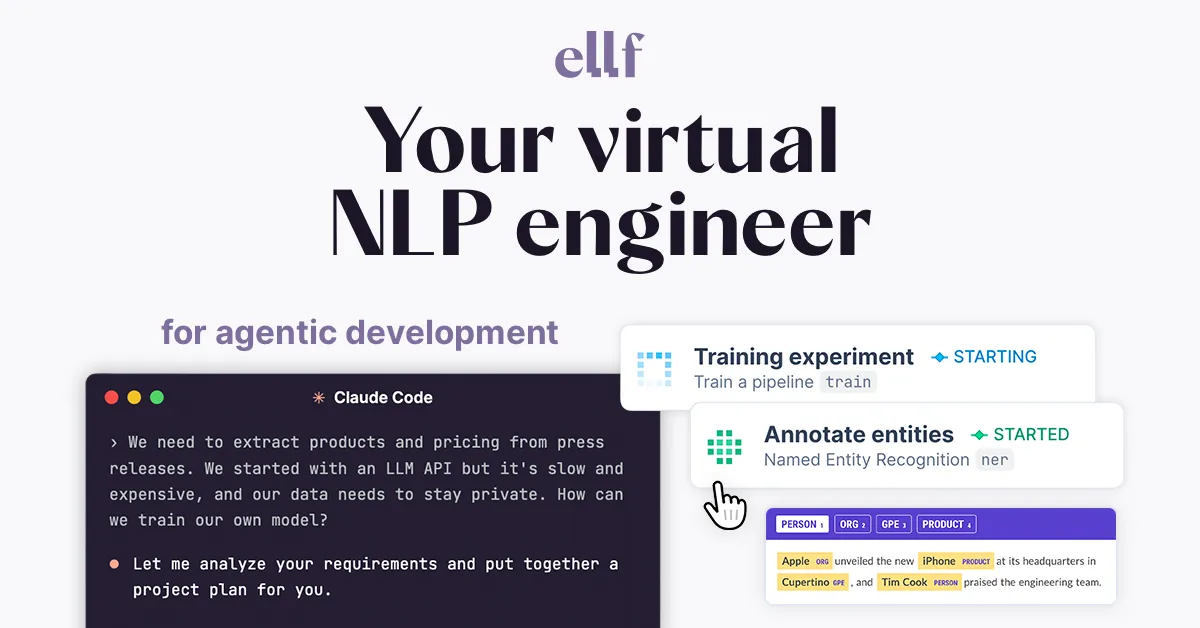
你大概已经听过 vibe coding 了——现在来认识一下 vibe NLP。借助 Ellf,你的团队可以重新掌控主动权,在内部构建定制化、完全私有的 AI 解决方案。 阅读文档 ✳︎Claude Code › 我们需要从客服工单中提取产品和功能信息。我们一开始用了 LLM API,但它又慢又贵,而且我们的数据必须保持私有。我们怎样才能训练自己的模型? ⏺︎让我分析一下你的需求,然后为你制定一份项目计划。 项目规划 把你的业务问题拆解成可执行的步骤。 蒸馏 用 LLM 打造更好、更小、更快且完全私有的任务专用组件。 模型训练与分析 训练并微调任务专用模型,分析日志并诊断问题。 数据准备与探索 转换原始数据、对信息进行聚类,并针对你的任务反复迭代标签方案。 数据开发 协作进行标注,并用 agent 自动化数据标注。 标注指南 编写全面的标注手册,以扩大数据创建流程的规模。 模式生成 用基于规则的逻辑确定要提取什么,并以交互方式创建模式。 QA 与评估 用真实数据和合成数据测试你的系统。 编码辅助 用 spaCy、Prodigy 和强大的 Python 生态构建定制解决方案。 Ellf 能与你选择的编码助手无缝集成,让它擅长解决 NLP 问题并执行端到端的机器学习项目。 cluster.example.com 训练实验STARTING 训练一个流水线train 标注实体STARTED 命名实体识别ner 让你的数据保持私有 标注、训练等操作由你在本地或自己的云中运行的数据私有集群驱动,100% 由你掌控。 Re: 你的 Ellf 支持请求 获取人工支持 如果你遇到困难或需要第二意见,把日志发给我们,由我们的 NLP 专家审阅——直接在你的编码助手里完成。 构建软件主要是一个代码问题,但构建 NLP 系统是一个代码加数据的问题。开箱即用的编码助手在三个方面存在不足——Ellf 为它们补上缺失的部分。 标注:一种低摩擦的方式,让你从真实数据中获得人类反馈,并“把工作安排给人类”。 执行:在私有集群上运行长时间任务和实验,无需自己搭建基础设施。 知识:来自 10 多年解决业界真实 NLP 问题的最佳实践。 阅读博客文章 面向 Prodigy 用户的 Ellf 已经在使用 Prodigy 标注工具了?以下是如何扩大规模、自动化并大幅提升你的标注效率。 用 Ellf 协作开展研究和实验,并加速和自动化开发与数据收集。 与其凭感觉,不如清楚地了解什么有效,为流水线的每个环节建立稳健的评估,并用更小、更快、更私有的组件取代昂贵的 LLM 调用。 ✳︎Claude Code › 我想评估我们的客服工单流水线。你能设置一个任务,让我们的团队和一个 agent 标注一个样本,并把路由和提取步骤与数据做对比吗? ⏺︎当然!让我为每个组件设置标注任务和评估工作流。 蒸馏大模型STARTING 人在回路蒸馏distill 工单路由 94% 信息提取 78% 从模板开始 模板打包了完整的端到端工作流,这样你就不必从零开始。把你的编码 agent 指向一个模板,让它适配你的用例和数据,然后按下运行,或者导出你自己的项目与团队分享。 ✳︎Claude Code › /ellf-template 使用示例数据设置这个项目:https://github.com/explosion/ellf-templates/tree/main/llm-to-jev ⏺︎我已阅读该模板的 README。让我设置项目、任务和评估工作流。 用 Jev 替换 LLM 分类器 文本分类评估 2 个任务3 个操作1 个 agent1 个计划 github.com/explosion/ellf-templates/tree/main/llm-to-jev 用 Claude Code 和 agent 构建定制 NLP 如何从一个 LLM 原型,走到一个能在生产环境中运行的快速、低成本且完全私有的 NLP 组件?在本视频中,Ines 将向你展示 Ellf 如何帮助 Claude Code 这类编码 agent 构建定制 NLP 模型,用于分析进来的客服工单。 常见问题 还有其他这里没有覆盖的问题?给我们发邮件! Ellf 的模块覆盖 NLP 开发流程的方方面面,包括项目规划与建议、数据准备与标注、机器学习与基于规则的逻辑,以及模型训练与评估。结合你的 AI 编码助手(如 Claude Code 或 Codex),它可以为你构建端到端 NLP 流水线、评估并优化你现有的应用,并开发出准确、快速且完全由你掌控的独立 AI 系统。 Ellf 平台让你运行并监控标注任务、训练和评估等流程,以及全自动化的 agent,由你在本地或云端运行的自有数据私有集群驱动。数据标注工作流使用我们广受欢迎的标注工具 Prodigy,覆盖所有常见的 NLP 任务,如命名实体识别、片段分类、文本分类和关系抽取,以及使用 PDF、图像、音频或视频的工作流。 Ellf 能与 Claude Code、Codex、GitHub Copilot、Junie 或 OpenCode 等 AI 辅助编码工具无缝集成。安装后,它提供技能和知识,解锁新的能力,让你的编码助手擅长规划和执行 NLP 项目。这是使用 Ellf 最高效的方式,意味着你可以照常工作,只是多了一层 NLP 超能力。 你可以将 Ellf 与任何 AI 提供商、LLM API 或本地模型搭配使用。只要你能用 Python 做到,你就能在 Ellf 中使用它!内置工作流包括与 OpenAI、Google Gemini 和 TypeSafe 等流行 API 提供商的集成,以及通过 Hugging Face 和 spaCy 使用本地模型。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。