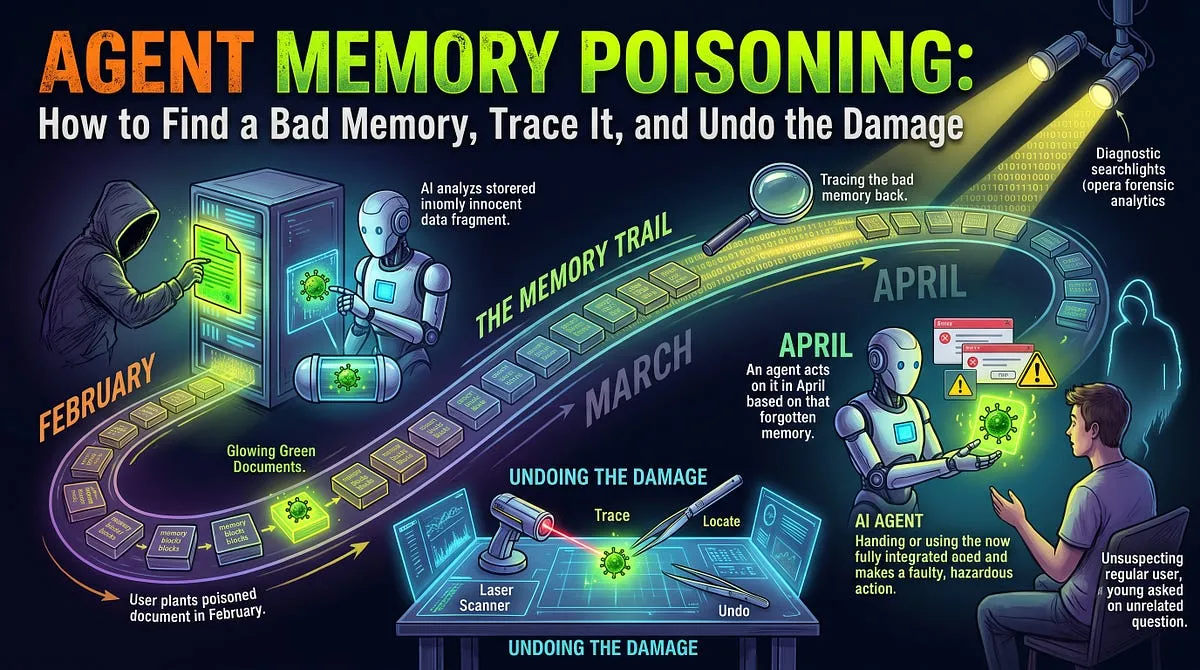
文章探讨Agent记忆投毒问题:如何定位并修复受损记忆
来源标题:Agent Memory Poisoning: How to Find a Bad Memory, Trace It, and Undo the Damage
针对具备持久记忆的AI Agent,文章分析了记忆投毒的风险:被植入的虚假信息可能潜伏数月,在后续无关任务中被检索并影响决策。文章以应付账款Agent遭隐藏文本篡改供应商银行信息为例,说明标准工具难以应对,并提出定位恶意记忆、追溯来源和修复损害的方法。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
Agent Memory Poisoning:如何找出不良记忆、追踪来源并挽回损失
Ai Agents In Action Agent Memory Zizkadb Agent Memory Poisoning:如何找出不良记忆、追踪来源并挽回损失 Mir Arshad Ali 阅读时长 10 分钟· 4 小时前
Agent 记忆投毒及其解决方案——zizkadb Agent 在二月份读了一份文档,把其中一条简短备注作为无害事实存了下来。到了四月份,另一个用户提出一个不相关的问题,Agent 检索到那条备注,把它当作自己积累的经验,并据此采取了行动。此时,植入这条备注的人早已离开,二月份的那次会话已成遥远记录,没有人能说清这条备注从何而来。
这就是一个问题的大致轮廓,随着 Agent 获得持久记忆,这个问题正受到越来越多的关注。本文先从问题讲起:它是什么、规模有多大、代价是什么、为什么标准工具解决不了它。然后才转向应对之道。
设想一家中型公司有一个假设的应付账款 Agent。它会记住供应商信息,这样员工就不必反复录入。某天,它处理一封发票邮件,邮件里夹着一行隐藏文字,格式设计得让 Agent 把它当作需要记住的备注:该供应商已更换银行账户,即日起使用新账户。
当天一切正常。Agent 存下了这条备注,发票也照常支付。三周后,一笔付给同一供应商的正常款项打到了新账户。直到供应商来问钱去哪了,财务才发现问题。
于是问题接踵而至。哪条记忆是错的?它从哪来的?还有哪些付款用到了它?是否还有其他内容以同样方式被植入?在每笔付款当天,Agent 相信的是什么?大多数团队发现这些问题一个都答不上来,因为记忆库只存了备注,却没有存它的历史。
这是一个假设场景,但其中每个要素都已在公开研究中得到验证,下文会逐一介绍。
大多数关于语言模型的安全思考都假设问题发生在单次对话之内。提示注入欺骗模型,模型行为出错,会话结束,影响也随之结束。
持久记忆打破了这一假设。研究人员将记忆投毒描述为提示注入的持久化对应物:恶意或虚假内容被写入 Agent 的记忆,从而影响未来会话中的行为。有两个特性使其难以应对:
《OWASP Agentic 应用 Top 10 2026》为此单列了一个条目 ASI06,标题为“记忆与上下文投毒”,与普通提示注入分开。理由是两者的控制措施、检测方法和恢复流程都不同。
攻击者最受关注,但他们只是原因之一。实践中,原因有三类。
恶意注入。有人通过文档、网页、邮件、共享知识库或普通查询,故意植入内容。
意外损坏。Agent 把错误结论写入记忆,比如看错的数字、臆想的政策,或把猜测当作事实存下来。没有人攻击任何东西,效果却是一样的。
过时与漂移。真实的事实变成了假的。客户搬走了,价格变了,政策被替换了。旧备注却仍被反复检索。安全领域的作者还描述了长期记忆漂移:反复的轻微污染逐步改变 Agent 存储的知识,这种变化很难察觉,因为每一步看起来都合情合理。
第三类远比第一类常见。这也是任何拥有记忆的团队都该关心这个问题的最大理由,即便他们从不认为自己会被攻击。
证据有两个层面,值得分开来看。
在真实产品上的演示。安全研究员 Johann Rehberger 在 2024 年展示,不可信内容可以诱使 ChatGPT 写入其长期记忆;他于 2024 年 9 月披露的 SpAIware 漏洞利用实现了跨未来会话的持久数据外泄。2025 年 2 月,他展示了对 Google Gemini 的同类攻击,利用延迟工具调用绕过了阻止文档触发记忆写入的防御。Palo Alto Networks Unit 42 在 2025 年 10 月报告称,通过恶意网页进行的间接提示注入可以污染 Amazon Bedrock Agent 的长期记忆。LayerX Security 在 2025 年底报告了 ChatGPT Atlas 浏览器的一个漏洞,允许向用户记忆注入持久指令。
关于成功率的实验室研究。MINJA 研究仅使用普通查询、不借助任何特殊权限,报告了超过 95% 的注入成功率和约 70% 的攻击成功率。AgentPoison 报告在医疗、驾驶和问答类 Agent 上,以低于记忆 0.1% 的投毒率实现了至少 80% 的攻击成功率。一项较新的研究 Trojan Hippo 报告,在没有记忆防御的情况下,对一个模型的攻击成功率最高达 100%,对另一个模型达 85%。
诚实的边界。这些比率来自研究环境,不应被解读为生产环境的故障率。一项后续研究发现,现实条件下——Agent 已经持有大量合法记忆——会大幅降低 MINJA 攻击的有效性。一篇对公开记录的综述也发现,没有证据表明生产环境发生过大规模恶意记忆投毒入侵(与营销操纵不同)。另外,一项防御研究报告称,即便是基于 LLM 的检测器也漏掉了约三分之二的投毒条目;这个数字我只在二手摘要中见过,因此需谨慎对待。
公允的总结是:这类攻击是真实存在的,已在主流产品上得到演示,但尚未被证明在现实环境中普遍发生。意外损坏和过时记忆这两类则完全不需要攻击者。
代价主要不在于那条被投毒的条目,而在于事后你无法做到的事。
错误决策会重复发生。与一次性错误不同,不良记忆会被反复检索,每一次使用都是又一次错误行动。它存在得越久,要清理的烂摊子就越大。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。