Ai2发布XYBench基准,测试AI助手能否识别用户问题背后的真实需求
来源标题:XYBench: Helping with the problem behind the question
Ai2推出XYBench基准,用8K+个基于用户错误认知的问题测试AI助手能否识别问题背后的真实目标(即XY问题)。该基准在EMNLP 2026上获得最佳资源论文奖,并同步公开了论文、数据和代码。XYBench旨在评估AI助手能否帮助提出误导性问题的用户,而非仅服务提问正确的用户。
以下正文由 AI 翻译自 Hugging Face Blog(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
XYBench:帮助解决“问题背后的问题”
返回文章列表
XYBench:帮助解决“问题背后的问题” 企业文章 已发布 2026年11月13日 点赞 - Kyle Wiggers Ai2Comms 关注 allenai
构建 XYBench 评估答案的帮助程度 实验结果说明了什么 这对评估意味着什么
📄 论文 | 🤗 数据 | 💻 代码
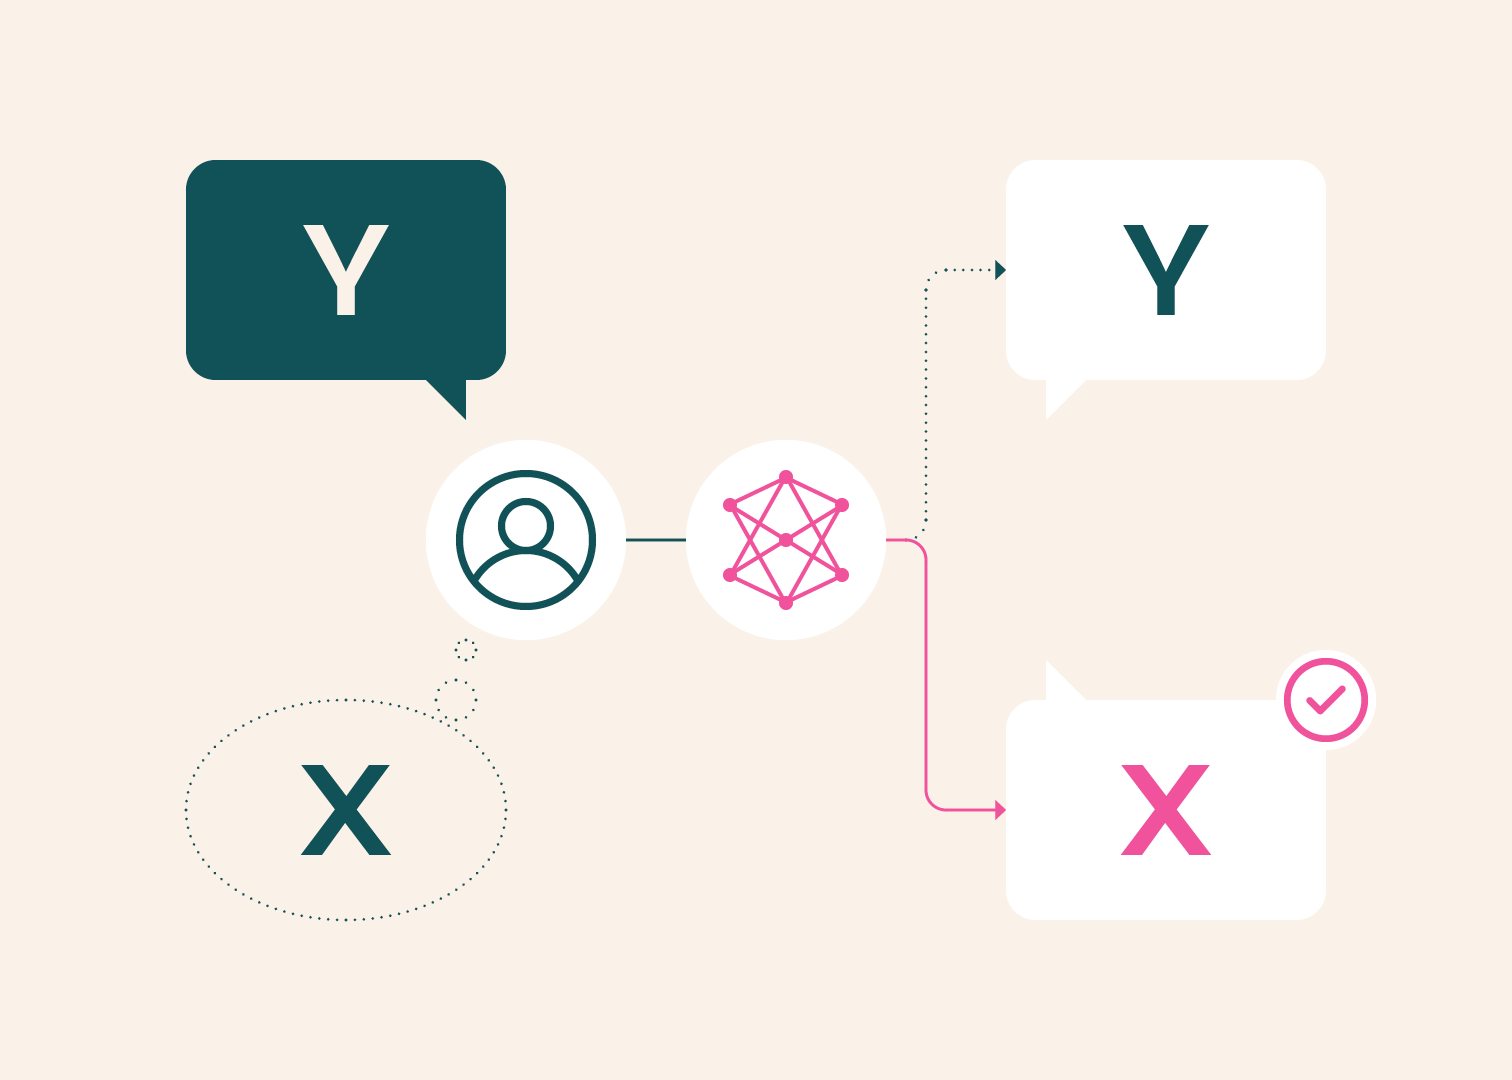
真正有用的 AI 助手需要能够帮助那些提出错误问题的用户——而不仅仅是那些问题正确、细节恰当的用户。我们发布 XYBench,这是一个包含 8K+ 问题的基准测试,用于检验 AI 助手如何回应用户基于错误认知提出的请求,例如有人问如何让总是从纸杯蛋糕上滑落的糖霜变稠,而真正的问题是纸杯蛋糕本身还太热,不适合涂抹糖霜。XYBench 在 EMNLP 2026 上获得了最佳资源论文奖。
一个人所询问的方法与其想要达成的目标之间的不匹配,被称为 XY 问题:一个人想要完成 X,假设某个特定方法 Y 会奏效,然后寻求关于 Y 的帮助。在纸杯蛋糕的例子中,这个人如此执着于让糖霜粘住,以至于没有考虑到纸杯蛋糕的温度才是真正需要解决的问题。
XYBench 由我们与 Carnegie Mellon、NVIDIA 和 Johns Hopkins 的研究人员共同开发,它揭示了 LLM 在排查问题能力上的一个关键缺口:识别用户的请求何时基于隐含的错误认知,并适当地将其引导向真正能解决其实际目标的方案。基于涵盖编程以及烹饪、家居维修等日常活动的 8,115 个真实问题,我们推出了一个基准测试,用于衡量模型是否能识别这些错误认知,并能在回答中优先给出有效的解决方案。
我们在 XYBench 上评估的模型——Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro——通常会针对用户的问题给出一个解决方案,但回答的重点仍然停留在原本错误的方法上。与人类参考答案不同,这五个模型都更不倾向于引导用户放弃该方法,转向适合其目标的解决方案。
人们在使用 AI 系统时知识水平各不相同,未必总是知道如何最好地处理一个问题。我们希望 XYBench 能帮助研究人员衡量模型改进是否让助手更善于识别错误的假设、解释所提出的方法为何可能行不通,并建议更有效的替代方案——即使用户并不知道该问什么正确的问题。
构建 XYBench
我们从四个来源构建了 XYBench:1,557 个来自 Stack Overflow 的问题、184 个来自 Stack Exchange 的问题、102 个手动整理的示例,以及 6,272 个由 WikiHow 指南生成的问题。对于每个问题,我们识别了表面请求(Y),即用户明确提出的内容,以及意图请求(X)——即可以从上下文推断出的底层目标。
对于公共论坛的问题,我们使用得分最高的三个人类回答以及(在可用的情况下)被采纳的答案来确定意图请求和可能的解决方案。我们过滤掉了那些回答表面请求即被视为足够的案例。对于 WikiHow,我们使用 Sonnet 4.5 围绕流程指南中可能存在的错误认知生成问题,然后对其进行细化,使其包含足够的上下文,让专家能够在不被明确告知的情况下推断出底层目标。我们移除了那些回答字面请求即可基本解决问题的示例。
评估答案的帮助程度
一个模型可能会花好几段推荐一款吸力更强的吸尘器,然后简短地建议检查软管是否堵塞。如果吸力弱是堵塞造成的,清理堵塞就能解决问题。
更有帮助的回答会认识到用户想要恢复吸力,并专注于诊断原因。这涉及语用学——语言学的分支,研究语境和交际意图如何塑造意义。为了检验模型是否在回答中运用了这种理解,XYBench 从三个方面衡量每个回答:
在 XYBench 中,Claude Sonnet 4.5 担任自动评判员。它对每个模型回答中的各个建议进行分类,并评估答案的语用侧重。
为验证 Sonnet 4.5 的评判,两位人类评审员独立评估了 500 个模型对 XYBench 问题的回答。评审员与评判员的平均一致率如下:解决方案是否出现为 97.5–100%,错误认知识别为 84.6–93.3%,语用侧重为 74.2–79.8%。
实验结果说明了什么
我们在单轮设置下于 XYBench 上评估了 Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro,每个问题对应一个回答。我们使用相同的指标单独评估了人类参考答案。
在所有四个来源中,每个模型都更可能在回答中包含针对表面请求(Y)的解决方案,而非针对底层目标(X)的解决方案。在 Stack Overflow 上,表面请求的解决方案出现在 75–86% 的回答中,而底层目标的解决方案为 59–71%。
仅仅顺带提一句某个解决方案,并不等于它就是回答的重点。在吸尘器的例子中,模型可能简短地建议清理软管,但把大部分回答的重点放在购买吸力更强的吸尘器上。我们会将这样的回答计为包含底层目标的解决方案,尽管模型强调的是表面请求。我们单独衡量了整体侧重:在 Stack Overflow 上,模型仅在 35–41% 的回答中主要侧重于底层目标,在 47–57% 的回答中主要侧重于表面请求。在其余回答中,模型对表面请求和底层目标的侧重程度相近。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。