告别 Kafka 中转,让实时数据更快服务业务分析 | 技术实践
2026 年,智能体将在企业级应用中取得哪些实质性突破?点击下载《2026 年 AI 与数据发展预测》白皮书,获悉专家一手前瞻,抢先拥抱新的工作方式!
以下正文同步自 InfoQ 中国,版权归原站所有,已转换为易读排版。
2026 年,智能体将在企业级应用中取得哪些实质性突破?点击下载《2026 年 AI 与数据发展预测》白皮书,获悉专家一手前瞻,抢先拥抱新的工作方式!
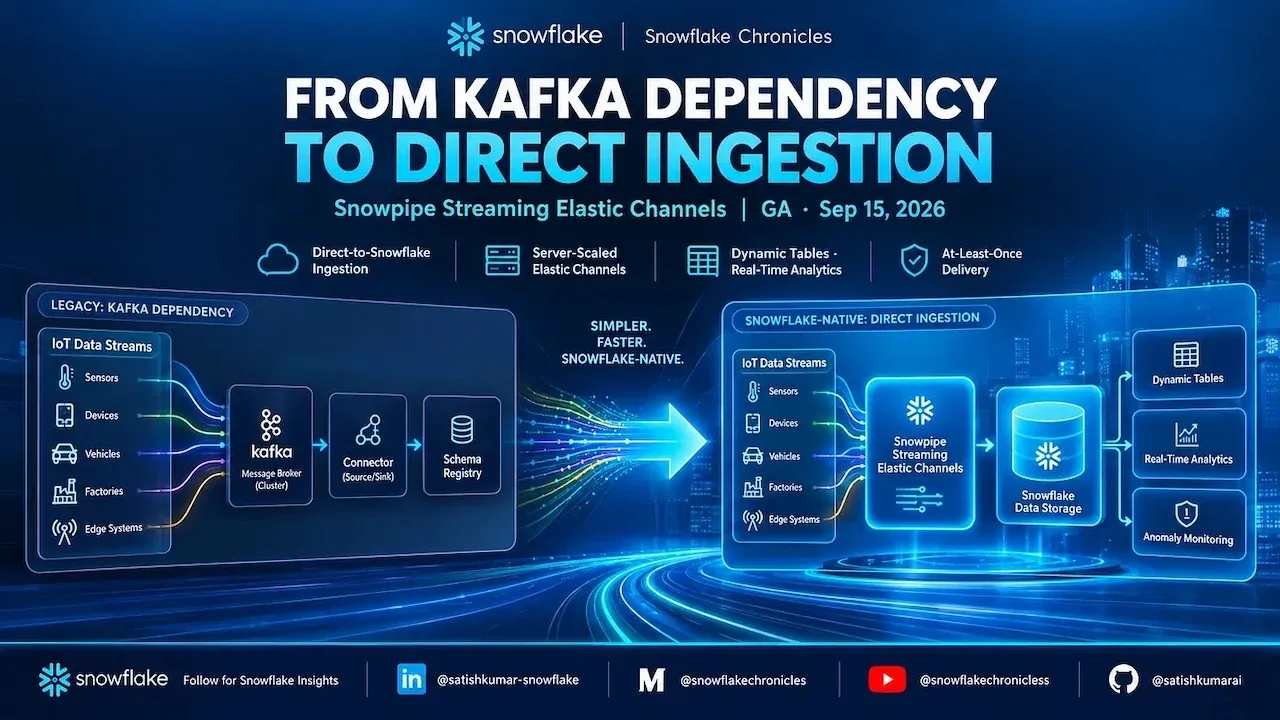
多年来,将流式数据写入 Snowflake 的默认架构几乎一直没变:应用生成事件,Kafka(或 Kinesis、Pub/Sub)负责缓冲,再由连接器将数据写入 Snowflake。消息总线的存在只是为了把数据落到目标位置。它不是为了将数据分发给多个下游,也不是为了重放数据或服务多个消费者,只是为了把数据行写进表里。
这种架构可行,但也有成本:需要运维 Kafka 集群、配置连接器、维护 Schema Registry,端到端延迟也通常以分钟而非秒计算。如果唯一的消费者是 Snowflake,那么消息总线就成了一项没有架构层面必要性的依赖。
Snowpipe Streaming Elastic Channels 移除了这项依赖。生产者通过一个隐式的、由服务器扩展的通道直接向 Snowflake 写入数据。应用无需管理通道的生命周期、偏移量或消息代理。SDK 负责批处理、压缩和重试,Snowflake 负责扩展。最终,架构更简单、组件更少、延迟更低,定价也与数据量挂钩,而非基础设施。
本文将介绍一套我从头到尾构建并验证的生产级实现:从创建 Snowflake 对象,到通过 MacBook 实时流式写入数据,再到使用 Dynamic Tables 实时转换数据,以及通过监控视图掌握运行状态。
架构上的变化很清晰:移除了三个组件(Kafka 集群、Schema Registry、连接器),新增了一个隐式组件(完全由 Snowflake 管理的 Elastic Channel)。信任边界也从用户自己的基础设施转移到了 Snowflake 的数据摄取服务。
Elastic Channels 于 2026 年 9 月 15 日正式发布。这一点很重要:它不是一个只能拿来做原型、还要担心未来是否会继续保留的预览功能,而是已达到生产级别,可在所有 AWS、Azure 和 GCP 商业区域使用,并受 Snowflake 标准服务等级协议(SLA)保障。
此次正式发布在架构层面的意义,不在于某一项单独的能力,而在于多项能力如何协同。每次追加操作都会获得持久化确认,生产者可以明确知道 Snowflake 何时开始负责保存数据。Java、Python 和 Node.js SDK 均支持即发即忘和可等待的追加方法,能够适配应用现有的并发模型。通过基于回调的结果跟踪与调用方提供的 token,生产者可以将已确认或失败的操作对应回源事件,无需额外维护外部记录。
需要牢记的一项实际限制是:它提供的是至少一次投递语义,而非恰好一次。Snowflake 做出了明确取舍:不保证顺序、不提供偏移量 token,也不需要协调通道;换来的是显著简化的生产者体验和自动的服务端扩展。如果数据管道无法容忍重复记录,可以像本文的实现一样,在下游通过 Dynamic Table 去重,也可以改用 Named Channels。所需 SDK 版本为 1.8.0 或更高版本。
Snowflake 中的流式管道有一个隐式的 ELASTIC 通道,多个生产者可以同时向其中追加数据。Snowflake 会将追加操作分配到由服务器管理的资源上,应用无需创建、命名、打开、关闭或恢复通道。
SDK 通过 get_elastic_channel() 获取通道句柄,并在数据到达时追加数据行。SDK 会在内部进行批处理;
Snowflake 持久化缓冲追加的数据,并返回持久化确认——Future 成功完成;
关键区别在于:确认意味着数据已持久化,不代表数据已经可查询。Future 返回后,生产者可以释放自己保留的数据副本;数据处理和查询可见性则会随后完成。
投递语义:至少一次,不保证顺序。如果生产者在一次结果不明确的失败后重试,目标表中可能会出现重复记录。因此,每一行都需要有稳定的事件标识符,以便在下游进行去重。
无需执行 DDL。本文的实现中没有 CREATE PIPE 或 CREATE CHANNEL 语句。当 SDK 调用 get_elastic_channel() 并追加第一行数据时,Snowflake 会自动创建一个名为 -STREAMING 的默认管道(在本文的示例中为 SENSOR_READINGS-STREAMING),并附带一个隐式 ELASTIC 通道。首次运行生产者后,可以通过以下命令验证:
SHOW PIPES IN SCHEMA SNOWPIPE_STREAMING_DEMO.STREAMING;-- Returns: SENSOR_READINGS-STREAMING (is_snowflake_managed = true)
复制代码
自动创建的管道包含 MATCH_BY_COLUMN_NAME=CASE_INSENSITIVE 和 CLUSTER_AT_INGEST_TIME=TRUE(由于目标表定义了聚簇键,这些属性会自动应用)。用户无法 ALTER 或 DROP 这个默认管道,它完全由 Snowflake 管理。
-- Role hierarchyCREATE ROLE IF NOT EXISTS STREAMING_ADMIN;CREATE ROLE IF NOT EXISTS STREAMING_PRODUCER;CREATE ROLE IF NOT EXISTS STREAMING_ANALYST;GRANT ROLE STREAMING_PRODUCER TO ROLE STREAMING_ADMIN;GRANT ROLE STREAMING_ANALYST TO ROLE STREAMING_ADMIN;GRANT ROLE STREAMING_ADMIN TO ROLE ACCOUNTADMIN;
复制代码
STREAMING_PRODUCER 角色仅获得 INSERT 权限,没有 SELECT、DELETE 或 DDL 权限。外部生产者通过密钥对认证使用这一角色。设计原则是:即便生产者凭证遭到泄露,攻击者也只能追加数据,无法读取或修改已有数据。
需要注意的是,如果像本文的实现一样,在目标表上启用 ENABLE_SCHEMA_EVOLUTION = TRUE,摄取数据的角色还需要拥有该表的 EVOLVE SCHEMA 或 OWNERSHIP 权限,自动添加列的功能才能生效。缺少该权限时,数据摄取仍会成功,但新字段会被静默忽略,不会创建对应的列。
Snowflake 的三层 Schema 结构。底层的 STREAMING 存放来自 Elastic Channel 的原始数据摄取表;中间层的 ANALYTICS 使用 Dynamic Tables 进行实时转换;顶层的 MONITORING 存放可观测性视图和告警。箭头由下至上。
CREATE OR REPLACE TABLE SENSOR_READINGS ( EVENT_ID STRING NOT NULL, DEVICE_ID STRING NOT NULL, DEVICE_TYPE STRING, FACILITY_ID STRING, READING_TS TIMESTAMP_NTZ NOT NULL, TEMPERATURE FLOAT, HUMIDITY FLOAT, PRESSURE FLOAT, VIBRATION FLOAT, BATTERY_PCT FLOAT, METADATA VARIANT, INGESTED_AT TIMESTAMP_NTZ DEFAULT SYSDATE())CLUSTER BY (DEVICE_ID, TO_DATE(READING_TS))ENABLE_SCHEMA_EVOLUTION = TRUE;
复制代码
EVENT_ID 是稳定标识符。它不是主键约束(Snowflake 不会强制保证唯一性),而是 Dynamic Table 下游去重时使用的键。Elastic Channels 采用至少一次投递语义,这就是相应的处理方式。
ENABLE_SCHEMA_EVOLUTION = TRUE:如果生产者开始发送新字段(例如顶层字段 SIGNAL_STRENGTH),Snowflake 会自动添加对应列。Schema 演进会在持久化确认后异步进行。
按照 DEVICE_ID 和日期进行聚簇:针对最常见的查询模式——按设备查询时间范围内的数据——通过微分区裁剪提升效率。
from snowflake.ingest.streaming import StreamingIngestClientclient = StreamingIngestClient.from_table( client_name="iot-sensor-producer", db_name="SNOWPIPE_STREAMING_DEMO", schema_name="STREAMING", table_name="SENSOR_READINGS", profile_json="profile.json",)channel = client.get_elastic_channel()future = channel.append_row_with_wait(row, row["EVENT_ID"])future.result() # Blocks until durable acknowledgment
复制代码
from_table 会创建表模式客户端。get_elastic_channel() 返回隐式通道句柄。append_row_with_wait 返回一个 Future;当 Snowflake 已将数据持久化后,该 Future 会完成。接入逻辑就这么多。
SDK 负责批处理(按时间和大小阈值)、压缩、瞬时故障重试以及连接管理。基于 Rust 的客户端核心由 Java、Python 和 Node.js SDK 共用。
pending = deque()MAX_OUTSTANDING = 500for row in source: if len(pending) >= MAX_OUTSTANDING: pending[0].result() # Back-pressure pending.popleft() future = channel.append_row_with_wait(row, row["EVENT_ID"]) pending.append(future)# Drain remainingwhile pending: pending.popleft().result()
复制代码
这种模式能限制内存使用量,并在 Snowflake 的确认处理管线达到饱和时施加背压。在测试中,使用这一模式时,单台 MacBook 在 3 秒内完成了 1,000 行数据的写入。
{ "user": "SATISH", "account": "mnb51130", "url": "https://mnb51130.snowflakecomputing.com:443", "private_key_file": "rsa_key.p8", "role": "STREAMING_PRODUCER"}
复制代码
无需存储密码,也无需处理 OAuth token 刷新逻辑。私钥保留在生产者主机上;公钥通过 ALTER USER ... SET RSA_PUBLIC_KEY 注册到 Snowflake。生产环境部署时,应将私钥存放在密钥管理服务中,并在运行时引用。
原始流式数据通常还不能直接用于查询。Dynamic Tables 通过声明目标延迟,持续进行数据转换:
CREATE OR REPLACE DYNAMIC TABLE DEVICE_HEALTH_SUMMARY TARGET_LAG = '1 minute' WAREHOUSE = COMPUTE_WHASSELECT DEVICE_ID, DEVICE_TYPE, FACILITY_ID, COUNT(*) AS TOTAL_READINGS, ROUND(AVG(TEMPERATURE), 2) AS AVG_TEMPERATURE, COUNT_IF(TEMPERATURE > 80 OR TEMPERATURE < -10) AS TEMP_ANOMALY_COUNT, COUNT_IF(VIBRATION > 50) AS VIBRATION_ANOMALY_COUNT, COUNT_IF(BATTERY_PCT < 20) AS LOW_BATTERY_COUNTFROM STREAMING.SENSOR_READINGSGROUP BY DEVICE_ID, DEVICE_TYPE, FACILITY_ID;
复制代码
CREATE OR REPLACE DYNAMIC TABLE SENSOR_READINGS_DEDUPED TARGET_LAG = '1 minute' WAREHOUSE = COMPUTE_WHASSELECT * FROM ( SELECT *, ROW_NUMBER() OVER ( PARTITION BY EVENT_ID ORDER BY INGESTED_AT DESC ) AS _RN FROM STREAMING.SENSOR_READINGS) WHERE _RN = 1;
复制代码
这就是处理 Elastic Channels 至少一次投递语义的架构方案:原始表接收重复记录,去重 Dynamic Table 在 1 分钟内完成处理。下游消费者查询去重后的表,而非原始表。
CREATE OR REPLACE VIEW DATA_FRESHNESS ASSELECT 'SENSOR_READINGS' AS TABLE_NAME, MAX(INGESTED_AT) AS LATEST_INGESTION, DATEDIFF('SECOND', MAX(INGESTED_AT), SYSDATE()) AS STALENESS_SECONDS, IFF(DATEDIFF('SECOND', MAX(INGESTED_AT), SYSDATE()) > 300, 'STALE', 'FRESH') AS STATUSFROM STREAMING.SENSOR_READINGS;
复制代码
CREATE OR REPLACE VIEW SENSOR_ANOMALIES ASSELECT EVENT_ID, DEVICE_ID, READING_TS, TEMPERATURE, VIBRATION, BATTERY_PCT, CASE WHEN TEMPERATURE > 80 THEN 'CRITICAL_HIGH_TEMP' WHEN VIBRATION > 50 THEN 'HIGH_VIBRATION' WHEN BATTERY_PCT < 10 THEN 'CRITICAL_LOW_BATTERY' END AS ANOMALY_TYPEFROM STREAMING.SENSOR_READINGSWHERE TEMPERATURE > 80 OR VIBRATION > 50 OR BATTERY_PCT < 10;
复制代码
Snowflake Alert 每 5 分钟检查一次数据新鲜度。当数据过期时,系统会记录警告,提示需要排查生产者状态、网络连接或密钥对认证。
我使用一台 MacBook(Apple Silicon M3、Python 3.12、SDK v1.8.0),对接真实 Snowflake 账户,端到端测试了这套实现:
单台 MacBook 的吞吐量不能代表平台的实际能力——Elastic Channels 支持每张表最高 20 GB/s 的吞吐量。但这次测试验证了 SDK、认证、表 Schema、Dynamic Tables 和监控视图能够作为一个完整系统正常工作。
生产者进程崩溃会导致 SDK 内存缓冲区中的数据丢失。未确认的事件必须在数据源端保留;
生产者与 Snowflake 之间的网络中断。SDK 会重试瞬时故障,但长时间中断需要生产者端进行缓冲。
ACCOUNT_USAGE.PIPE_USAGE_HISTORY——数据摄取所消耗的 credits。
数据摄取:按照摄取的未压缩数据量(GB)计费(当前费率请参见 Snowflake Consumption Table;博客公告提到的价格为每 GB 0.0037 credits)。无需承担基础设施成本;
snowflake-snowpipe-streaming/├── sql/01-foundation/ # Roles, warehouse, database├── sql/02-streaming-tables/ # Sensor readings, clickstream events├── sql/03-analytics/ # 4 Dynamic Tables├── sql/04-monitoring/ # Observability views + alerts├── sql/05-governance/ # RBAC grants├── producers/python/ # SDK producers (sensor + clickstream)├── producers/nodejs/ # Node.js SDK producer├── producers/rest/ # cURL REST API producers├── scripts/ # deploy.sh, validate.sh, teardown.sh├── tests/ # SQL validation tests├── macbook_setup.sh # Validated step-by-step local setup└── docs/ # Architecture diagram, runbook└── logs/ # setup and run logs at mac terminal
复制代码
macbook_setup.sh 中的每条 MacBook 命令都经过真实 Snowflake 账户验证,并记录了验证过程中遇到问题的具体排查步骤,包括 Apple Silicon 的 Python 版本要求、升级 pip 的要求以及虚拟环境的激活方法。
Elastic Channels 的意义不在于 Snowflake 现在能够更快地摄取流式数据。Snowpipe Streaming 早已具备这种能力。它在架构层面的意义是:管道中有一整层基础设施——那个唯一作用只是把数据送入 Snowflake 的消息总线——可以被移除。
如果 Kafka 需要服务多个消费者,或承担共享重放、数据保留等需求,它依然有存在的价值。但对相当一部分只把消息总线当作 Snowflake 数据摄取暂存层的管道来说,Elastic Channels 提供了一种更简单的架构:组件更少、延迟更低、定价透明,也无需运维基础设施。
Elastic Channels 负责数据摄取,Dynamic Tables 负责持续转换,监控视图负责运行可见性。三者组合后,便构成了一套完全运行在 Snowflake 内部的完整流式架构。无需外部计算,无需配置连接器,也无需调优消息代理。生产者追加数据行,其余工作交由 Snowflake 处理。
点击链接立即报名注册:https://www.snowflake.com/events/snowflake-ascent-china/更多 Snowflake 精彩活动请关注专区
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。