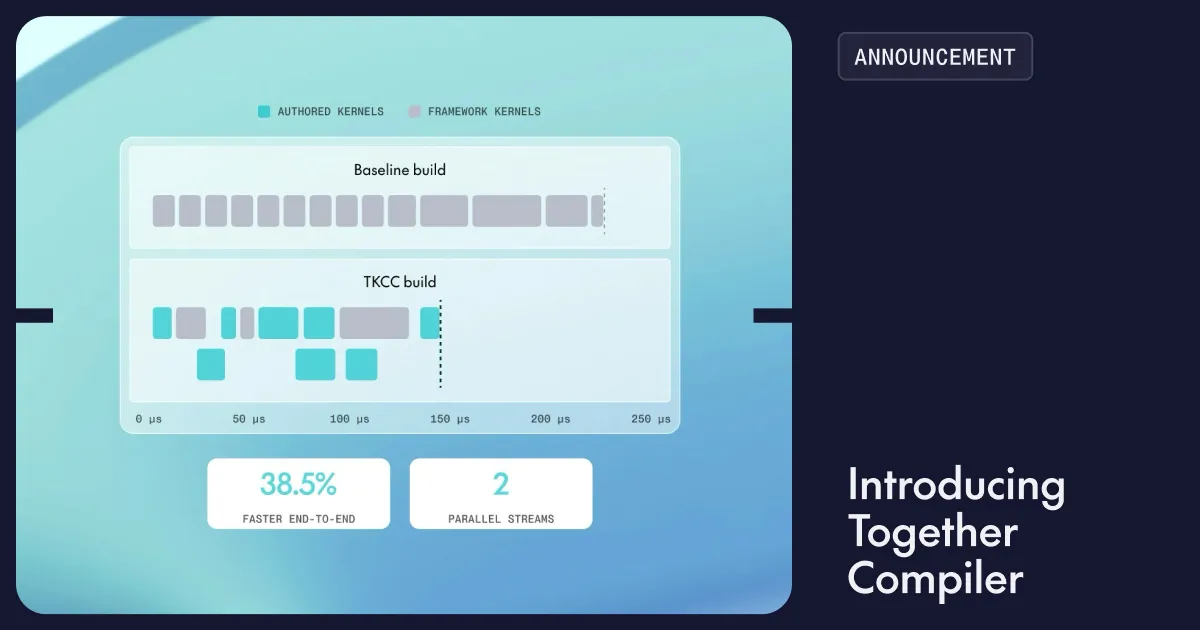
Together AI 发布 TKCC 编译器,自动优化 AI 推理性能
来源标题:Together Compiler: Continual Compilation for AI Inference
Together AI 推出面向 AI 推理的编译器 TKCC,可在不到 24 小时内将前沿开源模型的 TPS 最高提升 2.6 倍。它在 SemiAnalysis 的 InferenceX 低延迟基准上取得 SOTA,MiniMax M3.1-Flash 达 1111 TPS、DeepSeek v4.1-Flash 达 1205 TPS,实验吞吐量比基线智能体方案高 252 倍。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
AI 推理工作负载是动态的。新模型、硬件平台、客户、用例和流量形态构成了成千上万种场景。为每一种场景手工做优化,已经无法扩展了。
理论上,智能体非常适合解决这个问题。它们能够适应新的工作负载,在可能的优化空间中搜索,而不依赖那些困扰人类专家和传统机器学习编译器的固定规则或启发式方法。然而,当今的智能体系统受限于实验速度。
在不到 24 小时内,TKCC 在前沿开源模型(Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash)上实现了最高 2.6 倍的 TPS 提升,在 SemiAnalysis 的 InferenceX 基准的低延迟测试中创下最优成绩——MiniMax M3.1-Flash 上达到 1111 TPS,DeepSeek v4.1-Flash 上达到 1205 TPS,并在其主力测试场景 Llama 1B batch size 1 上比现有的开源 megakernel 高出 1.7 倍。此外,TKCC 还能泛化到语言模型推理之外的领域(气象建模、PDE、时间序列和生物学)。这一性能提升得益于 TKCC 相比基线智能体性能优化系统高出 252 倍的实验吞吐量。Together Compiler 目前每天服务数万亿 token。
作为推理服务提供商,我们观察到基于地域模式、新模型发布和突发流量而产生的各种用户行为。
显然,我们必须针对每一次新部署做专门优化,以适应不断变化的用户行为。
TKCC 以流量形态、模型和硬件作为输入,使用智能体为推理引擎生成一系列优化。
-
TKCC 在智能体优化过程中最大化实验吞吐量并最小化 GPU 空闲时间 大多数现有的智能体推理优化系统要求智能体启动并拆除 VLLM、SGLang 或 TRT-LLM 之类的引擎,来测试每一个新实验。然而,引擎启动需要数十分钟,严重阻碍了实验吞吐量(见下表)。为此,TKCC 提出了一种“持久化引擎”的新范式:引擎只启动一次,之后可以热重载任何候选前向计算,无需任何重启。为了确保持久化引擎始终有新的优化可测,TKCC 会启动多个智能体持续产生想法,并通过留言板通信来并行推进各自的工作。
-
TKCC 在测量吞吐量与测量保真度之间取得平衡 现有的智能体优化系统要么反复重新启动推理引擎,导致实验吞吐量低下;要么在推理引擎之外孤立地优化单个 kernel,导致测量保真度差。孤立优化 kernel 的系统通常使用随机输入数据来评估它们。然而,在采用 MoE 和稀疏 k 注意力等数据相关原语的现代架构中,输入数据分布会直接影响哪种优化策略可能胜出(见下图)。高保真输入对于有效优化至关重要。TKCC 使用分层持久化引擎来平衡吞吐量与保真度之间的取舍:“快速引擎”只加载少数几层,适合快速迭代和低方差计时;“较慢引擎”加载许多层,适合测试优化在真实数据分布下是否依然成立。
-
TKCC 利用自定义成本模型为智能体选择并行策略(如 TP、EP、DCP 等),以实现最高性能 现有系统拥有在 SLA 要求下选择推理配置的成熟方法。然而,选择理想配置面临同样的吞吐量-保真度取舍:测量每一种并行配置是不现实的,尤其是因为软件实现尚不成熟。一种朴素的做法是根据原始硬件规格或微基准来选择并行策略。但这不足以捕捉数据相关的流量特性,例如 MoE 专家不均衡或提示长度分布不均。我们设计了一个成本模型,采用分层测量策略,结合硬件规格、微基准和实测前向计算,构建高保真表示,同时快速剪枝配置搜索空间,以支持持续的流量漂移。
我们将 TKCC 与三类基线进行对比评估:手工调优的 megakernel、InferenceX 引擎配置,以及来自气象建模、PDE、时间序列和生物学模型等不同领域的流行 AI 代码库。
我们首先评估经典的 MegaKernel 工作负载:Llama 1B,batch size 1。该模型架构已被人类专家和传统机器学习编译器充分优化。TKCC 生成了 1.7 倍更高的 TPS,并且随着序列长度增加持续保持优势。
我们在 SemiAnalysis 的 AgentX 基准上评估 TKCC。我们从各推理引擎和硬件平台上前沿模型已报告的最佳开源引擎配置出发。TKCC 在所有设置下都持续刷新性能前沿,相比高度优化的基线最高实现 2.6 倍更高的 TPS。1
我们还专门评估了 batch size 1 的低延迟用例,并以 MiniMax M3.1-Flash 上 1111 TPS、DeepSeek v4.1-Flash 上 1205 TPS 创下最优性能。在这些结果中,我们使用成本模型来选择并行配置,而非使用 InferenceX 配置。我们观察到这种方法带来了加速。
我们选取了气象建模、PDE、时间序列和生物学领域流行的开源代码库。我们展示了 TKCC 相比单纯使用 Claude Code 配合 /goal 命令的几何平均加速比,说明 TKCC 的原则可以跨领域泛化。我们一直将 TKCC 作为 LLM 推理之外的通用 AI 编译器使用。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。