mdlARC v3 不依赖 LLM,在 ARC-AGI 2 上得分 37%
来源标题:37% on ARC-AGI 2 without an LLM
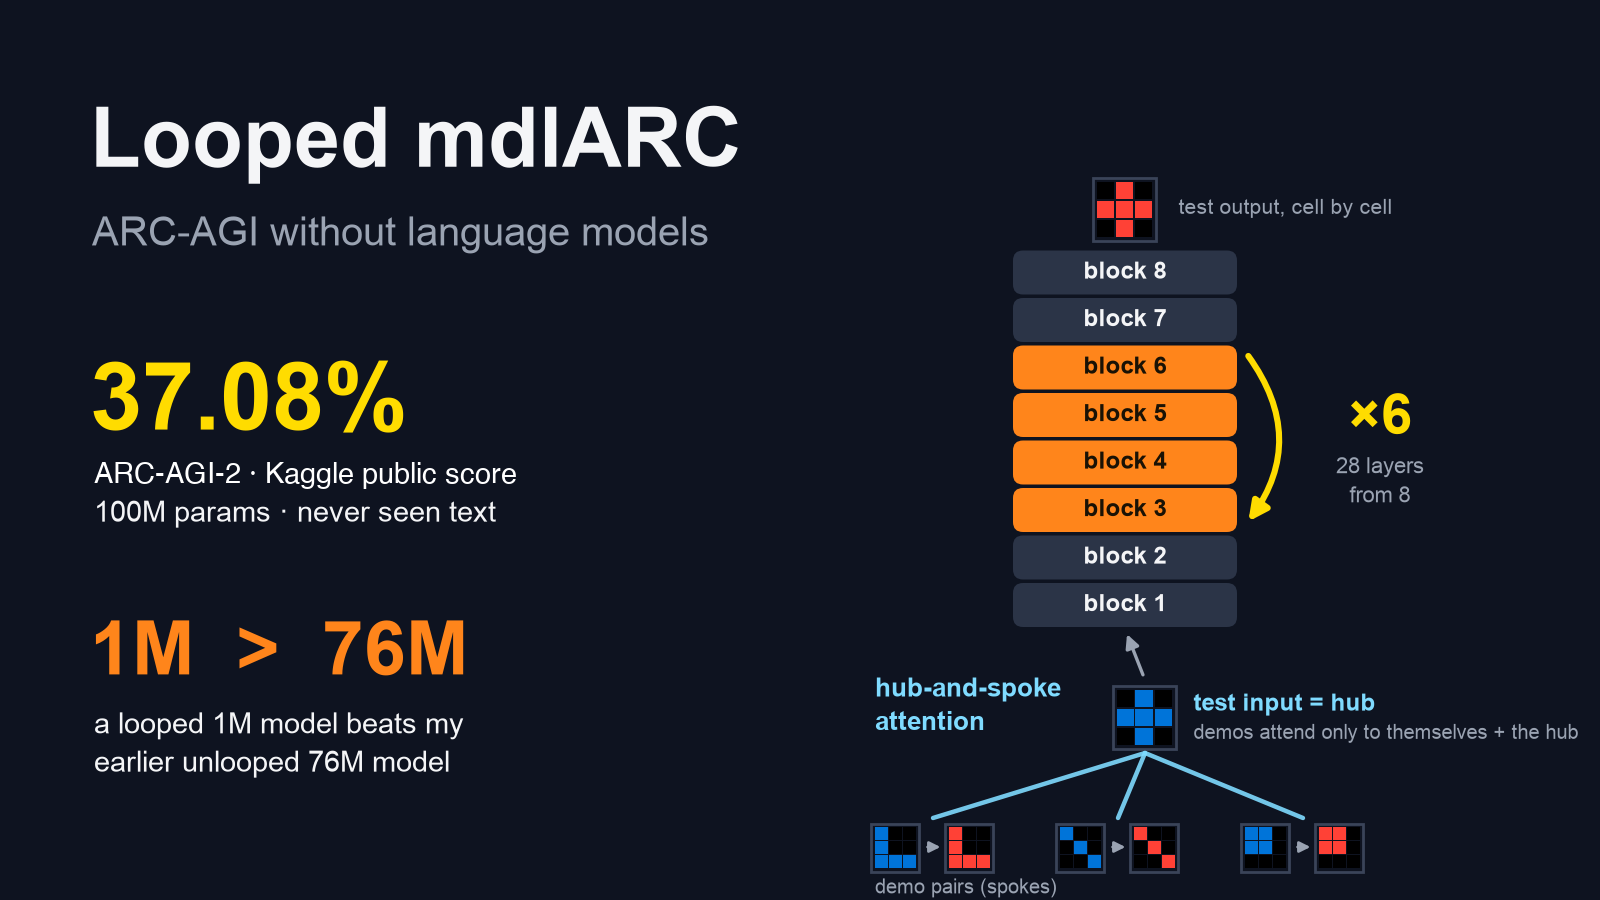
mdlARC 第三版仅用 ARC 谜题训练自回归 transformer,在 ARC-AGI 2 上取得 37% 的得分,未使用任何文本数据或 LLM。该模型通过 8 个权重块循环 6 次实现 28 次块传递,并采用学习式跳跃连接让输入直达每个块。作者同时推出新基准 ARC Data Squeeze,用于测试样本效率。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
到目前为止的演示+测试输入+输出 B1B2B3B4B5B6B7B8headnext cell× 6preludecodapasses 1–5 also exit(training only, weight 0.3)token embeddings reach every block through a learned skip; the prelude output is re-added at each pass由 8 个块产生 28 次块传递:2 + 4 × 6 + 2 图 1. 循环式 mdlARC。块 3–6 运行六次,因此 8 个块的权重产生了 28 次块传递。虚线:仅在训练期间,第 1–5 次传递也会提前退出并被评分。绿色:输入直接到达每个块。 这是 mdlARC 的第三个版本,在这个系列中,我试图探究:当自回归 transformer 只在 ARC 谜题上训练——没有文本、没有 LLM——它在 ARC 上能走多远(Vakde, 2025, Vakde, 2026)。 因为我关心样本效率,而 LLM 是在如此多的数据上训练的(包括 ARC 谜题),以至于无法衡量。现在已经很明显:只要有足够的训练数据,ARC-1/2 就会变得很容易解决。另一方面,当数据被限制为 ARC 谜题、尤其是非常少的谜题时,模型能表现得多好仍然非常有趣。 为了测试关于样本效率的想法,我正在启动一个新的 Benchmark:ARC Data Squeeze。更多细节见下文。 循环 ×6,0.71M:33.38循环 ×6,1.05M:49.0循环 ×6,2.0M:55.625循环 ×6,8.4M:66.25循环 ×6,18.9M:68.38循环 ×6,0.9M:41.25循环 ×6,0.99M:41.5循环 ×6,2.1M:51.25循环 ×6,18.9M,外加似然排序(ARC Data Squeeze 纪录):70.251.05M:49.002.0M:55.638.4M:66.2518.9M:68.38纪录:70.25循环 ×6(本工作)非循环,当前配方早期 mdlARC 版本TRM(报告值) 图 2. ARC-AGI-1 top-2 与参数量的关系,全部在 1,307 个公开任务上从零训练。循环式 1.05M 模型击败了两个 76M 的非循环模型。将鼠标悬停在点上可查看其精确分数。 我使用 ARC-1 Public Eval 来测试想法,仅在 1307 个公开谜题上从零训练。 循环式 mdlARC 在 ARC-1 上得分 70.25%——这是该受限集合上的当前 SOTA。 仅 19M 参数。在 ARC-2 上也得到 15.14%。以远更少的参数击败了我之前的结果:三月份的 44%(76M)和去年十二月的 27.5%(28M)。 最大的惊喜:所有这些几乎不依赖手工编写的知识。没有物体检测器,没有程序搜索,没有生成数据。ARC 是一个制作得异常精良的数据集。 抽象与推理语料库(Chollet, 2019)是一个抽象推理测试。每个任务展示几对演示:一个输入网格和它应该变成的输出网格。所有配对遵循同一条隐藏规则,你必须在最多两次尝试内为新测试输入产生精确输出。每个任务使用不同的规则,因此解决它们意味着学习物体、计数和对称等概念,并将它们组合成新的概念。看着 transformer 从如此少的数据中学会这一点,真是令人着迷。试一个: ARC-AGI-1 有 400 个公开训练任务和 400 个公开评估任务。ARC-AGI-2(Chollet et al., 2025)更难:1,000 个训练任务和 120 个公开评估任务,竞赛在隐藏任务上评分,限时 12 小时、四块 L4 GPU、无互联网。大多数参赛作品从预训练 LLM 出发(Akyürek et al., 2024; Franzen et al., 2024; Sorokin and Puget, 2025);mdlARC 从随机权重开始,仅从 ARC 网格中学习。它的名字来自最小描述长度原则(MDL;Rissanen, 1978; Grünwald, 2007):用最少比特解释数据(计入自身大小)的模型应该泛化得最好。 mdlARC 是一个普通的自回归 transformer,与 GPT 是同一类模型。它读取演示对和测试输入,然后一次一个单元地写出测试输出。 循环模型(图 1,顶部)有 8 个 transformer 块。块 1–2 运行一次,块 3–6 连续运行六次,块 7–8 运行一次。这样仅用 8 个块的权重就产生了 28 次块传递,即 28 层深度。 两个细节略有帮助。训练期间,前五次传递也会尝试通过块 7–8 提前退出并被评分(深度监督;Lee et al., 2014)。并且每个块都获得输入 token 嵌入的直接副本,因此循环永远不会丢失它正在看的内容。没有这两者的普通循环仍然完成了大部分工作(附录 B.4)。 长任务是问题。十对 30×30 的演示对构成约 20,000 个 token 的序列,而全注意力的成本随其平方增长。在 Kaggle 的 L4 GPU 上,对此类任务进行微调将无法放入内存。 解决办法来自人解决任务的方式:你将每个演示与测试输入比较,但很少将演示 2 与演示 5 比较。在中心辐射式注意力中,每个演示对只关注自身和测试输入(即中心)。测试 token 关注自身,并通过带有自己 softmax 的第二次注意力关注所有演示。每个头中的学习门混合两者。演示仅通过中心共享信息,成本随演示数量线性增长。 一个演示对输入输出……变成这些 token,从左到右读取S↵|↵E输入行输出行S 开始(一次,在最开始)· ↵ 新行 · | 输入结束,输出开始 · E 对结束整个任务是一个序列:演示对,然后是测试输入。模型写出答案。演示 1演示 2演示 3测试输入测试输出一次一个单元;仅在此处计算损失一次性全部读取(双向)每个 token 还获得一个 3D 位置:其行、其列,以及它属于哪个网格。没有任何东西记录哪个演示排在最前,因此演示是一个无序集合。 图 5. 任务如何变成序列。颜色是 token;四个特殊 token 标记结构。 每个网格逐行写入,每个单元一个 token。词汇表只有 14 个 token:10 种颜色,加上开始、新行、输入与输出之间的分隔符,以及结束。整个任务变成一个序列:演示对,然后是测试输入。模型逐个 token 写出测试输出,并自行决定何时停止,因此输出大小从不预先固定。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。