技术博客解析Hopper架构FP8 MMA内部机制
来源标题:Internals of FP8 MMA on Hopper
一篇技术博客深入解析了NVIDIA Hopper架构上FP8矩阵乘法累加(MMA)的内部机制,并指出其精度损失来自两个源头。其一是截断,在求和前丢弃与最大指数差距过大的低位;其二是舍入,Hopper使用的特殊格式将F32尾数最低10位写零,而该部分原本可承载23位精度。作者还给出了按位模拟MMA的模型代码。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
Hopper 上 FP8 MMA 的内部机制
Simon Veitner 2026年11月2日 分享
在这篇博客文章中,我们想介绍 Hopper 上 FP8 MMA 的内部机制。
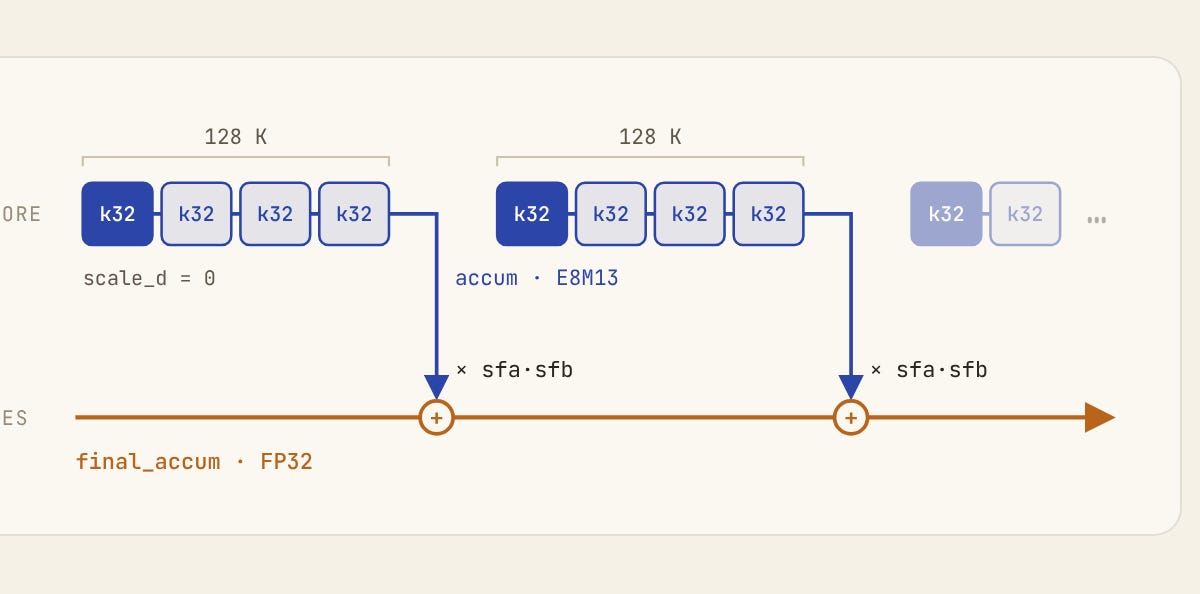
Hopper 的 FP8 MMA 特殊之处在于我们需要对累加器进行提升(promotion),其原因可以通过查看对应的 tensor core 算术来理解。
更准确地说,原因不止一个,而是两个,我们将在下面进行解释。
回顾我上一篇博客文章,相关公式(做了些许简化,以避免处理零和特殊值)如下:
不精确性的来源
如上所示,不精确性有两个来源:
截断(cutoff),即在 x 项和 c 被求和之前,将那些与最大指数相距足够远的位丢弃。
舍入(rounding),它在 Hopper 上使用一种特殊格式,该格式会将 F32 有效数的最低 10 位全部写为零,而这些位本可以容纳 23 位。
在位级 MMA-Sim 模型中,这大致建模如下:
def fda(a, b, c, L=32, F=13): s = [a[i].s * b[i].s for i in range(L)] + [c.s] e = [a[i].e + b[i].e for i in range(L)] + [c.e] e_max = max(e) S = 0 for s_i, e_i in zip(s, e): S += trunc(s_i * 2**(e_i - e_max + F)) * 2**(e_max - F) return rho(S)
def rho(S): # RZ-E8M13 m, e = frexp_and_normalize(S) # S = m * 2^e, 1 <= |m| < 2 return trunc(m * 213) * 2(e - 13)
在 MMA-Sim 中,每条指令都是一个 Python 对象,它像硬件指令一样接收 A、B 和 C:
import torch from mmasim.nv_ptx import WGMMA
wgmma = WGMMA("Hopper", "m64n8k32.f32.e4m3.e4m3")
def run(a, b): A = torch.zeros(64, 32); A[0, :len(a)] = torch.tensor(a) B = torch.zeros(32, 8); B[:len(b), 0] = torch.tensor(b) C = torch.zeros(64, 8) D = wgmma(A.to(torch.float8_e4m3fn), B.to(torch.float8_e4m3fn), C) return D[0, 0].view(torch.int32).item() & 0xFFFFFFFF
for a, b, expected in [ ([16, 0.125, 0.375, 1.5], [16, 0.125, 0.1875, 0.75], 0x43809800), # 257.1875 ([15, 0.125], [15, 0.0625], 0x43610000), # 225.0 d = run(a, b) print(f"0x{d:08x}", "ok" if d == expected else f"expected 0x{expected:08x}")
然后我们可以将 MMA-Sim 模型与真实的 GPU 内核进行对比。MMA-Sim 仓库包含大量测试用例,用于验证两者的输出在位级上完全一致。
在 GPU 上,同样的计算是一条 wgmma.mma_async 指令。下面是一个 m64n8k32 E4M3 tile 的内核,仅省略了共享内存拷贝和描述符部分:
#include <stdint.h>
// Copies a [rows x 32] FP8 tile to shared memory and returns its wgmma descriptor (body omitted). device uint64_t load_operand(uint8_t *smem, const uint8_t *src, uint32_t rows, uint32_t tid);
global void wgmma_kernel(float *d, const uint8_t *a, const uint8_t *b) { shared align(16) uint8_t a_smem[64 * 32], b_smem[8 * 32]; uint32_t tid = threadIdx.x, warp = tid / 32, lane = tid % 32; uint64_t a_desc = load_operand(a_smem, a, 64, tid); uint64_t b_desc = load_operand(b_smem, b, 8, tid); float acc[4]; for (int i = 0; i < 4; ++i) acc[i] = d[(warp * 16 + i / 2 * 8 + lane / 4) * 8 + lane % 4 * 2 + i % 2]; asm volatile("fence.proxy.async.shared::cta;" ::: "memory"); __syncthreads(); asm volatile( "wgmma.fence.sync.aligned;\n" "wgmma.mma_async.sync.aligned.m64n8k32.f32.e4m3.e4m3 {%0, %1, %2, %3}, %4, %5, 1, 1, 1;\n" "wgmma.commit_group.sync.aligned;\n" "wgmma.wait_group.sync.aligned 0;\n" : "+f"(acc[0]), "+f"(acc[1]), "+f"(acc[2]), "+f"(acc[3]) : "l"(a_desc), "l"(b_desc) : "memory"); for (int i = 0; i < 4; ++i) d[(warp * 16 + i / 2 * 8 + lane / 4) * 8 + lane % 4 * 2 + i % 2] = acc[i]; }
extern "C" void wgmma_m64n8k32_f32_e4m3_e4m3(float *d, void *a, void *b) { wgmma_kernel<<<1, 128>>>(d, static_cast<const uint8_t *>(a), static_cast<const uint8_t *>(b)); }
MMA-Sim 的内核封装用相同的 A、B 和 C 在 GPU 上运行这段代码,然后我们比较两者结果的原始 FP32 位:
import ctypes from pathlib import Path import torch from torch.utils.cpp_extension import load from mmasim.nv_ptx import WGMMA from mmasim_kernels.nv_ptx import WGMMA as WGMMAKernel
shape = "m64n8k32.f32.e4m3.e4m3" so = load("wgmma_e4m3", [str(Path(file).with_name("wgmma_e4m3.cu"))], extra_cuda_cflags=["-arch=compute_90a", "-code=sm_90a"], is_python_module=False) kernel = ctypes.CDLL(so).wgmma_m64n8k32_f32_e4m3_e4m3 kernel.argtypes = [ctypes.c_void_p] * 3 sim = WGMMA("Hopper", shape) gpu = WGMMAKernel("Hopper", shape, kernel)
for a, b in [([16, 0.125, 0.375, 1.5], [16, 0.125, 0.1875, 0.75]), ([15, 0.125], [15, 0.0625])]: A = torch.zeros(64, 32); A[0, :len(a)] = torch.tensor(a) B = torch.zeros(32, 8); B[:len(b), 0] = torch.tensor(b) A, B, C = A.to(torch.float8_e4m3fn), B.to(torch.float8_e4m3fn), torch.zeros(64, 8) D_sim = sim(A, B, C).view(torch.int32) D_gpu = gpu(A, B, C).cpu().view(torch.int32) print(f"MMA-Sim 0x{D_sim[0, 0].item():08x} GPU 0x{D_gpu[0, 0].item():08x} bitwise equal: {torch.equal(D_sim, D_gpu)}")
在 H100 上(H200 结果相同):
MMA-Sim 0x43809800 GPU 0x43809800 bitwise equal: True MMA-Sim 0x43610000 GPU 0x43610000 bitwise equal: True
提升的必要性
使用上述模型,很容易看出,如果我们只是以朴素的方式在 Hopper 上使用 FP8 MMA,会存在多个问题。
例如,FP8 MMA 的指令宽度为 32,因此 32 个项的点积本质上由一条指令完成。这个点积与已经存在的累加器融合。当我们执行一连串这样的指令时,很明显累加器会持续增长,经过一段时间后,它将主导最大的指数。
如果我们要向其添加较小的项,这就会导致不精确性,因为随着累加器变得越来越大,截断点也随之移动,我们在对一切求和时会丢失大量小值。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。