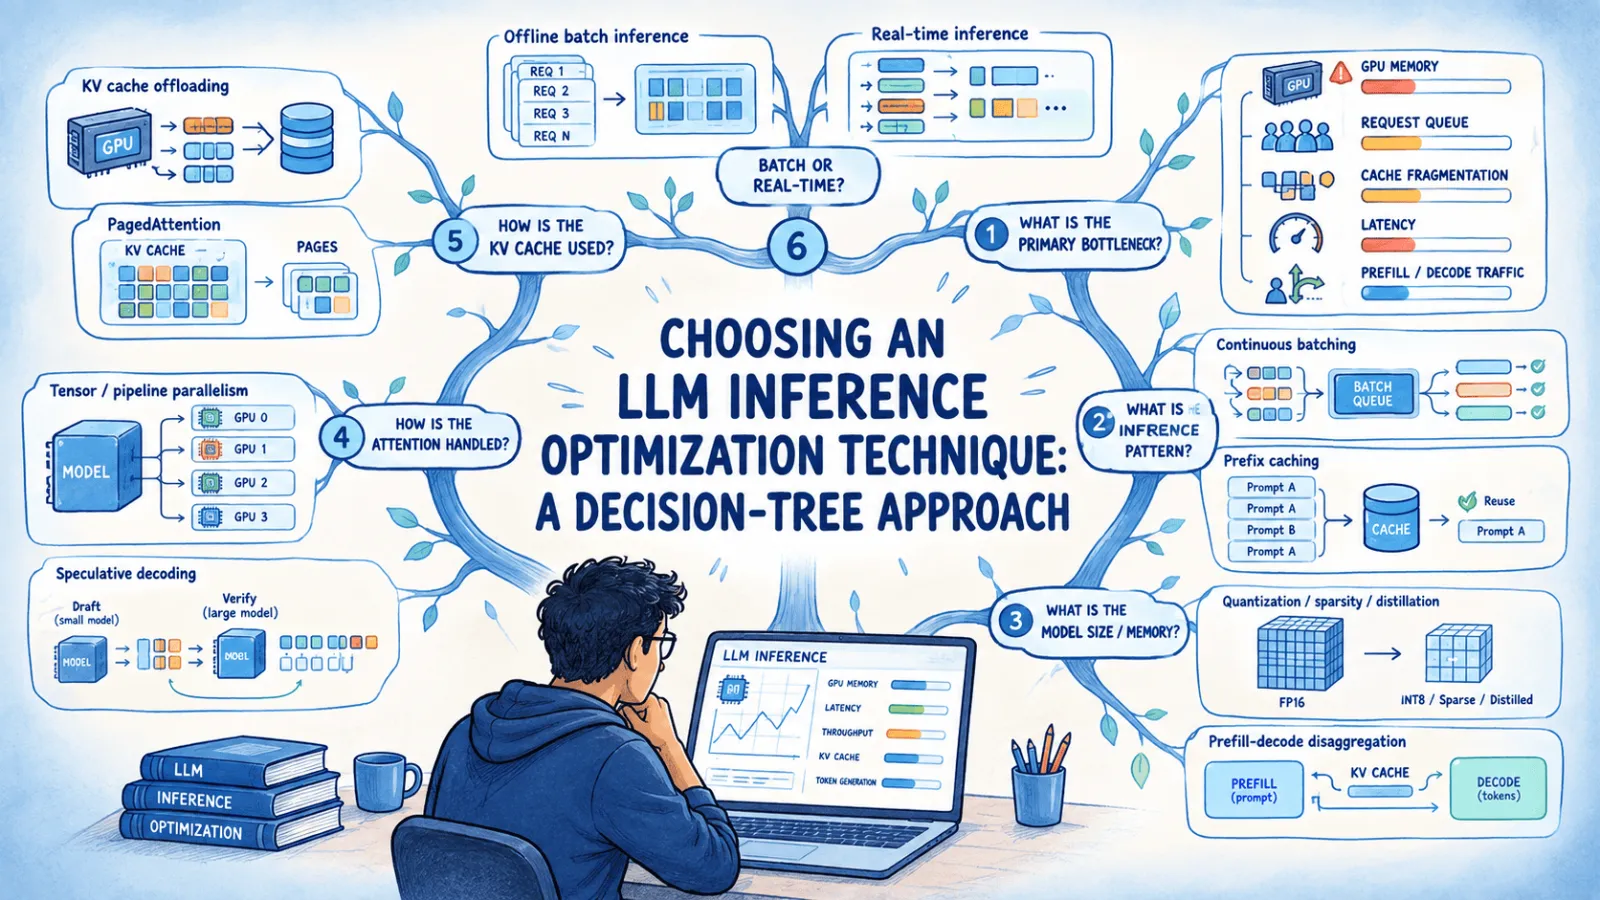
文章提出六问决策树,帮开发者选择 LLM 推理优化技术
来源标题:Choosing an LLM Inference Optimization Technique: A Decision-Tree Approach
一篇技术文章提出用六个问题的决策树,把 LLM 推理优化技术匹配到工作负载的实际瓶颈上。文章指出不同技术分别针对内存、计算和请求调度,使用前需先确认其假设是否适用于自身场景,选择应基于瓶颈以避免不必要的复杂度。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
分享 发布 分享 随着流量增长,LLM 推理会变得缓慢且昂贵。请求在长生成任务后面排队,GPU 内存被缓存的注意力状态填满,硬件大部分时间都在等待内存读取。
推理优化就是一组在此类场景下提供帮助的技术。有些技术针对内存,有些针对计算,还有些针对请求之间的调度方式。每项技术都对你的工作负载做出了特定假设,因此正确的选择取决于哪些假设适用于你的情况。本文涵盖以下内容:
我们先从每项技术所依赖的假设开始。
LLM 推理有许多优化技术,但每一项技术解决的是不同类型的瓶颈。在使用某项技术之前,先理解它所针对的工作负载会有所帮助。
根据工作负载中的瓶颈来选择技术,可以避免不必要的复杂性。
下面的决策树包含六个分支问题。每个问题都根据模型或流量的某个具体属性来缩小选择范围。每个问题的走向都一致:条件成立则给出直接答案,条件不成立则指向下一个问题。
在进入服务栈之前,先检查模型本身是否是问题所在。一个勉强能放进 GPU 内存的模型几乎不会给 KV 缓存留下空间,这意味着无论调度器多好,你的批大小都会受到限制。
如果模型过大,或者即使批大小为 1 时推理也是计算密集型,那么先从模型级压缩开始:
这些技术大多独立于服务栈,你可能需要优先考虑它们,因为它们决定了还剩多少硬件容量。
如果模型已经能轻松放下且还有余量,进入问题 2。
聊天应用在每一轮都会重新发送完整的对话历史。Agent 框架在数千次调用中复用相同的系统提示。检索增强生成(RAG)流水线通常会把相同的指令前置到不同的检索上下文之前。
如果你的流量中有相当比例具有相同前缀——无论是系统提示还是不断增长的聊天历史——前缀缓存就是可用技术中杠杆率最高的。它会跳过对模型已处理 token 的 KV 缓存重新计算,而且随着对话变长,收益会不断累积。
⚠️ 前缀缓存仅在共享前缀逐字符完全匹配时才有效。将稳定、可复用的内容放在提示开头,将可变内容放在末尾。
如果你的提示大多唯一、共享结构很少,进入问题 3。
一个返回一句话答案的客服机器人和一个返回四百行代码的代码助手,即使同时开始,也很少同时完成。在朴素批处理下,整个批次都要等待最慢的请求。
如果你的流量混合了短生成和长生成,并且以重叠的突发形式到达,连续批处理可以消除由此产生的空闲时间。已完成的序列立即离开批次,允许新请求无需等待批次边界即可开始。大多数服务引擎默认启用此功能。
如果你的流量已经很好地批处理,且 GPU 空闲时间不是问题,进入问题 4。
有些引擎会为每个请求预留一块固定的、连续的内存,大小按可能的最大序列长度计算,即使大多数请求要短得多。这块预留空间在请求的整个生命周期内都处于未使用状态,并且阻止其他请求使用它。
如果 KV 缓存浪费内存或限制了批大小,PagedAttention 可以提供帮助。它将缓存拆分为固定大小的页,允许以更小的块而不是大的连续块来分配内存。大多数现代服务引擎已经支持它,因此在添加新配置之前先检查它是否已启用。
如果内存不是约束,进入问题 5。
如果你的目标是让每个用户的 token 流式输出更快,而不是提高整体吞吐量,可以考虑推测解码。
一个较小的草稿模型会提前预测多个 token,主模型在一次前向传播中验证它们。当草稿模型预测正确时,多个顺序解码步骤可以一起完成,从而降低 token 间延迟。
代价是额外的模型和验证开销。如果你没有合适的草稿模型,或者其预测被接受的频率太低,增加的复杂性可能不值得。在这种情况下,进入问题 6。
这主要是生产规模下的关注点,因为它改变了服务架构。
如果长预填充延迟了解码请求,并损害了首 token 时间和 token 间延迟,预填充-解码分离可以将两个阶段分离到专用硬件上。预填充节点处理提示,然后将 KV 缓存传递给针对 token 生成优化的解码节点。
这会增加 KV 缓存传输和路由开销,因此只有在流量足以证明这种复杂性合理时才有意义。对于较小的工作负载或非交互式请求,离线批处理推理通常更简单。如果这些条件都不适用,从连续批处理和前缀缓存开始。
走完这棵决策树后,你会落到下表中的某项技术上:
一项你认为会奏效的技术,在实践中可能表现完全不同。以下信号能告诉你这种情况何时发生,以及应该先检查什么。
如果某项技术持续表现不佳,在增加更多复杂性之前,先检查其底层假设。
选择推理优化技术始于识别你的瓶颈。模型大小、提示重叠度、流量并发度、内存碎片化,以及吞吐量与每用户延迟之间的平衡,各自指向不同的答案,而大多数系统需要组合使用其中几项,而不是只依赖一项。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。