Yapern 为 sub-yap 增加网页抓取功能,自动收集短篇小说链接
来源标题:Adding crawl URLs to sub-yaps
Yapern 在 sub-yap 设置中新增 Crawler 功能,粘贴网址即可自动抓取新文章并生成带标题、来源链接和简介的帖子。首版只抓取近期结果页,不处理历史存档;测试中 CRAFT 和 X-R-A-Y 各生成 10 篇帖子。阅读列表目前覆盖 Electric Literature、SmokeLong 等 9 家杂志。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
我想在 Yapern 上开一个 sub-yap(话题版块),用来发现新的短篇小说,而不必手动从文学杂志复制链接。这些杂志本来就有编辑在挑选要发表的内容。Yapern 可以收集这些作品的引用,给人们一个讨论的地方,并附上指向原作的链接。阅读清单在 y/fiction。
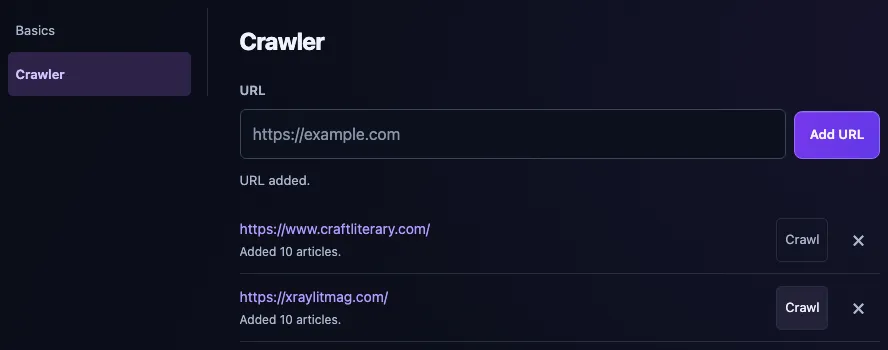
于是我在 sub-yap 设置的 Basics 旁边加了一个 Crawler 区域。粘贴一个 URL,加入列表,然后点击站点旁边的 Crawl。每篇新文章都会变成一条普通帖子,包含标题、来源 URL 和简短描述。第一版刻意做得很小:它只查看最近一页结果,不碰归档。
截图是使用真实出版商请求的本地预览。CRAFT 和 X-R-A-Y 各生成了十条帖子。要让这些行显示“Added 10 articles”,可不只是下载两个首页那么简单。
从九本杂志开始 阅读清单最初包括 Electric Literature、The Offing 和 SmokeLong,后来扩展到更小的杂志:CRAFT、X-R-A-Y、Fractured Lit、Pithead Chapel、Fictive Dream 和 The Citron Review。我曾要求给出大致的受众层级,但我没有这些网站可比较的流量数据。我把这九本当作寻找小说的地点清单,而不假装这些层级构成了排名。
早先的研究无法可靠地获取它们的 robots 文件。我在 2026 年 11 月 4 日使用 yapern.com crawler v1.0.0 检查时,直接 HTTPS 请求是有效的。以下是这些文件针对此爬虫根路径的说明。其他路径可能有不同的规则。
这些是爬取指令,不是重新发布小说的许可。CRAFT 和 Fractured Lit 还有限制对其网站进行竞争性使用的条款。robots 检查通过并不能解决那些单独的条款。该功能存储引用和简短描述;它不会创建全文小说归档。
该表是对 robots 文件的直接读取,与应用自身的网络检查无关。我们共享的 DNS 防护目前会在获取 robots.txt 之前拒绝 WordPress.com 的 192.0.78.* 托管地址。这需要更精细的地址检查;这些 robots 结果并不能证明全部八个站点都能在当前应用中完成爬取。
Worker 会将源 URL 升级为 HTTPS,并在源站检查 /robots.txt,即使保存的 URL 指向的是 feed 或分类页面。它在获取页面之前应用匹配的 agent 规则,也会检查重定向。404 或 410 的 robots 响应允许尝试;robots 访问错误则阻止尝试。这是 Robots Exclusion Protocol 对访问结果处理中的一种保守策略。我们还会拒绝私有网络目标,并跳过标记为 noindex 的文章页面。
我确实想过是否值得支持 RSS。它是 XML,很老,而且每本杂志都已经有网站。但首页会让我去推断哪个链接是故事、哪个日期属于它、一段文字是描述还是订阅推销。而 feed 经常把这些字段一起交给我。
即使故事仍然需要 HTML 请求,这也能省去工作。feed 找到候选;文章页面提供标题、描述、可用的发布日期以及规范 URL。如果出版商重新设计了首页,feed 仍能持续提供相同的结构。WordPress 包含 RSS 和 Atom feed,这使得它们在这份特定的站点清单上值得寻找。
发现代码会先尝试提供的 feed,然后尝试页面 HTML 中声明的 feed 链接以及几个常规位置。如果这没有产生候选,它会尝试 robots 声明的 sitemap、根 sitemap 以及有限数量的子 sitemap。源第一页上的文章链接是最后的备选。
我保留全部三种方式。用依赖布局的选择器替换可用的 feed,只会让我为同样的链接维护更多代码。当杂志有小说专用的 feed 时,那是比其首页更好的起始 URL。当前的提取器不保留作者或流派字段,也不会仅仅因为某篇作品发表在文学杂志上就将其归类为小说。
一次爬取可能比启动它的页面存活更久。API 端点会检查你拥有该 sub-yap,将任务保存到 D1,并将其 ID 发送到现有的 Cloudflare 队列。它返回 HTTP 202。浏览器轮询状态,重新打开 Crawler 会获取每个站点的最新任务。
POST /boards/:boardId/crawler-urls/:urlId/crawl GET /boards/:boardId/crawler-urls/:urlId/crawl 第一版最多考虑 20 个最近的候选。它优先使用可用日期,不跟随分页,并将发现过程限制在 45 个 HTTP 请求和 90 秒内。这些限制防止一次点击变成归档爬取。它们也暴露了一个限制:SmokeLong 的 20 秒延迟不允许我们在一次运行中获取二十个文章页面。慢速站点需要将工作拆分到更小、可恢复的任务中。CRAFT 未分组的延迟是另一个粗糙之处:当前解析器不会把那行附加到 user-agent 组。
启动一个已经活跃的源会返回其现有任务。队列 worker 通过租约认领它,维护任务可以恢复过期的认领。该维护任务修复中断的任务;它不会定期爬取每个已保存的站点。目前,你需要按下 Crawl。
同一个故事可能出现在首页 feed、小说 feed 和 sitemap 中。它也可能因为队列将任务投递了两次而再次出现。仅检查源列表对阻止重复帖子毫无作用。
我们为每个 sub-yap 保留导入 URL 的记录。跟踪参数和片段会被移除,当页面提供可接受的同站规范 URL 时,提取器会使用它。一个 D1 批次会一起保存消息、其导入记录和任务计数。然后同一 sub-yap 中的另一个源会发现该 URL 已被记录。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。