研究用Bandit算法优化电影推荐,epsilon-greedy策略高分率0.8826
来源标题:Bandits on Movie Ratings
一项实验将电影推荐建模为多臂老虎机问题,在12部热门电影的12,000次交互中,epsilon-greedy策略平均高评分率达0.8826,随机猜测策略仅0.7905。实验使用MovieLens 1M数据集,包含6,040名用户对3,883部电影的1,000,209条评分。结果表明,如何选择展示内容与预测评分准确率同样重要。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
在之前的文章中,我们搭建了一个推荐系统的各个组件:给电影打分的方法、划分用户的方法,以及衡量预测是否准确的方法。本文把问题反过来看。我们不再先预测评分再回头验证,而是一次推荐一部电影,并从收到的反馈中学习。在针对12部热门电影的12,000多次交互中,普通的epsilon-greedy策略达到了0.8826的平均高评分率,而随机猜测策略为0.7905。这个差距就是我们要说明的道理:我们如何选择展示什么很重要,而不仅仅是我们预测评分有多准确。
把推荐系统想象成一排老虎机,每部电影一台,每台的赔付率未知。每次拉动都消耗一次推荐机会,而我们只能看到所拉动那台机器的赔付。任务是把拉动次数花在刀刃上,经常拉动好的机器,同时仍在其余机器上投入足够次数,以确认它们不会暗中更好。这就是bandit框架,下面每个策略都将贯穿这一思路。
我们使用MovieLens 1M,与之前文章相同的评分文件:涵盖6,040名用户和3,883部电影的1,000,209条评分。我们下载数据、检查schema,并确认三个原始文件中没有缺失值。在此基础上,我们构建奖励、臂(arm)和上下文(context),然后针对固定的ground truth回放五种策略。一个臂就是我们可以推荐的一部电影;一个上下文是我们作为条件的用户属性,这里是年龄段。
第一个决策是什么算作奖励。评分从1到5,我们将其折叠为二值:4分及以上为命中,低于4分为未命中。这一划分给出的基准率为0.5752,因此略超过一半的评分是命中。分布偏向高端,但并没有极度不平衡到策略可以靠总是猜“命中”获胜。评分中位数为4.0,且没有重复的用户-电影行需要清理。
左图展示了电影评分常见的J形分布,集中在4分和5分。右图展示了对我们而言的后果:两个奖励类别大约分别在0.42和0.58,接近平衡,因此命中率是一个公平的评分指标。
另外两个发现影响了设计。年龄以年龄段存储,从18岁以下到56岁及以上,我们使用其中五个作为上下文。奖励随年龄和电影而变化,因此按年龄组分别估计的策略有收益可图。我们使用按电影划分的臂,因为类型广度无法识别单部电影。
用户集中在25至34岁年龄段,因此中间年龄段承载了大部分证据,边缘年龄段需要平滑。
我们无法进行在线实验,因此改为回放。我们选择评分人数最多的12部电影作为臂,这样每个臂都有足够的日志反馈可供估计。我们将用户按五个年龄上下文分桶,按70/30将用户分为训练集和测试集,并确认两个集合没有共享用户。测试用户只提供上下文,从不提供奖励估计,因此我们评估的人群不会造成泄漏。
Ground truth是一张平滑后的奖励表,每个上下文和臂对应一个概率,由训练行使用Beta(1, 1)平滑构建。这种平滑使未见的上下文-臂单元格保持在0.5而非零,这很重要,因为有些单元格很稀疏。从0.6到0.935的跨度意味着臂的选择在一个上下文中可使期望奖励变化高达0.335。按平均概率最强的臂是Raiders of the Lost Ark (1981)。
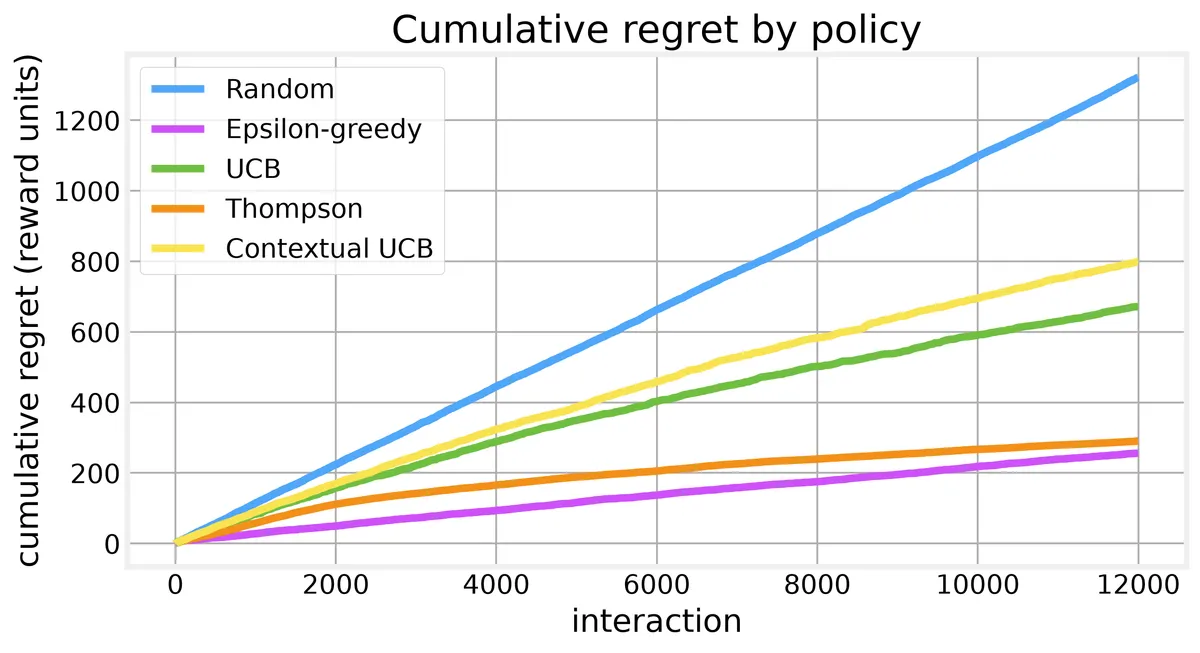
表固定后,模拟很简单。每一步,我们从测试用户中抽取一个上下文,询问策略该拉哪个臂,根据该上下文和臂的真实概率抛硬币,然后将奖励返回。每一步的遗憾(regret)是该上下文中可用的最佳概率减去我们所选臂的概率。对12,000步求和,得到累积遗憾曲线,曲线越低,说明策略把拉动次数花得越好。
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。