研究揭示CPU核间延迟受物理地址影响
来源标题:Core to core is not core to core
CPU核间延迟不仅取决于两个核心,还取决于物理地址,在mesh架构和部分Intel ringbus处理器上,最佳与最差情况可相差40至60纳秒。原因是缓存一致性由分布在各互连节点的home处理,改变地址会导致延迟波动。作者通过测量解释了该现象并据此构建了更稳定的基准测试。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
核间延迟不仅取决于核心 A 和核心 B,还取决于物理地址。(至少在以 mesh 为基础的处理器以及部分采用 Intel ringbus 的处理器上是如此。)这是因为一致性是在分布互联网络上的“home”节点处理的。尤其是在现代大型处理器上,改变地址可能导致 40 ns 到 60 ns 的最佳与最差延迟差异。本文讨论我如何发现、测量并利用这一行为。
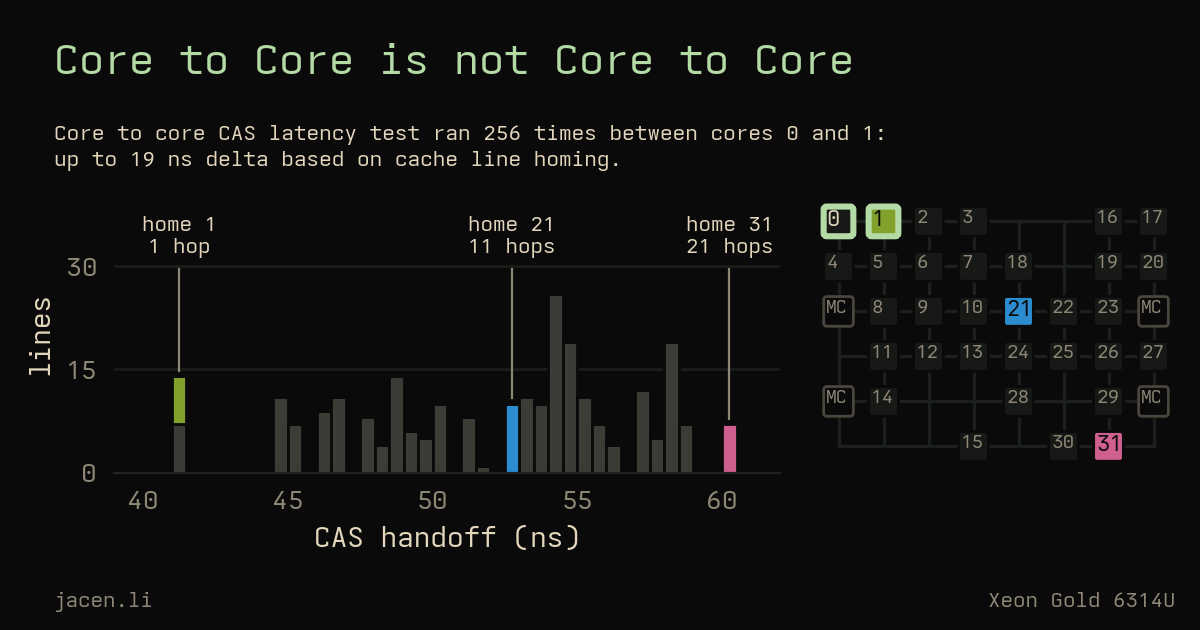
核间(c2c)延迟对带有交接的多线程任务至关重要。已经有很多现有基准测试可以测量它。1 然而,其中一些基准测试,尤其是使用单一地址的那些,掩盖了一种硬件行为。在固定的一对 CPU 上运行示例基准测试会显示出非常高的运行间方差。以下是几个基于“cas”的基准测试的对比,每个在 CPU 0 和 CPU 1 上运行 100 次: 标准差约为 5 ns,范围最高达 20 ns,很难相信每个基准测试只运行一次的结果。通过理解这种行为存在的原因,我得以创建更一致的基准测试,并理解一种我们可以加以利用的硬件行为。如果我们能让核间延迟不是平均约 50 ns,而是 40 ns 呢?Homing 是关键。
你可能还记得我上一篇关于缓存的文章,在像这样的现代 CPU 上,L3 被划分为多个 slice 以便更容易管理。在这个特定处理器上,每个 mesh tile 有一个 slice 以及配套的一致性“管理器”。每个物理地址通过其地址位的哈希被分配到恰好一个 slice。2 那个 slice,以及与之同处一地的一致性代理,就是该地址的 home,H。Home 是芯片跟踪谁拥有该 cache line 的地方。
当 CPU B 想要读取地址 X 时,它不知道还有谁拥有它的副本。虽然可以在 CPU B 中设置一个记分板来管理这些信息,但这本身在每个核心之间同步会非常复杂。因此,当为某个地址发送请求时,请求会被发送到 home,home 知道哪些其他核心拥有该 line 的所有权。然后它向那个其他核心发送 snoop,那个核心再把数据发回 home,home 再将其转发回核心(在直接缓存传输的情况下直接发回请求核心,AMBA CHI 允许这样做)。将 home 作为一个“记账者”极大地简化了处理器架构师的工作。
我们可以使用 mesh 性能计数器来测量这种行为。在这个芯片上,流量经过 mesh 的路径总是先垂直,再水平。我们还可以测量直接缓存传输的存在与否,这看起来像是一种直观的优化。 然而,这种硬件优化在这个 CPU 上并未被使用。使用 mesh 计数器,我没有看到任何直接缓存传输的证据,相反,所有数据都通过 home 转发。 从 CPU 4 到 CPU 6 的一次读取,home 22 真正重要的距离是 请注意,A 和 B 之间的距离本身实际上并不重要。两个更接近的核心只是部分更快,因为每次核间传输实际上是核心到 home 再到核心的传输。我测量了处理器上核心 A、核心 B 和 home H 的每种组合下的这种行为,并将上述公式计算的总 mesh 距离与所得延迟进行拟合:3 交互版本需要 JavaScript。 对于同步,你只使用一个地址,因此延迟是地址以及核心的函数。这个交互图显示了当你定义核心 A 和 B 时,每个 home 的核间延迟。如你所见,越远的 home 延迟越高。 交互版本需要 JavaScript。 现在回到那 100 次 c2c 延迟运行。我们之前看到的多峰行为实际上向我们展示了这种 homing 行为:每个峰实际上对应一个 home。虽然这些核间延迟测试的标准差约为 5 ns,但在固定 home 的情况下,标准差降到 0.1 ns!几乎所有的运行间差异都是由 homing 差异造成的,而不是其他因素。 交互版本需要 JavaScript。 当然,对于某些核心对,选择 home 影响较小,例如角落对:当 A 和 B 相距很远时,几乎每个 home 都靠近它们之间的路径,因此 homing 效应较小。这种效应在相邻核心上最大,因为它们可能有一个靠近自己 tile 的 home,也可能有一个在芯片另一侧的 home。
那么两个核心之间的“那个”延迟是多少?并不存在单一值。每个 home 有一个值,对这个特定处理器来说是 32 个,你得到的是分配给你的那个。现在,报告平均值或尾部结果可能是有价值的:作为程序员,你无法控制你得到哪个物理地址,因此你可以针对平均、最佳或最差情况进行优化。
那么如何获得这些结果呢?你可以多次循环其他单地址“cas”基准测试,但我认为拥有一个将这种多地址行为作为一等优先事项的基准测试更好,因为它可以保证不同的地址位置,而不是寄希望于操作系统给了你不同的地址,同时还能分摊开销以实现更快的运行,这在处理器扩展到数百个核心时很重要。
通过对许多地址取平均,我们可以将结果从单条 line 变为平均 line。以下是每次试验 1 到 4096 条 line,每个 1024 次试验,每次试验相同的一百万次交接: 交互版本需要 JavaScript。 均值不变,但离散度以 1/√N 下降,直到约 0.3 ns 的底噪,即运行间噪声。而到 16 到 64 条 line 时,池中最快的 line 位于最佳 home 上,比均值低 21%。
所以,我有点略过了核间延迟实际上是如何测量的:我提到了 CAS,但我们究竟如何做一个好的基准测试呢?
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。