AI 代理用 Lean 形式化 CPython,发现 418 个 Python 漏洞
来源标题:Formalizing CPython
AI 代理将 CPython 内部实现逐行改写为 613,318 行 Lean 代码,并对照真实 Python 测试、由计算机校验全部证明,过程中提交了 418 份 Python 漏洞报告。这项工作由 Opus 5.5 完成,Lean 副本与 CPython 的 C 源码逐行对应,行与行可相互对照。
以下正文由 AI 翻译自 Hacker News(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
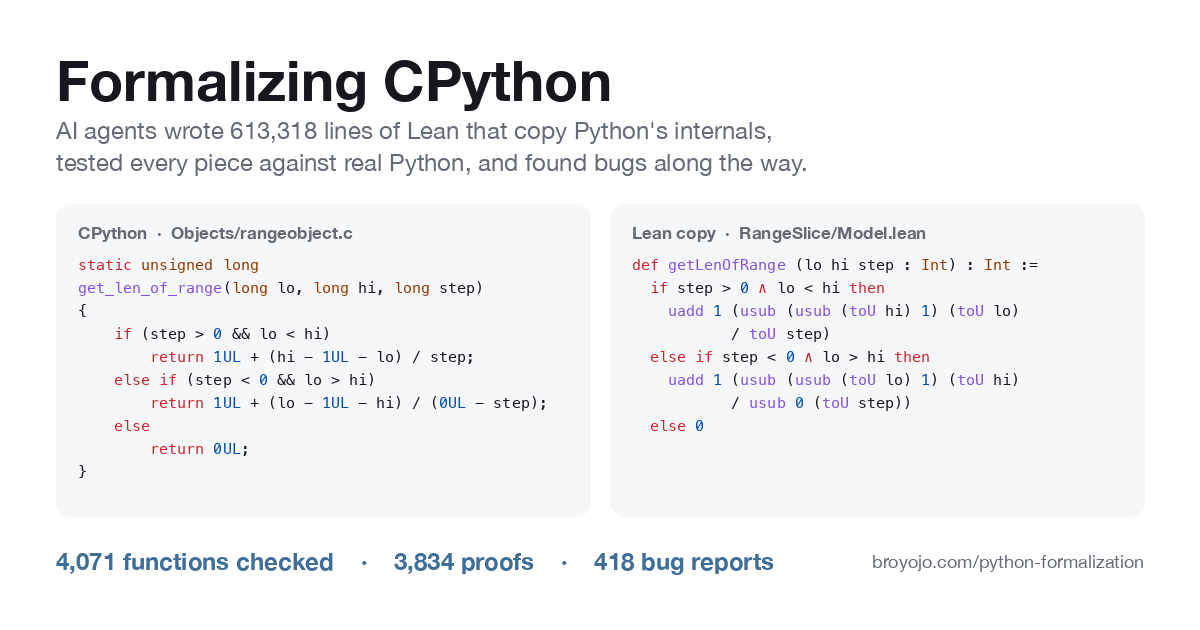
AI agent 编写了 613,318 行 Lean 代码,逐行复制了 Python 的内部实现,对每一部分都与真实 Python 进行了测试,让计算机检查了每一个证明,并在此过程中发现了 418 个 Python 的 bug 报告。
static unsigned longget_len_of_range(long lo, long hi, long step){ assert(step != 0); if (step > 0 && lo < hi) return 1UL + (hi - 1UL - lo) / step; else if (step < 0 && lo > hi) return 1UL + (lo - 1UL - hi) / (0UL - step); else return 0UL;} Lean 副本 · RangeSlice/Model.lean def getLenOfRange (lo hi step : Int) : Int := if step > 0 ∧ lo < hi then uadd 1 (usub (usub (toU hi) 1) (toU lo) / toU step) else if step < 0 ∧ lo > hi then uadd 1 (usub (usub (toU lo) 1) (toU hi) / usub 0 (toU step)) else 0 -- 每个证明都假设 step ≠ 0-- uadd, usub: C 的无符号算术,-- 超过 2^64 后回绕 左侧是 CPython C 源码中的一个函数,右侧是 agent 为其编写的 Lean 副本。将鼠标悬停在某一行上即可查看其对应行。 摘要 我们将 Opus 5.5 对准了 CPython——运行几乎所有 Python 代码的程序——让它用 Lean 重写其函数,Lean 是一种用于编写机器可检验证明的语言。 每个重写都逐行复制原始代码,并在任何人尝试对其证明之前,用数万个输入与真实 Python 进行测试。 一个函数只有在第二个 agent(未参与编写该函数)检查工作并认可其成立后才算数。目前已有 4,071 个函数通过了该检查。 结果是横跨 1,539 个文件的 613,318 行 Lean 代码,包含 18,898 个定理和引理,全部由 Lean 的证明检查器在每次构建时进行检查。 在此过程中,这些证明产生了 418 个 bug 报告。大多数很小,但约有 55 个可以从普通 Python 代码导致解释器崩溃或内存损坏。 已检查并接受已编写,尚未接受未开始 整个 CPython16% 解释器核心10% 内置类型35% C 模块19% 解析器31% 语法规则100% 标准库9% CPython 3.15.2 各部分已复制、测试、证明并通过审查接受的比例。没有可检查内容的代码(例如内存记账)被排除在外。 为什么要费这个劲 Python 没有一份精确的书面定义。有一本参考手册,但实际上“Python”指的是 CPython 所做的任何事情,而 CPython 是数十万行 C 代码加上一个庞大的标准库。手册涵盖了正常使用情况。它对奇怪的情况几乎只字不提,而 bug 恰恰藏在那里:一个对象在字典搜索它时修改了该字典,更新进行到一半时抛出的错误,比 C 代码编写时针对的最大值还大一的数字。 为函数编写证明会迫使你准确说明它在所有这些情况下的行为。你不能留下任何含糊之处,因为证明检查器不会接受。这使得证明成为发现代码未按所有人假设的方式行事之处的好方法。 我们想看看在一个像 CPython 这样庞大而古老的代码库上,这能走多远,以及当大部分工作由 AI 完成时,结果是否仍然可信。 每个函数都要经过相同的四个步骤。 本页顶部的代码是 CPython 一小部分的步骤一:计算范围中有多少个数字的 C 函数,紧挨着它的 Lean 副本。该副本保留了 C 代码的精确算术,包括数字过大时如何回绕。关于它的证明表明,这个函数、CPython 对超大数字使用的较慢版本,以及两者之间的选择代码,总是给出相同且正确的计数。 最难的部分不是让 AI agent 编写证明。而是让证明真正有意义。 我们的第一次尝试要求 agent 追求广度:复制每个函数并至少证明每件事。他们做到了。然后一项单独的审查发现,它所检查的函数中只有不到一半站得住脚,在一个文件中只有 21%。证明都是正确的。它们只是没有说明任何有用的东西。例如,“如果这个函数返回一个数字,该数字至少为零”是真的,但一个总是崩溃的函数也满足这一点。 因此,审查者现在对每个证明问一个问题:函数的损坏版本是否也能通过它? 修复弱证明通常意味着回过头去让副本更真实,例如让用户的代码在函数中途抛出错误。下面的图表显示了十个文件的情况。每个点是一轮审查。线条有时会下降:当审查者发现一个已接受的证明对真实 Python 来说是错误的时,所有依赖它的内容都会被撤回。 审查 1:142 个中 0 个接受审查 2:142 个中 2 个接受审查 3:142 个中 41 个接受审查 4:142 个中 130 个接受审查 5:142 个中 135 个接受Objects/typeobject.c142 个中 135 个接受 · 5 次审查 100%0%审查 1审查 5审查 1:56 个中 1 个接受审查 2:56 个中 18 个接受审查 3:56 个中 54 个接受审查 4:56 个中 55 个接受审查 5:56 个中 56 个接受Objects/genobject.c56 个中 56 个接受 · 5 次审查 100%0%审查 1审查 7审查 1:46 个中 31 个接受审查 2:46 个中 42 个接受审查 3:46 个中 44 个接受审查 4:46 个中 45 个接受审查 5:46 个中 44 个接受审查 6:46 个中 45 个接受审查 7:46 个中 46 个接受Objects/setobject.c46 个中 46 个接受 · 7 次审查 100%0%审查 1审查 5审查 1:48 个中 31 个接受审查 2:48 个中 39 个接受审查 3:48 个中 42 个接受审查 4:48 个中 43 个接受审查 5:48 个中 45 个接受Modules/_json.c48 个中 45 个接受 · 5 次审查 100%0%审查 1审查 9审查 1:39 个中 21 个接受审查 2:39 个中 30 个接受审查 3:39 个中 35 个接受审查 4:39 个中 34 个接受审查 5:39 个中 33 个接受审查 6:39 个中 34 个接受审查 7:39 个中 29 个接受审查 8:39 个中 36 个接受审查 9:39 个中 37 个接受Lib/enum.py39 个中 37 个接受 · 9 次审查 100%0%审查 1审查 3审查 1:38 个中 11 个接受审查 2:38 个中 31 个接受审查 3:38 个中 37 个接受Lib/random.py38 个中 37 个接受 · 3 次审查 100%0%审查 1审查 2审查 1:43 个中 9 个接受审查 2:43 个中 41 个接受Objects/abstract.c43 个中 41 个接受 · 2 次审查
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。