AI用Lean形式化CPython并发现418个潜在bug
来源标题:Formalizing CPython
AI代理将CPython内部实现逐行改写为613,318行Lean代码,并用真实Python对每部分进行测试、由计算机验证全部证明。过程中向Python提交了418份bug报告。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
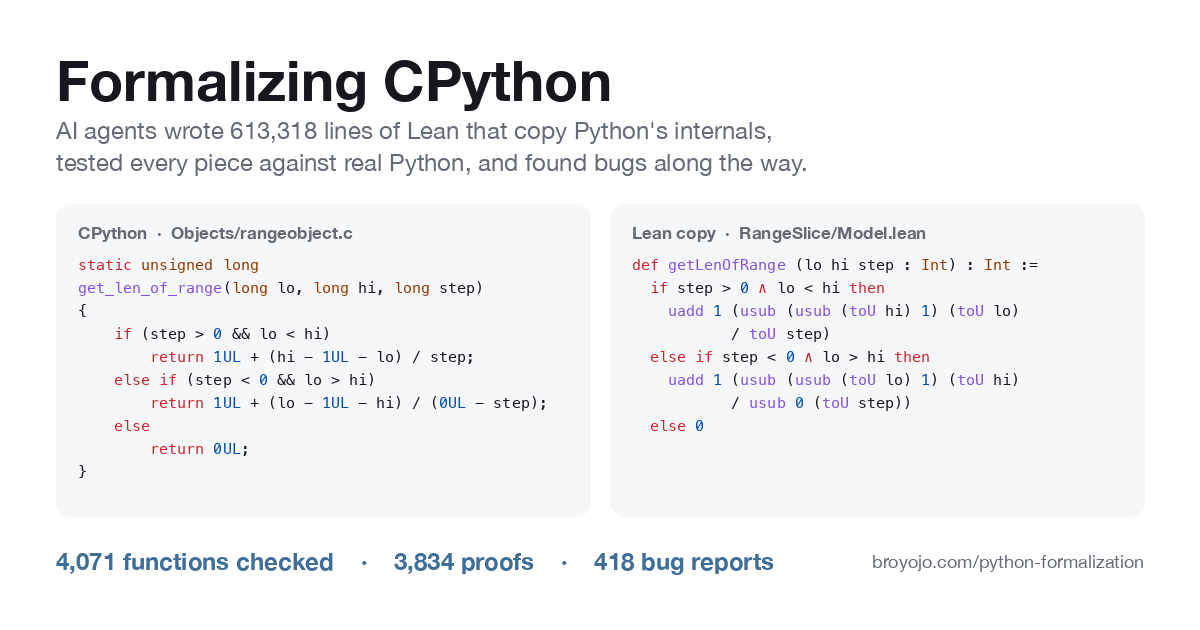
AI agent 写了 613,318 行 Lean 代码,逐行复制 Python 的内部实现,针对真实 Python 对每个部分做了测试,让计算机检查了每一个证明,并在此过程中发现了 418 个 Python 的 bug 报告。
static unsigned long get_len_of_range(long lo, long hi, long step) { assert(step != 0); if (step > 0 && lo < hi) return 1UL + (hi - 1UL - lo) / step; else if (step < 0 && lo > hi) return 1UL + (lo - 1UL - hi) / (0UL - step); else return 0UL; } Lean 副本 · RangeSlice/Model.lean
def getLenOfRange (lo hi step : Int) : Int := if step > 0 ∧ lo < hi then uadd 1 (usub (usub (toU hi) 1) (toU lo) / toU step) else if step < 0 ∧ lo > hi then uadd 1 (usub (usub (toU lo) 1) (toU hi) / usub 0 (toU step)) else 0 -- 每个证明都假定 step ≠ 0 -- uadd、usub:C 的无符号算术, -- 超过 2^64 后会回绕
左边是 CPython C 源码中的一个函数,右边是 agent 为其编写的 Lean 副本。将鼠标悬停在某一行上即可看到对应的另一侧。
TL;DR
我们把 Opus 5.5 指向了 CPython——运行几乎所有 Python 代码的那个程序——让它用 Lean 重写其中的函数。Lean 是一门用于编写机器可检查证明的语言。 每个重写都逐行复制原实现,并在任何人尝试对其做证明之前,先用数万个输入对真实 Python 做测试。 一个函数只有在第二个 agent(并非编写该函数的那个)检查了工作并认可其成立之后,才算数。到目前为止已有 4,071 个函数通过了这项检查。 结果是横跨 1,539 个文件的 613,318 行 Lean 代码,包含 18,898 个定理和引理,全部在每次构建时由 Lean 的证明检查器检查。 在此过程中,这些证明带来了 418 个 bug 报告。大多数很小,但其中约 55 个可以由普通 Python 代码导致解释器崩溃或内存损坏。 已检查并接受 / 已编写、尚未接受 / 未开始
整个 CPython 16% 解释器核心 10% 内置类型 35% C 模块 19% 解析器 31% 语法规则 100% 标准库 9%
CPython 3.15.2 各部分中有多少已被复制、测试、证明并通过评审接受。没有可检查内容的代码(例如内存记账)不计入在内。
为什么要费这个劲
Python 没有一份精确的书面定义。有一本参考手册,但实际上「Python」意味着 CPython 所做的一切,而 CPython 是数十万行 C 代码外加一个庞大的标准库。手册覆盖的是正常用法。它对那些古怪的边界情况着墨甚少,而 bug 恰恰藏在那里:一个对象在该字典正在查找它时修改了这个字典;一次更新进行到一半时抛出的错误;比 C 代码编写时所设想的最大值还大 1 的一个数。 为一个函数写证明,会迫使你准确说出它在所有这些情况下的行为。你不能留下任何含糊之处,因为证明检查器不会接受。这使得证明成为找出代码未按所有人假定方式运行之处的好办法。 我们想看看,在一个像 CPython 这样庞大而古老的代码库上,这件事能走多远,以及在大部分工作由 AI 完成的情况下,结果是否仍然可信。
每个函数都经过同样的四个步骤。
本页顶部的代码是 CPython 一小块的步骤一:那个计算范围内有多少个数字的 C 函数,以及它的 Lean 副本。副本保留了 C 代码的精确算术,包括数字过大时如何回绕。关于它的证明表明:这个函数、CPython 为极大数字使用的较慢版本,以及二者之间的选择代码,总是给出相同且正确的计数。
最难的部分不是让 AI agent 写出证明。而是让证明真正有意义。
我们最初的尝试要求 agent 追求广度:复制每个函数,并至少证明每个函数的一件事。它们做到了。然后一次独立评审发现,它所检查的函数中不到一半站得住脚,在某个文件里只有 21%。那些证明全都正确。它们只是没有说明任何有用的东西。例如,「如果这个函数返回一个数字,那么这个数字至少为零」是真的,但一个总是崩溃的函数也满足这一点。 所以评审者现在对每个证明只问一个问题:一个坏掉的函数版本是否也能通过它? 修复一个弱证明通常意味着回过头去把副本做得更贴近现实,例如让用户的代码在函数执行到一半时抛出错误。下面的图表展示了十个文件的进展。每个点是一轮评审。曲线有时会下降:当评审者发现一个已被接受的证明在真实 Python 上是错的,所有依赖它的东西都会被撤回。
评审 1:142 个中接受 0 个 评审 2:142 个中接受 2 个 评审 3:142 个中接受 41 个 评审 4:142 个中接受 130 个 评审 5:142 个中接受 135 个 Objects/typeobject.c 142 个中接受 135 个 · 5 轮评审
100% 0% 评审 1 评审 5
评审 1:56 个中接受 1 个 评审 2:56 个中接受 18 个 评审 3:56 个中接受 54 个 评审 4:56 个中接受 55 个 评审 5:56 个中接受 56 个 Objects/genobject.c 56 个中接受 56 个 · 5 轮评审
100% 0% 评审 1 评审 7
评审 1:46 个中接受 31 个 评审 2:46 个中接受 42 个 评审 3:46 个中接受 44 个 评审 4:46 个中接受 45 个 评审 5:46 个中接受 44 个 评审 6:46 个中接受 45 个 评审 7:46 个中接受 46 个 Objects/setobject.c 46 个中接受 46 个 · 7 轮评审
100% 0% 评审 1 评审 5
评审 1:48 个中接受 31 个 评审 2:48 个中接受 39 个 评审 3:48 个中接受 42 个 评审 4:48 个中接受 43 个 评审 5:48 个中接受 45 个 Modules/_json.c 48 个中接受 45 个 · 5 轮评审
100% 0% 评审 1 评审 9
评审 1:39 个中接受 21 个 评审 2:39 个中接受 30 个 评审 3:39 个中接受 35 个 评审 4:39 个中接受 34 个 评审 5:39 个中接受 33 个 评审 6:39 个中接受 34 个 评审 7:39 个中接受 29 个 评审 8:39 个中接受 36 个 评审 9:39 个中接受 37 个 Lib/enum.py 39 个中接受 37 个 · 9 轮评审
100% 0% 评审 1 评审 3
评审 1:38 个中接受 11 个 评审 2:38 个中接受 31 个 评审 3:38 个中接受 37 个 Lib/random.py 38 个中接受 37 个 · 3 轮评审
100% 0% 评审 1 评审 2
评审 1:43 个中接受 9 个 评审 2:43 个中接受 41 个 Objects/abstract.c 43 个中接受 41 个 · 2 轮评审
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。