FastBCP 1.6 无需还原即可直接从 SQL Server 备份导出 Parquet
来源标题:Exporting tables from a SQL Server backup (.bak) to Parquet without restoring it
FastBCP 1.6 可直接从 SQL Server 完整备份的 .bak 文件中读取表并导出为 Parquet,全程无需还原数据库,也无需 SQL Server 实例。在一个 320 GB 的生产备份上,首次打开耗时 2 分 29 秒,后续打开仅需 0.3 秒;使用 24 线程导出 1.75 亿行表耗时 29.6 秒。导出的文件可通过 FastTransfer 加载到任意版本的 SQL Server 或 PostgreSQL。
以下正文由 AI 翻译自 Hacker News(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
FastBCP 1.6 可以直接从 SQL Server 完整备份中导出表到 Parquet,无需还原,也不需要 SQL Server 实例。在一个 320 GB 的生产备份上,首次打开耗时 2 分 29 秒,后续打开仅需 0.3 秒。使用 24 个线程时,一张 1.75 亿行的表导出到 Parquet 仅用了 29.6 秒。FastTransfer 可以将这些文件加载到任意版本的 SQL Server 或 PostgreSQL 中。
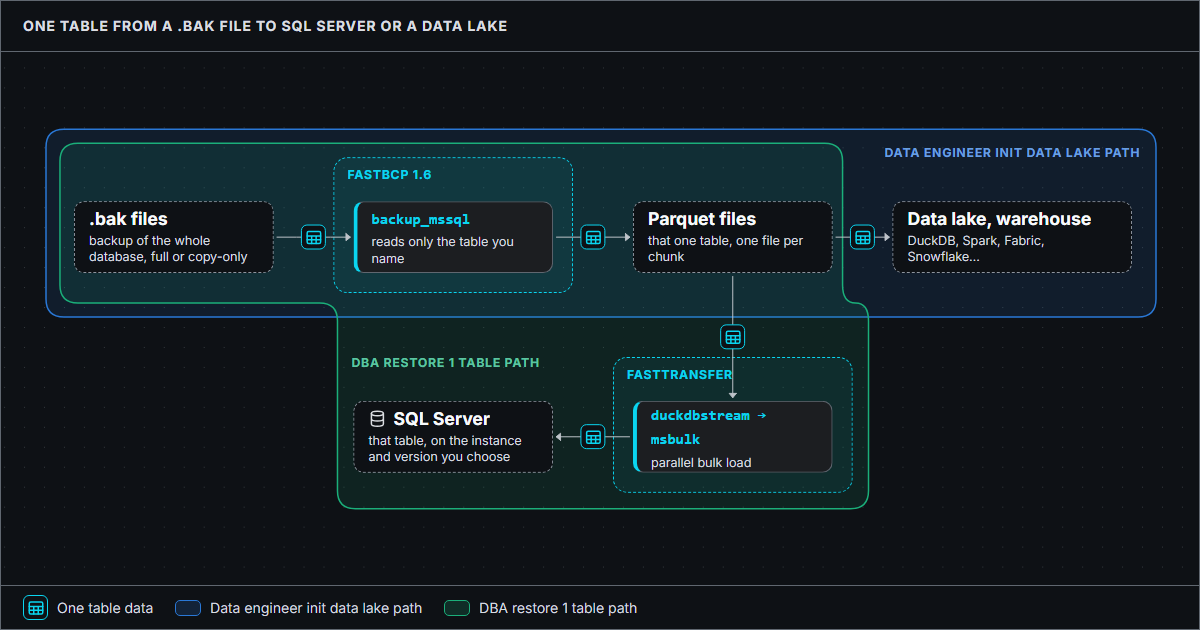
FastBCP 1.6 可以直接从 SQL Server 完整备份中读取表。只需指向一个 .bak 文件,指定表名,就能得到 Parquet 文件。无需还原,无需 SQL Server 实例,也无需管理凭据。
目前 Parquet 是唯一的输出格式。但这已经足够形成闭环:FastTransfer 可以将这些文件加载到你选择的 SQL Server 实例中,而且该实例可以运行比创建备份的版本更旧的版本。RESTORE 做不到这一点。
.\FastBCP.exe `
 --connectiontype backup_mssql `
 --server "D:\Backups\MSSQL" `
 --database "tpch_full.bak" `
 --sourceschema "dbo" `
 --sourcetable "orders" `
 --directory "D:\export\orders" `
 --fileoutput "orders.parquet" `
 --parallelmethod Physical `
 --paralleldegree 8
./FastBCP \
 --connectiontype backup_mssql \
 --server "/var/opt/mssql/backup" \
 --database "tpch_*.bak" \
 --sourceschema "dbo" \
 --sourcetable "orders" \
 --directory "/export/orders" \
 --fileoutput "orders.parquet" \
 --parallelmethod Physical \
 --paralleldegree 8
以备份作为源时,--parallelmethod Physical 会将表切分成与 --paralleldegree 相同数量的切片。每个线程读取自己的切片,每个分块生成一个文件(orders_chunk_000.parquet、orders_chunk_001.parquet……)。
要导出部分列,使用 --query 配合列名列表:SELECT o_orderkey, o_orderdate FROM dbo.orders。语法就这些:SELECT * | col1, col2, … FROM [schema.]table。不接受 WHERE 子句。
backup_mssql 背后的驱动 ArpeMSBackup 自行读取备份文件,不涉及任何 SQL Server 组件。
完整的类型映射见数据类型转换页面。
包含 copy-only 备份。差异备份和日志备份不会被应用。不包含完整备份的文件会被拒绝。
TDE 数据库的备份和加密备份(WITH ENCRYPTION)会被拒绝:没有服务器证书就无法读取其页面。
使用 Intel QuickAssist 压缩的备份不受支持。MS_XPRESS 和 ZSTD 支持。
还有一点需要注意:RESTORE 会重放备份中存储的那部分事务日志,以使数据库保持一致。FastBCP 不会。如果备份运行时表正在被写入,你得到的是复制时的页面状态。如需精确镜像,请在表静默时进行备份。
有人删了一张表,或者需要它上周二的样子。通常的解决办法是在生产环境旁边还原整个数据库,这意味着需要和数据库一样大的空闲磁盘空间,对于一个 2 TB 的备份需要数小时的还原时间,而这一切只是为了恢复一张表。
使用 FastBCP 和 FastTransfer,你可以从备份中导出那一张表,然后加载到任何你想要的地方:一个临时数据库、生产服务器上的另一个名称,或者一个运行旧版本的实例。SQL Server 无法将备份还原到比创建它的版本更旧的版本上,而 Parquet 文件不在乎这些。
加载步骤使用 FastTransfer,每个 Parquet 文件一个分块。目标表必须已存在。
.\FastTransfer.exe `
 --sourceconnectiontype duckdbstream `
 --sourceserver ":memory:" `
 --query "SELECT * EXCLUDE filename FROM read_parquet('D:\export\orders\*.parquet', filename=true)" `
 --targetconnectiontype msbulk `
 --targetserver "sql2019\restore" `
 --targetdatabase "tpch_restore" `
 --targettrusted `
 --targetschema "dbo" `
 --targettable "orders" `
 --loadmode Truncate `
 --mapmethod Name `
 --parallelmethod DataDriven `
 --distributekeycolumn "filename" `
 --datadrivenquery "SELECT file FROM glob('D:\export\orders\*.parquet')" `
 --degree 8
./FastTransfer \
 --sourceconnectiontype duckdbstream \
 --sourceserver ":memory:" \
 --query "SELECT * EXCLUDE filename FROM read_parquet('/export/orders/*.parquet', filename=true)" \
 --targetconnectiontype msbulk \
 --targetserver "sql2019,1433" \
 --targetdatabase "tpch_restore" \
 --targetuser "FastUser" \
 --targetpassword "FastPassword" \
 --targetschema "dbo" \
 --targettable "orders" \
 --loadmode Truncate \
 --mapmethod Name \
 --parallelmethod DataDriven \
 --distributekeycolumn "filename" \
 --datadrivenquery "SELECT file FROM glob('/export/orders/*.parquet')" \
 --degree 8
迁移
迁移从对现有数据进行批量复制开始。从昨晚的完整备份中读取数据不会对源服务器造成任何负载,而且备份通常已经位于迁移团队可以访问的共享位置。如果你必须走从新版本到旧版本的路径,Parquet 也消除了版本限制。
假设你要从 SQL Server 迁移到 PostgreSQL。FastBCP 将每张表从备份导出到 Parquet,然后 FastTransfer 通过 PostgreSQL 的 COPY 协议加载这些文件:
每张表运行这对命令一次。先创建目标表:FastTransfer 加载到已存在的表中。
.\FastBCP.exe `
 --connectiontype backup_mssql `
 --server "D:\Backups\MSSQL" `
 --database "tpch_full.bak" `
 --sourceschema "dbo" `
 --sourcetable "orders" `
 --directory "D:\export\orders" `
 --fileoutput "orders.parquet" `
 --parallelmethod Physical `
 --paralleldegree 8
.\FastTransfer.exe `
 --sourceconnectiontype duckdbstream `
 --sourceserver ":memory:" `
 --query "SELECT * EXCLUDE filename FROM read_parquet('D:\export\orders\*.parquet', filename=true)" `
 --targetconnectiontype pgcopy `
 --targetserver "pgserver:5432" `
 --targetdatabase "tpch" `
 --targetuser "FastUser" `
 --targetpassword "FastPassword" `
 --targetschema "public" `
 --targettable "orders" `
 --loadmode Truncate `
 --mapmethod Name `
 --parallelmethod DataDriven `
 --distributekeycolumn "filename" `
 --datadrivenquery "SELECT file FROM glob('D:\export\orders\*.parquet')" `
 --degree 8

(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。