研究:规格质量影响AI编码项目的缺陷修复占比
来源标题:Epic framework for spec-driven development
一项针对114个规格驱动仓库的研究显示,规格质量最高的三分之一项目将11.8%的提交用于修复缺陷,最低的三分之一则达20.4%。该研究依据ISO/IEC/IEEE 29148标准对规格、计划和任务文件打分,将40项实践归入10个质量维度,每项0至3分,总分30分。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
在一项针对114个spec驱动仓库的研究中,spec写得最好的项目将11.8%的提交用于修复bug,而spec最差的项目这一比例为20.4%。如果coding agent依据你的spec进行构建,以下是如何判断它属于哪一组,以及需要修复什么。
Spec驱动开发已成为与coding agent协作的常规方式。你编写一份spec,通常还附有计划与任务清单,agent据此构建。Spec Kit、Kiro和ZeeSpec等工具可以帮助你编写这些文件。
但写出spec并不等于写得好。一份spec在人看来可能读起来很顺畅,却仍然让agent靠猜:
每个空白都会变成一次猜测,而有些猜测会变成bug。研究也证实了这一点。《EPIC Framework for Spec-Driven Development》(arXiv:2610.07534)依据ISO/IEC/IEEE 29148需求标准,对114个开源spec驱动仓库的spec、计划和任务文件进行了评分。得分最高的三分之一仓库将11.8%的提交用于修复bug,最低的三分之一则为20.4%。这只是相关性,并非因果证明,但差距相当大。
论文将40项实践归入4个大类下的10个质量维度:
每个维度按0–3分评分,总分30分。论文的分档为:低档(18分及以下)、中档(19–22分)、高档(23分及以上)。
论文给出了标准,却没有提供工具。对每一份spec手工检查40项实践并不现实。
EPIC Score将论文中的40项实践转化为自动化检查。它完全在你的浏览器或终端中运行,免费且开源。它以ZeeSpec(一个面向AI coding agent的开源spec构建器)中的一个标签页和一条命令的形式提供。
ZeeSpec已经可以通过覆盖六个维度(What、Where、When、Who、Why、How)的60个问题帮助你编写spec。新的EPIC Score标签页会对spec进行评分,于是两个步骤合并在同一页面上:构建、评分、修复、再评分。
打开ZeeSpec应用。顶部现在有两个标签页:Spec Builder和EPIC Score。
逐个回答每个维度的问题。此过程无需加载AI模型。
点击Generate Spec后,你会得到AGENTS.md。输出界面现在多了一个Score with EPIC →按钮。
- 查看评分
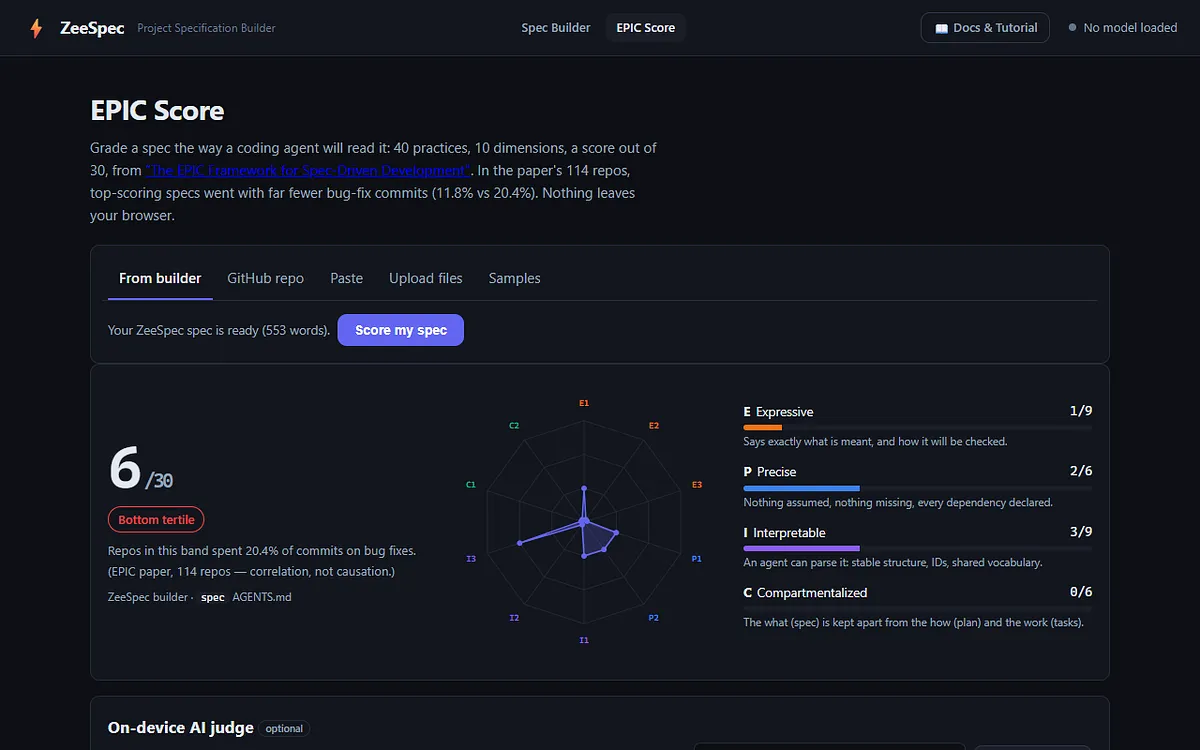
一键即可为你刚构建的spec评分。以下是一个诊所预约spec的结果:24个问题均以清晰、具体的句子作答。
它得了30分中的6分,属于最低档。这正是有价值的地方。答案本身不错,包含真实数字,如“within 2 seconds”“24 hours before”“retried 3 times”,也有真实的排除项:“Medical notes MUST NOT be sent”。但整份spec缺少agent所需的内容:没有需求ID,没有验收标准,没有术语表,没有待解决问题清单,也没有与需求分开保存的计划或任务清单。人读起来会觉得没问题,而评分揭示了agent可能不这么认为的原因。
雷达图让你一眼看出缺口的形状,右侧的条形图则汇总四个大类的得分。
评分下方,每个维度列出其各项实践,每项标记为✓已满足、~部分满足或✗缺失。评分器找到证据的地方,会引用所用的那一行,并附上文件名和行号。每一项未完全满足的缺口都附有一行修复建议。
因此,你得到的不是一句“你的spec很弱”,而是一份具体任务清单:添加带数字的Success Criteria,为每条需求分配稳定ID(FR-001),添加Out of scope章节,说明每个任务实现的是哪条需求。
评分器还会逐行检查无法测试的措辞:诸如“fast”“easily”“user-friendly”“etc.”“should be able to”“might”之类的词,以及以代词开头的行(“It should send notifications…”)。以下是它在一个故意写得很弱的样本上的表现:
每条发现都带有Rewrite with local AI按钮。一个可选模型通过WebGPU在你自己的GPU上运行,将该行改写为可测试的需求。如果该行需要一个模型不知道的数字,它会插入[NEEDS CLARIFICATION: …],而不是编造一个。
最后一节将评分转化为行动:
它不只适用于ZeeSpec的spec
该标签页接受五种输入来源:From builder、GitHub repo、Paste、Upload files和Samples。
输入owner/repo或粘贴GitHub文件夹URL。该标签页会在所有常见布局中查找类似spec的文件:Spec Kit(specs//spec.md)、Kiro(.kiro/specs)、ZeeSpec(.spec/.md)、AGENTS.md、PRD、计划和任务清单。它们按文件夹分组,方便你挑选某个功能的一组文件。
一个来自开源spec驱动项目的spec、计划和任务集得了22分,处于中档顶端:
徽章链接会打开这一确切视图,因此任何点击你README中徽章的人,都会基于你当前的文件重新计算并看到评分。
Samples标签页用两种方式写了同一个小的产品。含糊的单文件README得0/30分:
完整的spec + 计划 + 任务集得29/30分:
把两者并排放在一起,是了解这40项实践在实际中要求什么的最快方式。
同一个评分器也可从ZeeSpec命令行运行:
spec score # 对当前文件夹中的.spec/和AGENTS.md评分 spec score specs/003-feature # 任意文件夹或文件 spec score specs/ --min 23 # 低于高档时退出码为2 spec score --json # 机器可读输出
EPIC score — specs/003-tool-reservations/spec.md [spec], …/plan.md [plan], …/tasks.md [tasks] E1 Unambiguity ●●● 3/3 ◐ E1.3 当一条需求涵盖多项内容时,明确列出每一项。 E2 Singularity ●●● 3/3 E3 Verifiability ●●● 3/3 P1 Dependency Control ●●● 3/3 P2 Completeness ●●● 3/3 I1 Conformance ●●● 3/3 I2 Consistency ●●○ 2/3 ◐ I2.3 在计划和任务中引用spec的需求ID,使三个工件保持一致。 I3 Comprehensibility ●●● 3/3 C1 Scope Discipline ●●● 3/3 C2 Implementation-Planning Information ●●● 3/3 Total: 29/30 — Top tertile (34/40 practices fully met)
将spec score specs/ --min 23加入你的CI流水线,任何使你的spec跌出高档的pull request都会导致构建失败。这与你已经用lint和测试对代码运行的检查是一样的。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。