JetBrains 发布 IntelliJ Scala 插件 2026.3,改进 Scala 3 代码分析
来源标题:IntelliJ Scala Plugin 2026.3 Is Out!
IntelliJ Scala 插件 2026.3 发布,新增对 Scala 3.10 的支持并改进了内置代码分析,减少误报。新版还重做了面向 Play Framework 开发者的 Twirl 支持,并优化基于编译器的代码高亮以减少后台冗余工作。构建工具支持、调试和日常编辑也得到改进。
以下正文由 AI 翻译自 JetBrains Blog(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
大家好! Scala 插件 2026.3 来了!本次发布带来更准确的 Scala 3 代码分析、为 Play Framework 开发者大幅重构的 Twirl 支持,以及更高效的基于编译器的语法高亮——减少了多余的后台工作。此外还有构建工具支持、调试和日常编辑方面的改进。让我们仔细看看有哪些新内容。
Scala 3
本次发布新增对 Scala 3.10 的支持,并改进了内置的 Scala 3 代码分析,减少误报错误,使推断出的类型更加准确。 当重载涉及不同的接收者类型或泛型接收者类型、方法类型参数或隐式转换时,扩展方法现在能够更准确地解析。我们还修正了右结合扩展运算符的解析。代码补全、导航和快速文档现在能更清晰地区分接收者类型不同的扩展方法,代码补全列表中的重复条目也更少。 上下文参数解析现在在选择 given 实例时能更好地利用方法参数和显式类型参数。这避免了泛型代码中的误报歧义和隐式缺失错误,包括类型参数列表与值参数列表交替出现的调用。 类型推断现在能更准确地处理 transparent trait,避免推断出过于受限的集合类型。我们还改进了涉及高阶类型参数及其边界时的推断。对于匿名类,我们修正了插件推断出编译器不会推断的结构类型的情况。
改进的 Play Framework Twirl 支持
我们对 Play Framework 的 Twirl 模板支持进行了大幅重构,首先是完整的架构重写。随后我们对解析、代码补全、格式化、查找用法和引用解析做了大量改进。这些更新共同显著减少了误报错误,同时让模板的编辑、导航和重构更加可靠。 查找用法现在能在你修改模板之前可靠地定位到渲染该模板的 Scala 代码。重命名模板会自动更新项目中所有对它的引用,让你在重组 Play 应用时保持调用点一致。 此次重写还减少了内嵌 HTML、CSS、JavaScript 和 JSON 中的误报错误。结合格式化和补全方面的增强,处理多语言混合的模板现在轻松多了——干扰工作的误导性诊断信息更少了。
构建工具改进:sbt、Scala CLI 和 BSP
在 Scala 插件 2024.3 中,我们引入了独立的主模块和测试模块,以更好地反映 sbt 的项目结构。在 2026.3 中,这是唯一受支持的布局,禁用该布局的选项已被移除。这一布局支持更准确的依赖处理,以及为主源码和测试源码使用不同的编译器选项。 sbt 2.x 项目的导入也得到了改进,特别是在编译器插件路径解析方面。此外,构建脚本分析现在能正确处理 .value 和 / 表达式,避免有效的设置被编辑器标记为未解析错误。 在性能方面,我们解决了使用 Scala 3.8 时项目导入缓慢的问题,以及一个 BSP 导入的性能回归问题。 当 Scala 3 宏的实现发生变化时,IDE 构建现在会在必要时自动重新编译依赖它的代码。这确保宏实现变更后,已编译的代码不再保留过时的宏展开结果。 依赖坐标补全功能回归了,同时适用于 sbt 构建定义和 Scala CLI 的 //> using dep 指令。添加库时,代码补全会给出建议,帮你快速找到正确的坐标并插入到构建文件或脚本中。 最后,Scala CLI 脚本现在受益于改进的 shebang 解析、高亮和格式化。一项检查会检测本地脚本中带有首行 shebang 但缺少执行权限的情况,并提供快速修复使其可执行,让你在直接运行脚本之前就能解决问题。
调试改进
现在你可以在普通方法的单行条件返回语句上设置断点,例如 if (done) return result,并在调试时停在这些语句处。我们还解决了 Future 回调内部以及 Scala 3 顶层方法中定义的 for 推导式内断点被跳过的问题。 检查暂停程序中的状态也明显更加流畅。我们解决了表达式求值和监视求值期间 UI 卡死的问题,修复了对象展开卡在 Collecting data 的问题,并修正了 lazy val 声明的初始化操作的问题。 在单行条件返回语句上停在断点处。
更高效的基于编译器的语法高亮
基于编译器的语法高亮现在通过复用有效的诊断信息来避免不必要的重新编译,即使文件在编译期间被关闭也是如此。切换标签页或重新打开已经检查过的文件时,会显示存储的结果。此外,输入触发的后台工作更少,多个文件的待处理检查现在会合并为一次编译运行。 在存在错误的模块中的文件之间导航时,只要项目没有变化,就不会再触发重复的编译尝试。此外,如果另一个模块中的错误阻碍了高亮,编辑器会解释原因并提供指向阻塞错误的链接。 最后,我们解决了几个边缘情况问题。多模块 BSP 编译不再意外跳过所有目标;编译期间发生编辑时,诊断信息不再被移位到错误的行;编译运行被取消时,高亮错误不再被隐藏。 识别阻塞基于编译器语法高亮的模块。
编辑器中的较小改进
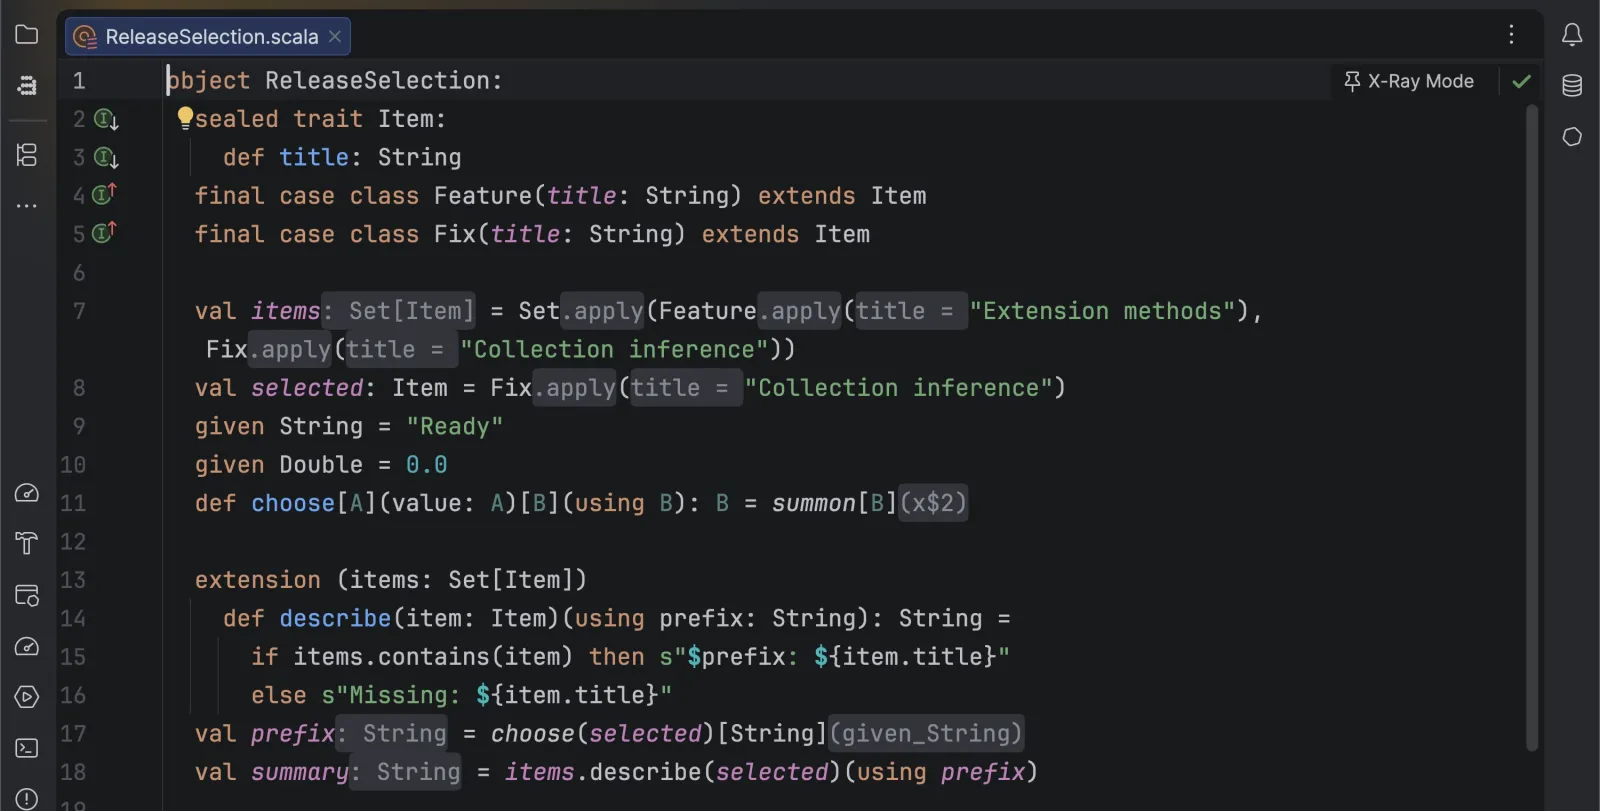
为了更快速地查看推断信息,X-Ray 模式现在会显示无参方法的推断类型参数。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。