Guava 中检查空白字符的方法为何如此复杂
来源标题:How hard is it to check for whitespace?
开发者 Sergey Tselovalnikov 在 Guava 源码中发现,检查字符是否为空白的方法比简单的 c == ' ' 复杂得多。原因是 Unicode 的 White_Space 属性定义了 25 个空白字符,远超普通空格,文章由此剖析了这段代码背后的复杂度来源。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
文章标题:如何检查空白字符有多难?
作者:Sergey Tselovalnikov,2026年10月30日
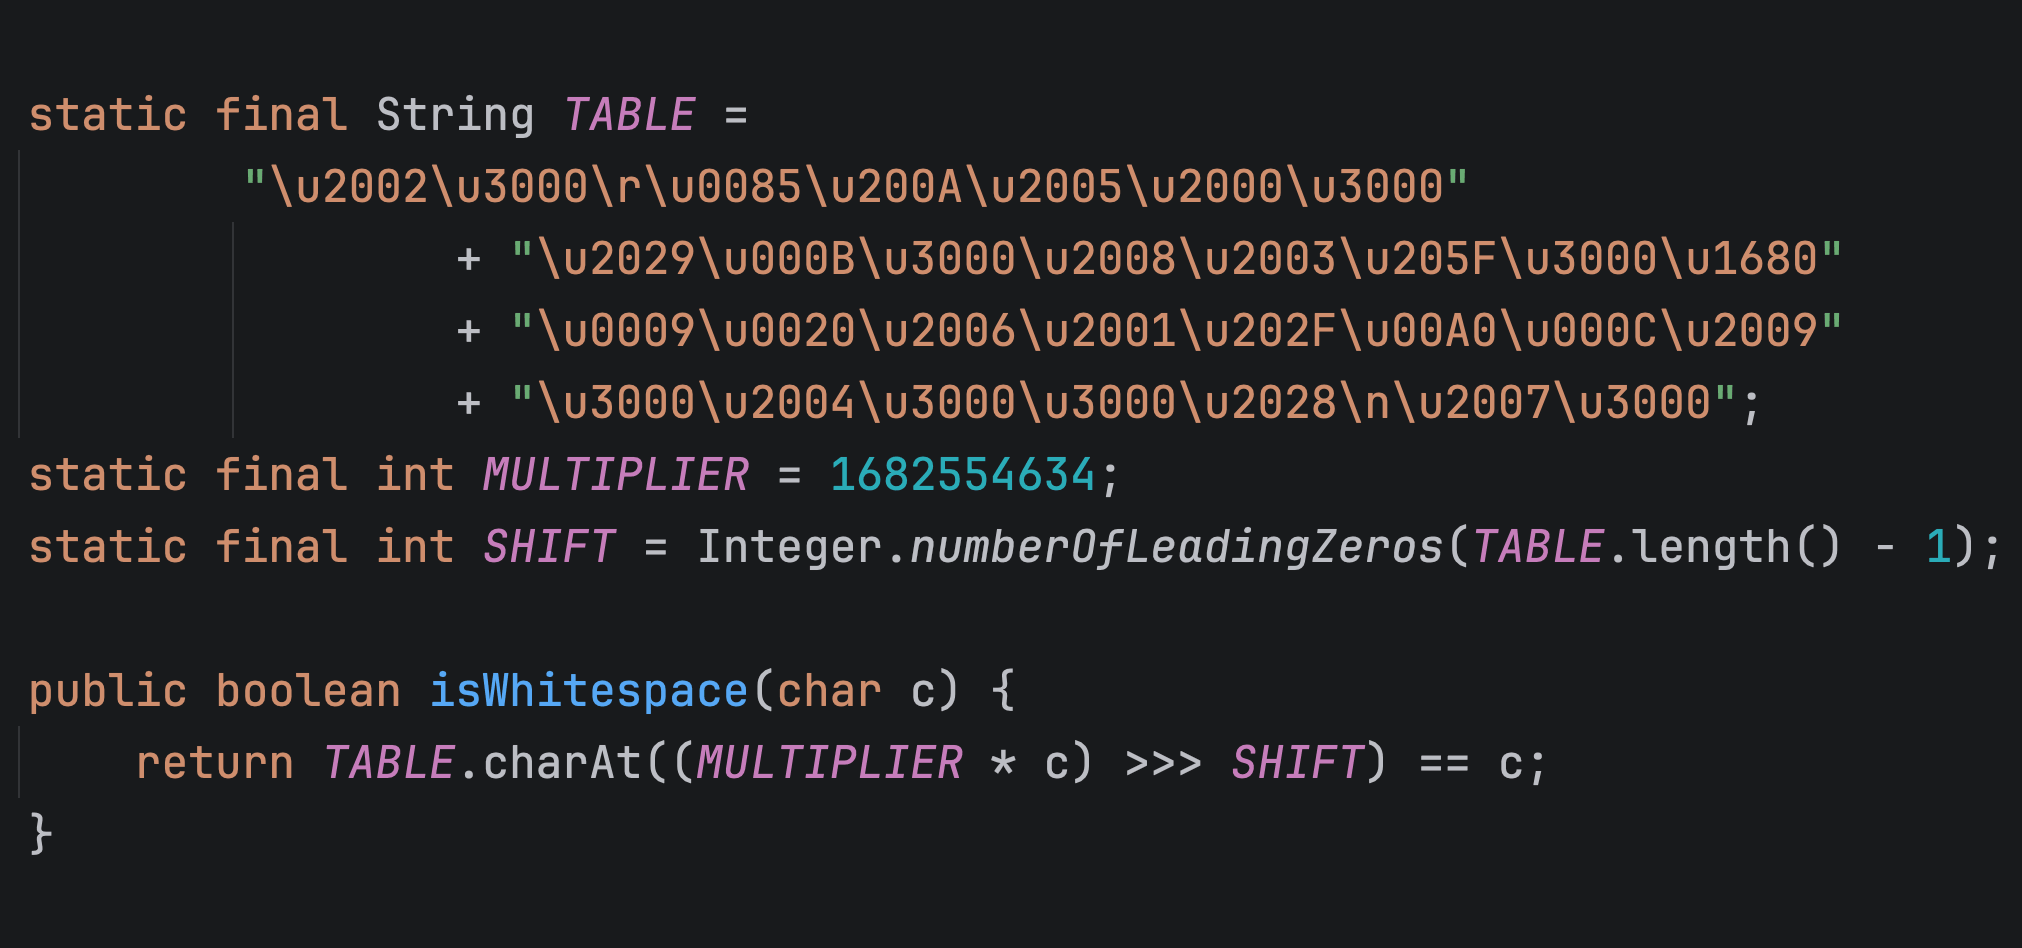
最近在翻阅一段源代码时,我偶然发现了Guava中的这个方法——Guava是Google推出的一个流行的Java库。
从名字你大概能猜到,这个方法用于检查给定字符是否为空白字符。但代码看起来比简单的 c == ' ' 检查要复杂得多。这让我很好奇,于是我开始了一番小小的探究,想弄清楚这些复杂性究竟从何而来。如果你也好奇这段代码是如何工作的,那这篇文章就是为你准备的。
检查一个字符是否为空白字符,首先需要定义什么是空白。虽然SPACE(U+0020)可能是最广为人知的空白字符,但它并不是唯一的一个。如果你写过一段时间代码,大概能说出几个其他的——不间断空格NO-BREAK SPACE(U+00A0)、制表符CHARACTER TABULATION(U+0009)、换行符LINE FEED(U+000A)。
其实还有更多。Unicode定义了一个White_Space属性,给出了25个字符的列表。它们分别是——我仔细抄录如下: 、、 、、 、、、 、 、 、 、 、 、 、 、 、 、 、 、 、 、 、 、 、 、 。
每个字符都有不同的用途。例如,FIGURE SPACE(U+2007)在表格中与数字等宽,而THIN SPACE(U+2009)和HAIR SPACE(U+200A)则提供逐渐更小的间隙。NO-BREAK SPACE(U+00A0)的宽度与普通空格相同,但在换行时会将周围的文本保持在一起。
有时候,无论从名称还是从字形上,都不容易判断一个字符是否属于空白字符集。比如,ZERO WIDTH SPACE(U+200B)根本不是空白字符。尽管名字如此,它是一种格式字符,可以在不添加可见间隙的情况下指示单词或换行的机会。
这个集合中还有一些不太明显的成员。OGHAM SPACE MARK(U+1680)实际上可以渲染为一条可见的水平线。在有主干线的欧甘字体中,空格会延续字母之间的那条线(例如 ᚛ᚆᚓᚂᚂᚑ ᚒᚑᚏᚂᚇ᚜),而在无主干的字体中,它则是空白的。所以,即使“空白字符看起来必须是空的”这个假设也并不总是成立。
只有所有人都能达成一致,单一的空白定义才有用。但即使在同一个运行时内,不同的库也可能对什么是空白存在分歧。
想想我上面提到的NO-BREAK SPACE(U+00A0)。它包含在Unicode的White_Space属性中,但Java明确将其排除在外,同时还排除了另外两个不间断空格。javadoc很有帮助地指出,该方法检查的是Java定义的空白,而不是我们之前看到的Unicode属性。
Character.isWhitespace(' '); // true
Character.isWhitespace('\u00A0'); // false
但其他运行时呢?看看另外两个更流行的运行时——Python和JavaScript,我们可以看到并不存在一个所有人都认同的权威字符列表。例如,Python有一个方便的 str.isspace() 方法。与Java不同,它将U+00A0视为空白字符。
那么Python是不是就遵循Unicode的White_Space属性呢?也不尽然。
"\u00A0".isspace() # True
"\u0085".isspace() # True
"\u001C".isspace() # True
"\uFEFF".isspace() # False
这里有趣的是FILE SEPARATOR(U+001C)。它是一个ASCII控制字符,最初用于分隔信息片段,并不包含在Unicode的White_Space属性中。所以Python识别29个空白字符,而不是Unicode的25个。
JavaScript则采用了另一种方式。它没有等价于 Character.isWhitespace() 的方法,但我们可以使用正则表达式中的 \s 字符类:
/\s/.test("\u00A0"); // true
/\s/.test("\u0085"); // false
/\s/.test("\uFEFF"); // true
上面最特殊的是NEXT LINE(U+0085)。Unicode明确将其包含在White_Space中,Python也接受它,但JavaScript不接受。相反,JavaScript识别ZERO WIDTH NO-BREAK SPACE(U+FEFF),而Unicode并未将其包含在该集合中。
我没有去研究其他运行时,但我有种感觉,这种不一致不会仅限于这三个。
更复杂的是,Unicode并非一成不变,而是在不断演进。这会影响空白的定义。例如,Unicode 6.3将MONGOLIAN VOWEL SEPARATOR(U+180E)从空格分隔符重新分类为格式字符,移除了它的White_Space属性。Unicode空白字符集因此从26个字符变为25个。对于追求向后兼容的运行时和库来说,这些变化可能是一个相当大的挑战,因为人们希望语言的标准库尽可能稳定。
假设我们最终就想要检查的字符集达成了一致——即当前的Unicode空白字符集。一种朴素的实现方式是遍历字符列表,检查是否有任何字符匹配。虽然这可行,但绝对不是最高效的方法。
所以,我们在文章开头看到的Guava实现采用了一个完美哈希函数——一种保证已知集合中字符不会发生哈希冲突的哈希函数。
static final String TABLE = "\u2002...";
public boolean matches(char c) {
 int slot = (1682554634 * c) >>> 27;
 return TABLE.charAt(slot) == c;
}
上面,TABLE是一个包含32个字符的字符串——实际上是一个哈希表,将每个索引(键)映射到一个字符(值)。它包含全部25个Unicode空白字符,并用一些重复字符填充剩余的位置。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。