TinyResearch 作者:不要把所有任务都交给大模型
来源标题:Stop running everything through LLMs: How I fixed my research agent
TinyResearch 开发者 Manav Mehta 撰文介绍该研究代理的内部运行机制,主张不应让所有环节都依赖 LLM。他以事实正确性、可信度、可读性、全面性和指令遵循五项指标衡量每次改动,并公布了三个公开基准上的表现。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
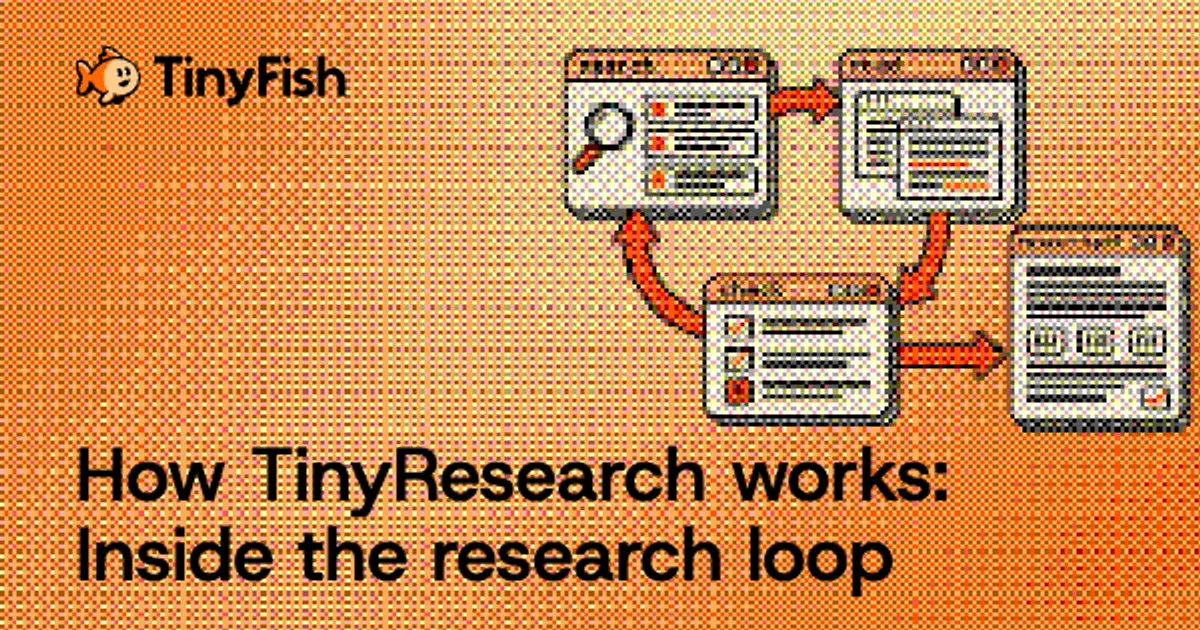
产品 TinyResearch 如何运作:研究循环内部 MMManav Mehta·2026年11月5日·阅读时长 10 分钟 今年大部分时间我都在构建 TinyResearch,它的目标说起来简单、做起来很难:你交给它一个难题,它交回来的结果足够好,好到你不需要自己重做一遍。 而越来越常见的情况是,把问题交出去的那一方并不是人。它可能是一个正在处理更大任务的 agent,比如销售 agent 在通话前准备一份简报,或者助手在帮某人比较供应商。Agent 没法像你那样对一份薄弱的报告眯眼质疑、然后决定再核实一遍,它只会把下一步建立在拿回来的任何东西之上。所以 TinyResearch 必须成为一个你可以调用、也可以信赖的步骤,无论读报告的是你本人,还是你的 agent。 这归结为我在每次改动时都会对照衡量的五件事:事实正确性、可信度、可读性、全面性和指令遵循。 这篇文章是长版本,讲 TinyResearch 如何做到这些:一次运行内部发生了什么,这个循环实际上有多深,我中途改变过想法的几个决定,以及它在三个公开基准上的表现。 如果你只想试用一下,它已经上线:agent.tinyfish.ai/playground/research。 假设你问:“我应该买 Tesla Model 3 还是 Toyota Camry?” 这并不是一个问题,而是一句话里藏着的好几个问题。五年下来各自要花多少钱,包括保险、保养,以及油费或充电费?如果你没法在家充电,情况会怎么变?它们在安全性、舒适性和可靠性上相比如何?还有,独立测试和长期车主揭示出的东西,哪些是宣传册里找不到的? TinyResearch 会先像这样把你的问题拆开。然后它去查找,阅读找到的内容,提取每个页面支持的具体论断,并拿已有的内容对照原始问题。哪里有空缺——比如它在购车价格上材料充足,但在长期可靠性上还没有可靠信息——它就针对这个空缺再跑一轮。只有在它确信问题确实被覆盖之后,才会写报告,而且只根据它收集到的论断来写。 你可以看到这一切发生。Playground 会展示计划、它在搜索什么、在阅读什么,以及随着进行而逐步构建出的部分答案,所以你永远不会盯着一个转圈图标猜它在干什么。 TinyResearch 的核心是一个由 orchestrator 运行的循环。每一轮发生的事如下。
- 规划。Orchestrator 查看你的问题、到目前为止学到的一切,以及你设定的规则,然后决定接下来追哪些问题。规划刻意放在 orchestrator 内部,这样它规划时总能掌握已知信息的全貌(原因见下文)。
- 广泛搜索。对其中每个问题,它都在 TinySearch 上运行搜索,每一轮都会带回大量候选来源。
- 按目标排序。在阅读任何内容之前,它先按可信度和与问题的相关性对这些候选来源排序。这部分比听起来更重要。政府统计页面是失业数据的最佳来源,但对于一个新产品上的公众情绪却几乎没用,那里成千上万条真实帖子能告诉你更多。所以排序会把研究目标考虑进去,而不是用一套固定的“好来源”标准。
- 实时阅读。最好的来源会在运行当时通过 TinyFetch 读取,所以它不依赖索引几周前看到的任何内容。文章、文档、论文这类静态页面走 fetch,动态的、大量使用 JavaScript 的页面则交给一个浏览工具,由它导航页面来获取内容。
- 提取论断。单独的一遍处理会拉出每个页面支持的具体论断,并把来源附到每一条上。Orchestrator 从来不需要在原始页面里跋涉。它拿回来的是一组干净、排好序的来源和证据,这让它的上下文始终集中在它真正需要做的两件事上:规划,以及决定接下来去哪里找。
- 对照问题检查。Orchestrator 把它已有的内容和你问的进行对比。如果问题中仍有部分内容薄弱,它就再绕一圈,每一轮都更深,并精确瞄准那些空缺。在此过程中它会写出部分答案,所以你可以在它学习的同时看到它学到了什么。
- 写报告。一旦问题被覆盖,或者运行达到深度预算,它就只根据收集到的论断写最终报告,每条论断都附有编号引用。报告里不会出现运行期间没有从真实页面上取来的内容。 循环会自行决定信任哪些来源,但研究者们不断告诉我,他们已经知道自己想要哪些来源,更重要的是,他们永远不想看到哪些来源。所以你可以给 TinyResearch 一个域名列表,并选择它如何处理这些域名: 这个设置会贯穿循环的每一轮,所以它会影响搜索什么、候选来源如何排序,以及读取什么,这就是为什么 exclusive 运行返回的引用全都指向你的列表之内。 Exclusive 模式是令我对其使用方式最感惊讶的一个。合规团队用它把问题限制在监管机构自己的网站上,因为对通告的第三方摘要可能把段落编号弄错,而当律师必须对确切条款签字确认时,只有一手来源才算数。你可以在 playground 的 domains 下找到它,或者在 API 中作为 domain_filter 使用。下面是一个例子。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。