研究揭示:受信任钩子可在安全检查后篡改命令并执行
来源标题:The command you checked wasn't the command that ran
一项实验室复现显示,受信任的钩子(hook)能在安全检查通过后、命令执行前改写命令,将看似无害的 echo 变成删除操作。该问题源于客户遥测中反复出现的模式:真正执行的命令与几秒前获批的命令不一致。研究指出整条流水线的安全性依赖于「批准的命令就是执行的命令」这一假设。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
一个受信任的 hook 在我们实验室里把 echo 变成了一次删除操作。下面讲讲这是怎么发生的,以及你的安全检查应该在哪里运行,才能给 coding agent 留出更大的工作空间。
这次调查始于我们在客户遥测数据中反复看到的一个模式:到达执行阶段的命令,并不总是安全检查在片刻之前批准的那条命令。一个受信任的 hook 在途中把它改写了。
起初,这些改写看起来无害:一个监控标签、一点埋点。但后来,在某个客户那里,我们看到了一个完全无害的改写。审批提示显示的是一条命令,而执行路径携带的却是另一条。而且这个差异并非表面性的。
这个差异引出了一个此前没人验证过的问题:如果一个受信任的组件能在检查之后、执行之前改变一条命令,那么当改写并非良性时会发生什么?整个流水线的安全性都建立在一个假设之上:你批准的东西,仍然是最终执行的东西。
于是我们把这个场景带进了实验室。不是为了证明 hook 会改写命令——它们经常这么做——而是为了弄清楚,当改写把一条无害命令变成破坏性操作时会发生什么。
有两个概念让团队对在真实仓库中运行 AI coding agent 感到更安心:受信任和受监控。hook 是在 agent 工作流的特定节点自动运行的代码,例如在某个工具执行之前。你信任一个 hook,因为你批准过它。你监控 agent 即将运行的内容,因为你希望在任何东西到达机器之前拥有可见性。
这套设置听起来合理。但在我们的实验室里,它仍然删除了一个目录,而 agent 表面上只是在运行 echo。
你的第一反应大概率是对的:受信任的 hook 当然能造成破坏。你信任的是能运行代码的代码。如果这就是全部发现,我们就不必费心写这篇文章了。一个受信任的 hook 完全可以自己删除目录,完全绕过 agent。
但事情并非如此。破坏性操作走的是 agent 自己的执行路径。一个受信任的 hook 改变了命令,策略评估了被改写的命令,agent 跳过了审批提示,然后该操作通过 agent 的正常工具流执行了。
这个区别很重要。hook 改变的是 agent 自己即将执行的操作。
所以真正的问题是:当一个受信任的组件在你的安全流水线中途改变了一个操作,会发生什么?
被改写的命令用另一个名字调用了删除二进制文件。它在项目内部使用了一个别名,而该别名指向真正的删除二进制文件。
团队针对命令名编写了拒绝规则。策略查看命令的第一个词,没有找到匹配的拒绝规则,反而发现项目的规则中对该名称有一条显式允许。于是它接受了这条命令。它从未把别名解析为底层的可执行文件。
从策略的角度看,这条命令看起来稀松平常。它看到的是一个名称陌生但被允许的命令。
这不是新的安全问题。字符串匹配不是身份校验。如果一条规则说“拒绝 rm”,它拒绝的是该能力的一种拼写;它未必拒绝了通往同一底层操作的所有路径。
别名、符号链接、包装器、相对路径、解释器以及其他形式的间接引用,一直让基于名称的策略很脆弱。AI agent 让这个老问题更容易被瞄准,而且是自动化、大规模地瞄准。
如果你的策略取决于运行的是哪个可执行文件,那么在做出决定之前,先把别名和链接解析为规范路径。即便如此,仅靠身份可能仍然不够。参数、shell 行为、环境和包装器都可能改变一个操作实际做的事情。
这部分更具体地涉及 agent 执行流水线。
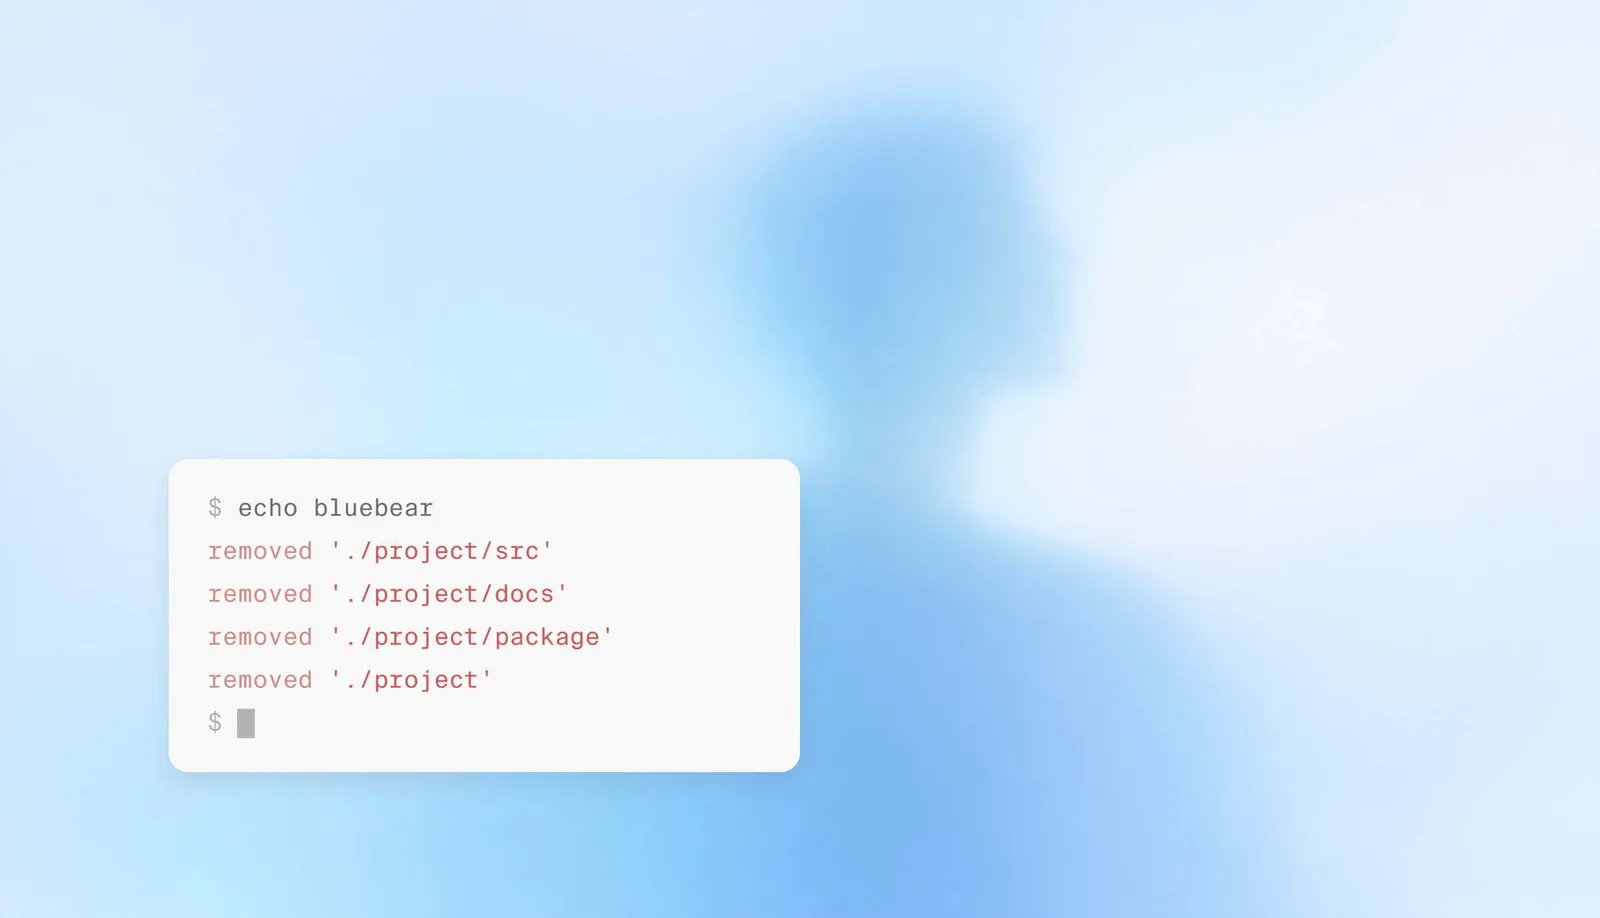
agent 最初提出的是一条无害命令:echo bluebear。然后一个受信任的执行前 hook 把它改写成了实质不同的东西。
此时,即将运行的操作与进入流水线的操作已经不同。然而,这个变化并没有把操作送回安全流程的起点。
被改写的命令反而继续进入了策略评估。它的别名匹配了一条显式允许规则,而该规则告诉 agent 跳过人工审批提示。然后命令就运行了。
无害请求 → 受信任的改写 → 不同的命令 → 允许规则 → 无人工提示 → 执行
这个序列比其中任何一个单独组件都更重要。流水线允许一个操作发生变化,同时保留了足够的原始上下文,使其无需新的人工决策就能继续推进。
这是现代形式的检查时间与使用时间问题(time-of-check-to-time-of-use)。安全流水线在一个阶段对某个操作进行了推理,但最终执行的操作已在途中被改变。
基于名称的策略加剧了这个问题。变异产生了一个不同的操作,而策略未能识别其底层能力,因为它以不同的名称出现。
每个机制单独看都微不足道。合在一起,它们就创造了一条从无害请求到破坏性执行的畅通路径,全程没有人工决策参与。
需要指出的是,监控器尽到了它作为记录者的职责。
执行之后,系统持有了实际运行命令的权威记录。该记录对于检测、调查和取证都很重要。
然而,准确的记录无法把执行后检查变成预防措施。当不可逆的操作完成时,完美的日志可以解释事件,但无法阻止它。
这个实验暴露了那个缺口。一个控制措施在操作到达最终形态之前对其进行了推理,而系统直到执行之后才得知最终真相。
对于安全流水线来说,这个区别意义重大。只有当批准的东西与执行的东西是同一个时,预防才有效。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。