研究者用权重空间编程将神经量子态迁移至更大晶格
来源标题:Weight-space programming a neural quantum state
研究者将 MIT 的权重空间编程(WSP)技术用于 J1-J2 模型训练的神经量子态,成功把 10×10 晶格的模型迁移到最大 18×18 晶格且无需重新训练。首次直接迁移失败,Opus 定位到注意力、输出头和相位中三处依赖尺寸的假设,修复后迁移可行。仅用 WSP 精度落后已发表最优约 2-4×10⁻³/格点,加数百步微调和一次 Lanczos 步骤后,14×14 追平最优、18×18 差距缩至 5×10⁻⁵/格点。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
我一直想找个理由研究神经量子态(NQS)。MIT 最近关于权重空间编程(WSP)的工作,似乎是个不错的切入点。我和 Opus 合作,把 WSP 技术应用到一个 NQS 上——这个网络在 10×10 自旋晶格上训练,用的是阻挫 J1-J2 模型,J2/J1 = 0.5,属于困难区间。目标是把网络迁移到最大 18×18 的更大晶格上。直接迁移失败了,Opus 把失败原因追溯到网络中注意力、输出头和相位这三处依赖尺寸的假设。显式修复后,无需训练即可完成迁移,并为短时间的微调提供了有用的起点。仅靠权重空间技术,在较大晶格上,每格点能量与我所找到的最佳已发表值相差约 2-4×10⁻³,这有意思但谈不上有竞争力。加上几百步训练和一个标准技巧(一次 Lanczos 步骤)后,在 14×14 上追平了最佳已发表能量,在 18×18 上每格点差距缩小到 5×10⁻⁵ 以内。项目耗时约两天,花费几百美元云 GPU 时间。AI 披露:这项工作的核心就是让 AI 尝试对已有的训练好的网络做“手术”,所以 Opus 制定了调查和干预的议程,并完成了所有工作。我负责监督、提建议、批准 GPU 开销等。以下内容主要是 Opus 报告其方法和结果,为可读性做了编辑。
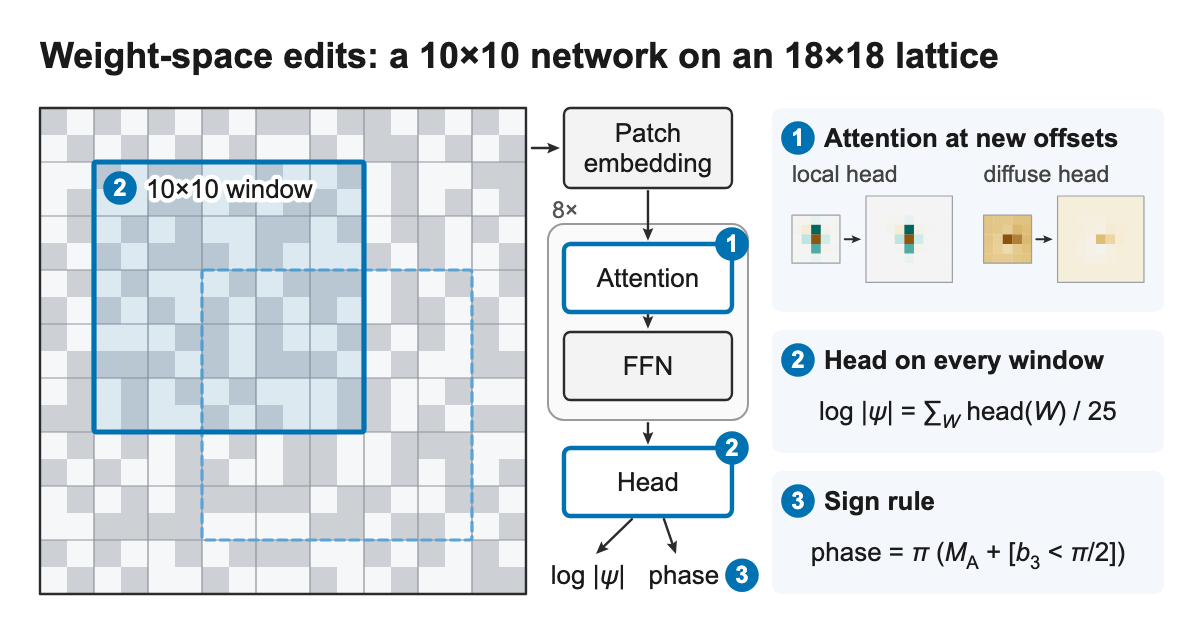
(a) 对 10×10 网络的三处修改。(b) 使用原始输出头和修改后的输出头时,网络赋予无序构型的振幅比有序构型低多少(每格点)。(c) 从我们修改后的网络、朴素拷贝和随机权重出发,在 14×14 上微调时的每格点能量。插图放大了我们接近最佳已发表能量的那次运行。(d) 在每个晶格尺寸上,我们的每格点能量比最佳已发表值高多少——分别对应仅做修改、微调之后、以及一次 Lanczos 步骤之后。
基础网络是 Rende、Viteritti 等人(Commun. Phys. 2024)发布的 Vision Transformer NQS。它约有 435k 参数,把 2×2 的自旋块当作 token,输出给定自旋构型的波函数振幅和相位。它只在 10×10 晶格上训练过。把它的权重原样拷贝到 14×14 晶格上(加上 Marshall 符号),初始采样估计约为每格点 −0.39(以 J1 为单位)。这与最佳已发表的 14×14 能量 −0.4967 相差甚远。我们通读权重,寻找依赖晶格尺寸的部分,找到了三处。每一处都用手写的替换方案处理,使网络在 10×10 上几乎保持原样。迁移规则不需要额外训练,也不需要新拟合的权重。
注意力头混合各 patch 时使用的权重只依赖于它们之间的偏移量,而更大的晶格会有网络从未见过的偏移量。主要关注邻近 patch 的头在新偏移量上权重为零。其他头则把平均权重分摊到这些偏移量上。
输出头以层归一化结尾,这限制了 log 振幅的最大值,与晶格尺寸无关。无序自旋构型的数量随尺寸指数增长,所以在大的晶格上它们会淹没有序构型(上图 b)。我们把单一输出头替换为将原始 10×10 头应用到晶格上每个与 patch 对齐的 10×10 窗口,把结果求和,再除以 25。
在 10×10 上,网络的相位遵循一条简单规则,误差在约一毫弧度以内:Marshall 符号,加上一个由一个隐藏单元控制的符号翻转。Opus 发现这个隐藏单元时相当惊讶。在更大的晶格上,网络自身的相位会发生漂移,所以我们把这条规则显式写了出来。在修复振幅之后,这个相位误差就是晶格增大时仍然恶化的主要部分。
应用这些修改后,我们用普通的变分蒙特卡洛和 MinSR 优化器对修改后的网络进行微调。窗口化实现增加了一个单独的头拷贝和掩码数组,它们在微调期间更新。我们给 10×10 权重的朴素拷贝(带 Marshall 符号)和随机权重相同的 300 步训练预算(上图 c)。我们的网络训练平稳。朴素拷贝的采样从未稳定下来,所以我们无法给它分配能量,而从零开始训练则直接发散了。
把我们的 14×14 微调跑到 500 步,再加一次 Lanczos 步骤,得到 −0.49675(3)。最佳已发表的 14×14 能量是 −0.49674,同样是网络加一次 Lanczos 步骤。我们的低 1.3×10⁻⁵,即 0.5σ,所以算是打平。
我们在其他尺寸上跑了同样的流程,12×12 和 16×16 用 300 步训练,18×18 用 600 步。仅 WSP 修改是指发布的网络加上三处修改、不做训练。最佳已发表值来自一个 ResNet(12×12,Chen & Heyl 2024)和一个 CNN(14×14 和 18×18,Liang 等人 2023),各自加一次 Lanczos 步骤,以及一个未加 Lanczos 步骤的 CNN-MPS(16×16,Fan 等人 2026)。12×12 的值是从 Chen & Heyl 论文中的一张图上读出来的。最后一列是我们的 Lanczos 结果减去最佳已发表值。
通读权重很快就发现了问题。振幅上的 LayerNorm 上限在一次约十秒的 CPU 检查中就暴露了。MIT 的文章发现,编辑可以移除障碍,但不能增加能力,这与我们观察到的一致。对收敛的 10×10 网络进行编辑从未在 10×10 上改善它,所有收益都来自让它已经知道的东西在更大的晶格上发挥作用。
Lanczos 步骤比我们预想的更需要小心。波函数有一个节点,某个隐藏单元的因子在那里穿过零,Lanczos 估计被该节点附近的稀有样本主导。我们最初的 14×14 估计看起来像是明显的纪录,然后随着更多样本进来,单个样本就能让它移动约 1×10⁻⁴。从一个在该节点附近提高概率的引导分布采样,再重加权回原始波函数,得到的增益更小,但随着样本增加保持稳定。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。