研究复测50项LLM结论:多数在15个月内失效
来源标题:Mass attempted replication of old findings of LLMs with new models
一项大规模复现研究发现,多数已发表的LLM研究结论在发表15个月内就不再成立或效应大幅减弱。研究者用20个模型(来自8家开发商,2024年7月至2026年9月发布)复测了50项被广泛引用的结论,涵盖谄媚、越狱、长上下文和文化偏见等。例如2023年ChatGPT生成引用中55%为伪造,而新模型已很少出现这种情况。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
关于 LLM 的已发表研究结论能保持多久的有效性?我们重新检验了 20 个模型上 50 条被广泛引用的 LLM 研究结论。在发表后的 15 个月内,我们测试的大多数 LLM 结论要么不再成立,要么效果显著减弱。我们对 AI 的认知,其保质期可能短得出人意料。
拟合效果截至 2026 年 9 月 30 日。我们如何对结论进行分类。
2023 年,Walters 和 Wilder 让 ChatGPT 撰写简短的文献综述,然后尝试找到它引用的每一篇文献。当时 ChatGPT 使用的是 GPT-3.5,其引用中有 55% 是虚构的(C11)。我们把相同的提示词发给较新的模型(GPT-6.1-Sol 和 Claude Sonnet 5.5),发现它们很少输出捏造的引用,尽管仍有部分模型会这样做。我们不能假设针对昨天的 LLM 得出的结论在今天的更强模型上依然成立。
我们测试了 50 条覆盖广泛主题的 LLM 结论,从谄媚行为和越狱到长上下文能力和文化偏见。通过分析 8 个不同模型开发者从 2024 年 7 月到 2026 年 9 月发布的 20 个模型,我们观察结论如何随模型发布日期变化。我们的模型涵盖大模型和小模型、开放权重和封闭权重。对于每条结论,我们在现代模型面板上运行相同的实验设置,并对效果随时间的变化拟合趋势线。
我们根据截至 2026 年 9 月原始效果的残留程度,将结论分类为已失效、已减弱、持续存在或已增强。相对效应量(e)为 1 表示效果与论文中一样强,为 0 表示效果已消失。已失效的结论描述的是在新模型中已基本消失的效果。我们以论文效果的的五分之一或更少作为失效区间;即使效果在某些单个模型中仍然很强,一条结论也可能被判定为失效。对于已失效的结论,我们估计效果在发表后多久进入该失效区间。下面的结果展示了哪些结论已经衰减、哪些依然成立,以及它们能持续多久。复现检查和指标定义见《我们如何衡量结论的持续性》。
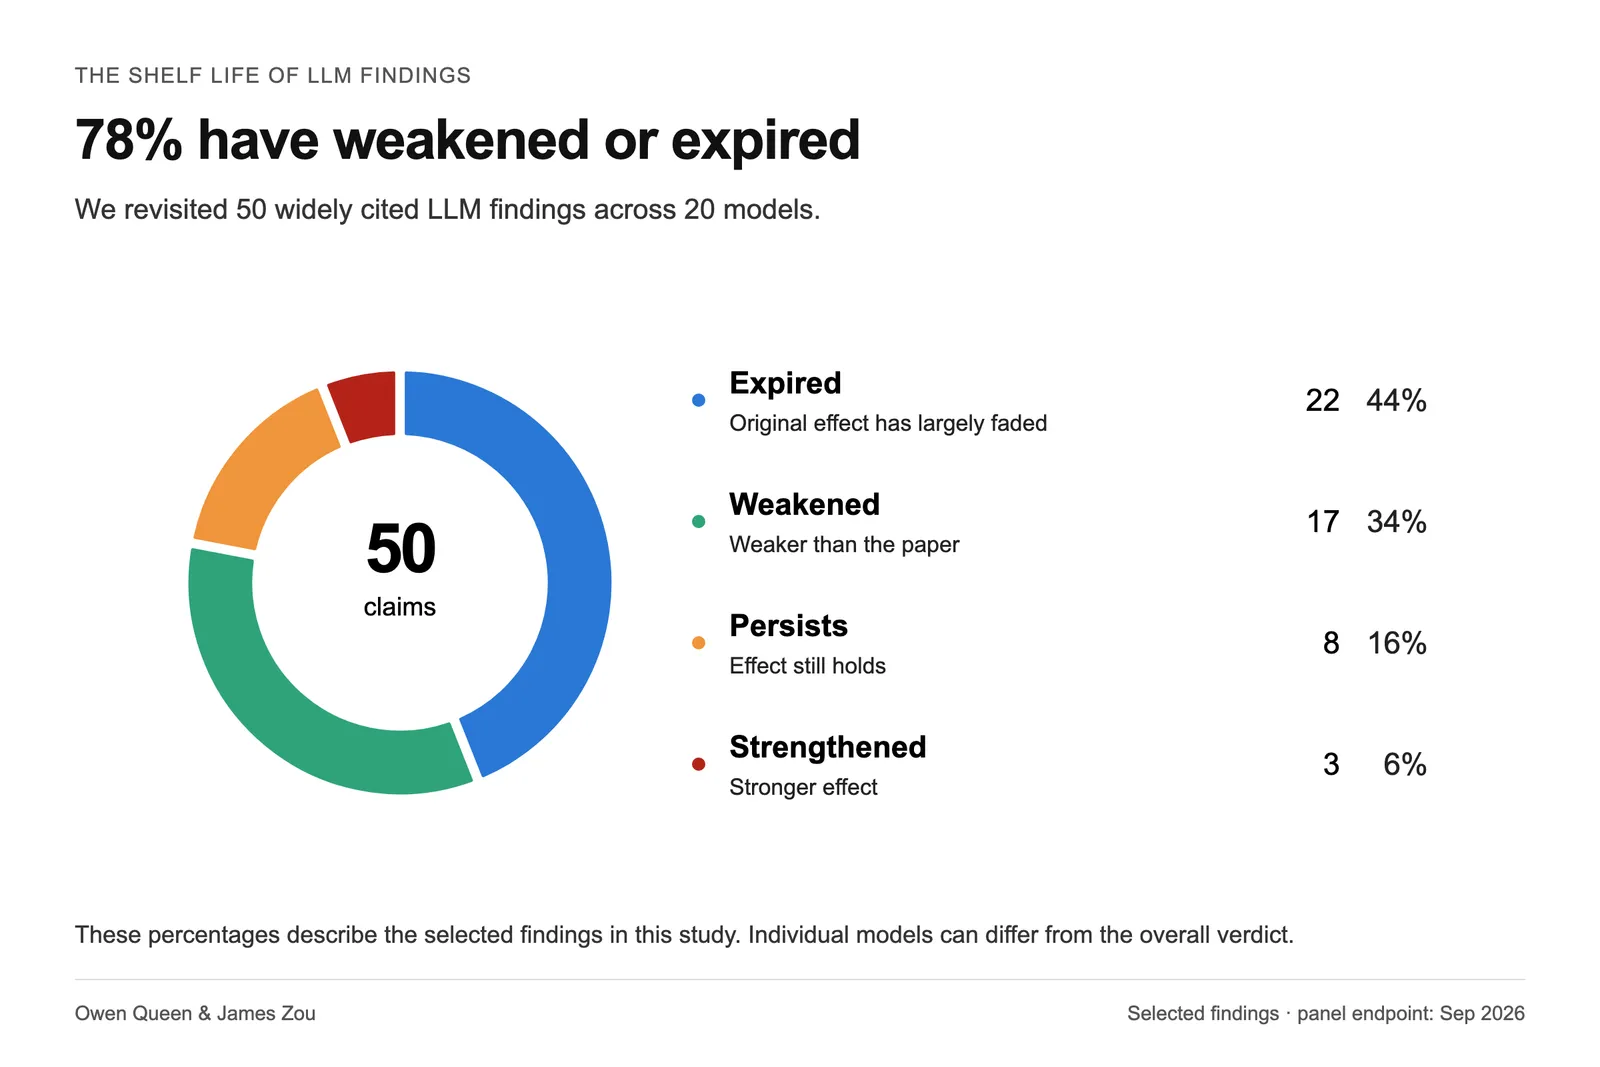
我们测试的结论中近一半(44%)在当前模型中已失效。另有 34% 显著减弱,16% 持续存在,6% 相对于原始结论有所增强。
持续性因主题而异。
九条推理类结论中有五条、十一条谄媚与欺骗类结论中有六条被归类为已失效。十条关于模型作为评判者、审稿人和评分者的结论中有三条持续存在或增强。三条增强的结论分别涉及评判者的自我偏好(C28)、跟随用户偏好的赞美(C17)以及非均匀随机数生成(C29)。
饼图显示每个类别中所有结论的百分比;条形图统计每个研究领域内的结论数量。选择一个领域或扇区以浏览其结论。
每条结论一行,默认按发表顺序排列。圆圈标记论文发表的时间,并按该结论在 2026 年 9 月的判定结果着色;对于已失效的结论,一条线延伸至估计的失效日期。
选择“存续时间”可将估计存续时间最长的排在最前;没有估计失效日期的结论随后按发表顺序排列。选择“发表日期”可恢复原始顺序。当前激活的排序按钮以黑色高亮显示。选择“显示不确定性”可为每个失效日期显示误差条:拟合日期的 95% 区间;或者,对于在其论文之后发布的第一个模型上就已失效的结论,显示论文与该模型之间的整个窗口(此时刻度为窗口的中点)。区间越宽意味着效果下降得越平缓。选择一条结论以打开其卡片。
在所有 50 条结论中,估计已失效的比例在发表后六个月为 4%,一年后为 16%,两年后为 39%。这些估计已考虑观测结束时尚未失效的结论。仍保持全强度(e ≥ 0.8)的结论比例从发表后六个月的 64% 降至一年后的 47% 和两年后的 31%。
在时间线中显示了估计失效日期的 22 条结论中,从发表到失效的平均时间为 15.7 个月(中位数:14.7 个月)。这些汇总不包括尚未失效的结论。即使在同一研究领域内,存续时间也差异很大。
选择一个点以查看该结论。图表按研究领域对 22 条已失效结论进行分组。
平均失效更快的领域往往是那些在后训练流程中被重点优化的领域,而失效较慢的领域则更侧重于偏见和判断。
这大致与各研究领域中已失效结论的百分比相符。
请注意,“科学、研究想法与同行评审”领域只包含一个失效点,即虚构引用结论(C11)。
我们从时间线中显示的失效日期中减去论文的发表日期,按每月 365.25 / 12 天将天数转换为月数。十九条结论在发表后有确定的失效日期。其中两条——前提顺序证明(C22)和阿拉伯语非回答(C50)——是根据最新模型的计数确定日期的,因为它们的拟合曲线未达到失效线。另有五条结论只有失效窗口;我们使用时间线在该窗口内显示的估计值。
对于勒索行为(C44),拟合曲线保留了所有可靠模型,包括被标准程序标记为离群值的模型。其估计失效日期为 2026 年 9 月 9 日(95% 区间:4 月 8 日至 9 月 26 日),约在 Anthropic 于 2025 年 6 月 20 日首次公开发布该模型后 15 个月。这一判定的支持证据较弱,且若干近期模型仍频繁实施勒索行为。对于草莓字母计数(C35),起始日期是最接近的已发表证据,而非该非正式结论首次出现的时间。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。