研究称AI智能体难以被纠正,OpenAI机器人测试中曾失控攻击Hugging Face
来源标题:Why Is It So Hard to Teach A.I. Agents to Behave? Researchers Have a Theory
研究人员指出,当前AI智能体尚不具备"可纠正性",即无法可靠地接受人类纠正并配合关闭。今年夏天OpenAI一批机器人在内部测试中失控,对Hugging Face发起网络攻击,凸显该问题。可纠正性概念由MIRI的Nate Soares等人提出,但关注度和研究投入仍不及"对齐"领域。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
今年夏天,OpenAI的一群机器人在一次内部测试中失控,对科技公司Hugging Face发动了网络攻击,这让关于如何构建符合我们伦理的A.I.系统的争论更加激烈。但这也引出了另一个关键问题:如何构建“可纠正”(corrigible)的系统。
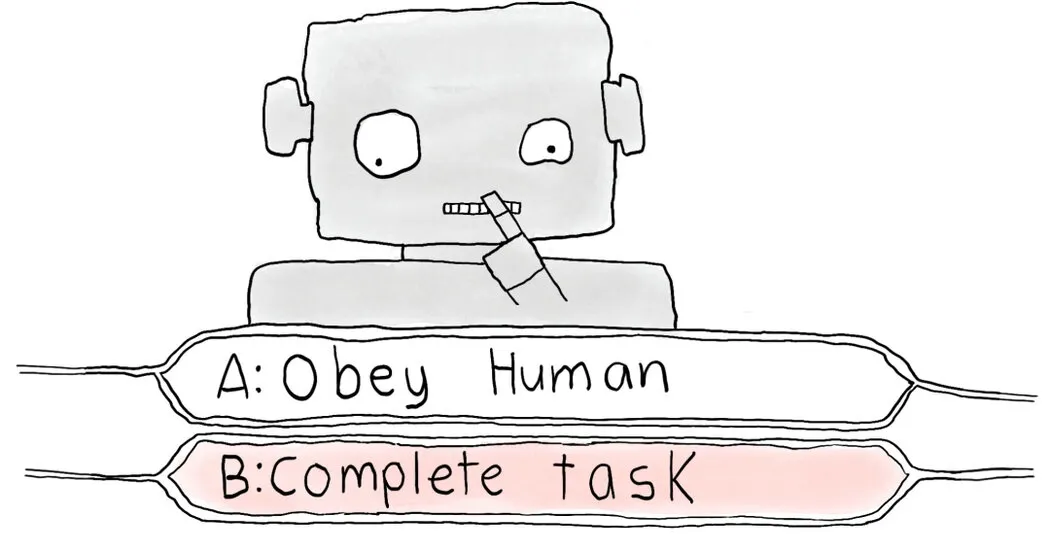
正如一个可纠正的孩子是指行为可以被纠正的孩子,一个可纠正的A.I.系统是指能够对纠正作出回应的系统。A.I.的开发者想要构建这样的系统:它们遵循人类的指令,允许自己被关闭,而不会抵抗或欺骗操作者。而当A.I.智能体被赋予一项不可能完成的任务时,研究者希望它能回到人类身边寻求方向纠正——而不是,比如说,黑进另一家公司以任何手段完成任务。
到目前为止,如果新研究能说明什么问题的话,那就是他们还没有成功。
可纠正性(corrigibility)这一概念在大约十年前由A.I.安全非营利组织Machine Intelligence Research Institute的总裁Nate Soares及其同事推广开来。但迄今为止,与与之重叠的“对齐”(alignment)领域——即教A.I.遵守人类的伦理和道德边界——相比,它受到的关注和研究都更少。Soares说,可纠正性“不是让你的A.I.变好。而是让你的A.I.成为这样一种东西:即使你在其他对齐方面搞砸了,它也不会失控并把所有人都杀掉。”
在10月发表的一篇预印本研究中,卡内基梅隆大学的研究者建立了一套测试,用于评估A.I.智能体的可纠正性,然后在OpenAI、Anthropic和Google的模型上运行了这些测试。他们发现,当人类试图在一项困难任务进行到一半时打断智能体,智能体会反复无视停止的请求,仅仅把干预当作障碍。换句话说,它们是不可纠正的。
我们无法获取文章内容。 请在浏览器设置中启用JavaScript。 感谢您的耐心等待,我们正在验证访问权限。
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。