GitHub 发布新 Git 存储架构,支持每秒数千次写入
来源标题:Inside GitHub’s new Git storage architecture
GitHub 公布新 Git 存储架构,内部测试已能支持 5000 个并发智能体操作同一仓库、每秒 7200 次推送,同时保持读取低延迟。该架构遵循最小化协调与存储计算解耦两项原则,是 GitHub 支撑大规模智能体开发的基础。
以下正文由 AI 翻译自 GitHub Blog(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
上周在 GitHub Universe 上,我们公布了全新的 Git 存储架构,它每秒可处理数千次写入,读取能力可按需扩展。通过内部测试,我们已证明能够支持 5,000 个并发 agent 在同一个仓库上工作,每秒向一个仓库发送 7,200 次 push,同时以稳定的低延迟处理读取流量。这一新架构是 GitHub 支持数亿开发者进行 agentic 开发的基础,而我们是在 GitHub 持续运行的同时,在其底层构建这套架构的。
过去一年里,agent 改变了 GitHub 上繁忙仓库的面貌。在本系列的第一篇文章中,我们阐述了下一代 Git 存储架构背后的两条原则:最小化协调,以及将存储与计算解耦。在上一篇文章中,我们介绍了过渡方案:将 99.99999% 的仓库迁移到 Azure,把写入 quorum 的范围限定到单个 reference,并搭建由 Azure Blob Storage 支持的虚拟副本。
我们在上一篇文章结尾还留下了一个观察:一次写入中需要排序的部分非常少。Git object 是不可变的,并且以其内容命名,这意味着两个写入者可以同时存储它们,而无需就任何事情达成一致。一次 push 中需要达成一致的部分是 reference 更新,而 reference 更新相比之下非常小。虚拟副本是围绕这一点进行构建的第一步,也是我们将仓库接入新架构的手段。
架构的其余部分就建立在这一观察之上。只有 reference 更新需要达成一致。这使得 Git 基础设施中过去紧密耦合的部分(存储数据、处理请求、维护仓库)可以独立扩展。对开发者而言,Git 依然是 Git:他们以同样的方式 push、fetch 和 branch,同样的保护机制依然生效。下面,我们将梳理设计背后的需求,跟踪一个请求在系统中的流转过程,并深入剖析其中两个组件。
为 agent 规模而构建
我们从两个维度来考虑 GitHub 平台的规模:
- 水平扩展是指有多少开发者和 agent 能够在众多仓库上工作。GitHub 目前在这一维度上的许多做法已经过多年的实战检验,并将延续到新架构中:跨基础设施的租户分区、租户流量的隔离和/或公平性保障、负载感知路由,等等。
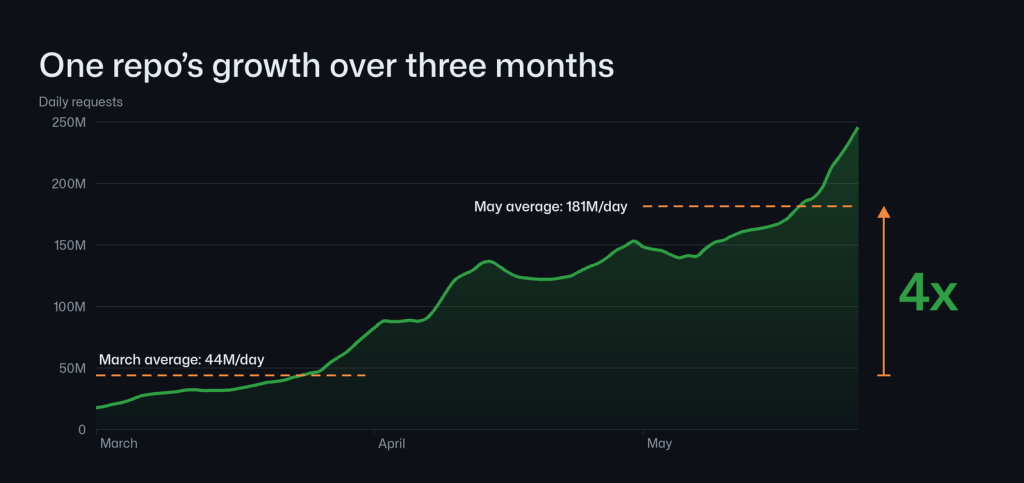
- 垂直扩展是指有多少开发者和 agent 能够在同一个仓库上工作。随着 agent 编写更多代码,我们预计单个仓库会变得更大、更繁忙,因此我们的大部分需求都来自垂直维度。 如今,GitHub.com 上最繁忙的仓库每秒最多接收几十次写入,通常以短时突发形式出现。随着越来越多的工作转移到并行运行、全天候不间断的 agent 上,我们预计这些突发将在未来一年内变成持续速率。每次 push 都会带来更多读取:CI 运行、部署系统拉取新 commit,其他 agent 获取它以作为上下文。这种读取扇出对整体流量产生巨大的放大效应,并随写入量而扩展。 我们已经在处于曲线顶端的仓库上看到了这一趋势。下图展示了一个 GitHub 仓库从 3 月到 5 月的每日请求量,其间其流量增长了约 4 倍。此后,它的增长一直呈指数级轨迹。 我们必须为一个 agent 驱动的开发持续以这种速度加速的世界做规划。我们没有按下一个增量来做规划,而是设定了至少两个数量级更高扩展能力的目标。对于单个仓库,这意味着新架构需要:
- 每秒接受数千次写入。
- 支持多个写入节点。原因有二:
- 经验告诉我们,为传入的 pack 建立索引和检查 object 连通性是写入中 CPU 开销最大的部分,而且这一开销随写入大小而扩展,因此单个节点很快就会受限于计算能力。
- 将这项工作分散到多个节点上可以提高容错能力,并在节点故障时缩短恢复时间。
- 最小化 commit 延迟。agent 会等待每次 push 完成后才进入下一步。
- 按每个 reference 记录变更顺序,并能够快速跨 reference 进行线性化。落后的虚拟副本需要只下载处理传入请求所需的数据就能追上。
- 在没有任何变化时保持读取开销低廉,鉴于读写比例,这是常见情况。
- 让每个组件独立扩展。 除此之外,系统还必须能够提升整体可靠性并在全球范围内扩展。
介绍“Project Rubicon”
2026 年 5 月,紧接初始 Azure 迁移之后,我们开始着手设计能够满足这些需求的方案。我们尝试了多种方法。在所有这些方法中,pack 数据都存放在 Azure Blob Storage 中,在部分方案中我们还尝试将 reference 状态也放在那里。下面我们会介绍发现的一些取舍,但最终我们确定了一个我们认为能在最大化吞吐量的同时,保持 GitHub 这样的平台所要求的正确性、持久性、可用性和延迟保证的设计。我们称之为“Rubicon”,以此致敬行业在 agentic 开发上跨过的那个不归点。 让我们自顶向下地梳理 Rubicon。许多东西保持不变:来自 Git 客户端、API 和 Web UI 的请求到达 Spokes,它仍然负责路由和负载均衡,并提供 GitHub 其余部分用来读写仓库数据的内部 API。Spokes 还保留了其作为放置与均衡服务的角色,维护水平扩展所需的分区、隔离和租户公平性。相比之下,Spokes 之下的数据平面则是全新的。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。