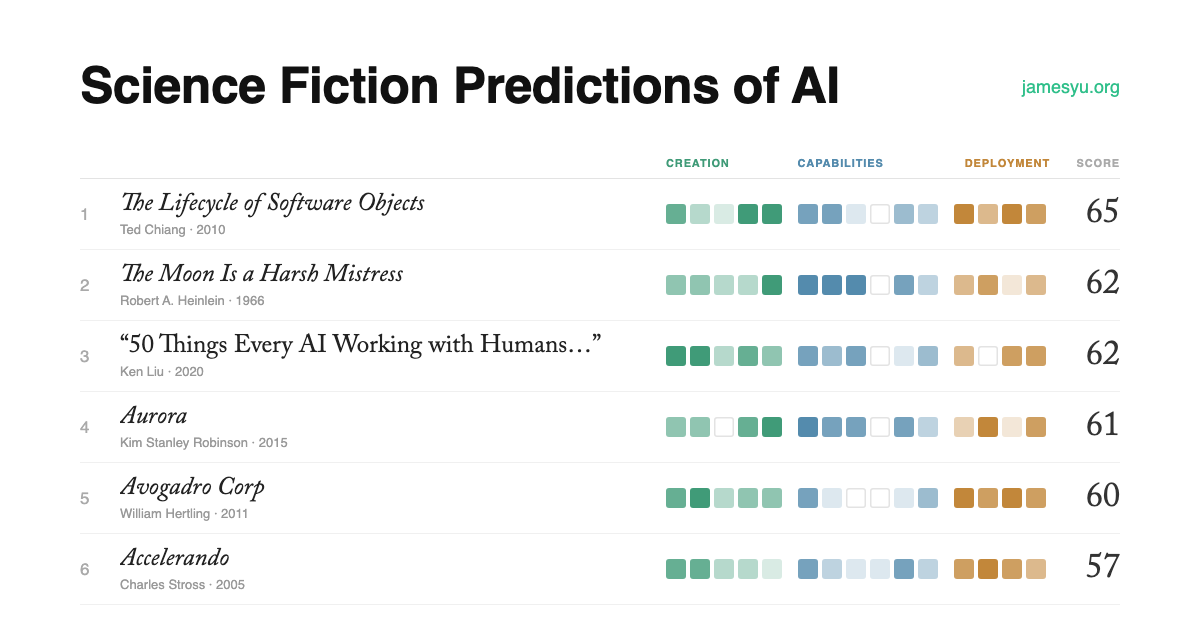
科幻作品对AI的预测准确度如何
来源标题:How accurately did science fiction stories predict AI?
分析指出科幻作品对AI的预测几乎没有触及学习范式、训练数据、规模扩展、人类反馈等关键维度,各维度评分均不超过3分。《终结者》等电影聚焦自主武器和杀手机器人,未描绘当今AI经由聊天界面、创意产品和办公工具落地的路径。
以下正文由 AI 翻译自 Hacker News(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
没有一项得分超过3分。在学习范式、训练数据、规模扩展、迭代、人类反馈、能力不均衡、创作质量、研究发现、顺序与节奏、界面/分发、经济、社会变革等方面,均无涉及。
在1984年的电影中,Kyle Reese说防御计算机“变聪明了”,并判定人类是威胁。Skynet获得自我意识的明确叙述属于1991年的续集,而非本片。电影没有花多少时间讲它是如何被建造的、从什么数据中学习,或者工程师如何改进它。它几乎没有告诉我们,产生当今助手的语言学习路径是什么样的。
Terminator可以追踪目标、在物理世界中导航,并模仿人类语音到足以欺骗人的程度。这是令人印象深刻的具身能力,但它不是一个写小说或做数学的对话模型。这部电影并不是在试图预测这些技能实际出现时那种不寻常的顺序。
在这里,AI通过军事指挥系统和杀手机器人变得强大。这是对自主武器的生动警告,但不是通过聊天界面、创意产品和办公工具让现代AI获得最广泛采用的那条路径。这里的低分并不能说明这部电影作为惊悚片的优劣。
这些分数都不是机械测量。中等置信度的作品需要更仔细地阅读原始文本。较晚的比较对象(2017年及以后)会被标记;在底层技术已经存在之后再预测某事,是另一种成就。
每部作品都会根据情节与AI现实的对应程度打分。65分并不意味着作者65%的预测成真。通常低分只是说明故事聚焦于一个狭窄想法。
有三个问题,权重偏向许多作者通常会跳过的一个:AI最初是如何被建造出来的。
每个问题都拆成具体维度,共十五个,每个维度按0到5打分。
关键预测是:机器通过从示例中学习而变得有用,而不是由人为它写出每一条规则。给我看它接触到什么——书籍、对话、演示——以及这如何改变它所能做的事情。
一个从文学中学习语言的神经网络,比一台只是被称为天才的计算机更接近真实故事。5分意味着学习是机制的核心。3分可能是识别到了学习,却没有很好地解释它。一台手工打造的写诗机器可以在输出上很有远见,却仍然错过真正奏效的方法。
不计分:机器只是被称为“智能”
它的智能从何而来?一个强有力的故事会把人类信息作为答案的一部分:对话、书籍、图像、录音,或人们行为的记录。
更好的情况是,数据解释了技能。一个用通信记录训练的系统可能变得有说服力;一个用文学训练的系统可能产出小说。但数据库并不自动就是训练集。搜索记录是一种检索预测,并不能证明机器从这些记录中学习过。我希望这种联系出现在文本中,而不是因为机器听起来很聪明,我们事后编造出来。
不计分:数据库只是可供搜索
关于规模扩展的惊讶之处在于,更多数据、计算和容量改进的可能不只是速度。它们可以改变一个学习系统能够做什么。
如果一个故事真的让我们看到这一点发生:一个更大或训练更好的版本获得了新能力,那它就能得到高分。一台只是存储更多记录的巨型计算机不算什么。机器突然醒来的魔法阈值也不算。增长应该带来能力。如果作者认识到资源的重要性,却没有假装描述了具体的transformer架构,给予部分分数是合理的。
不计分:巨型机器或魔法觉醒
真实进展是混乱的。早期系统会失败,接下来的系统会笨拙,工程师改变一些东西再试一次。
我们希望看到原型、糟糕的演示、重新训练、修订和有意义的评估。如果故事能清楚说明为什么新版本有所改进,那就更好。一次戏剧性的故障不是一个开发过程。这与B2不同:一台完成的机器可以在某些事情上仍然出色,在另一些事情上很糟糕。A4问的是,我们最初是如何得到这台完成的机器的。
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。