研究揭示训练数据中最古老的文本来自苏美尔泥板
来源标题:The Oldest Text in the Training Data
学者在20世纪80至90年代将出土泥板数字化,经扫描、传真并由亚述学家音译后录入Unicode,苏美尔楔形文字成为其中最早的文本来源。苏美尔文字最初用于记录债务和商品物流,约700年后才被用作通用信息编码系统。Claude等模型已能逐行背诵《吉尔伽美什史诗》的阿卡德语Unicode文本和英文版本。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
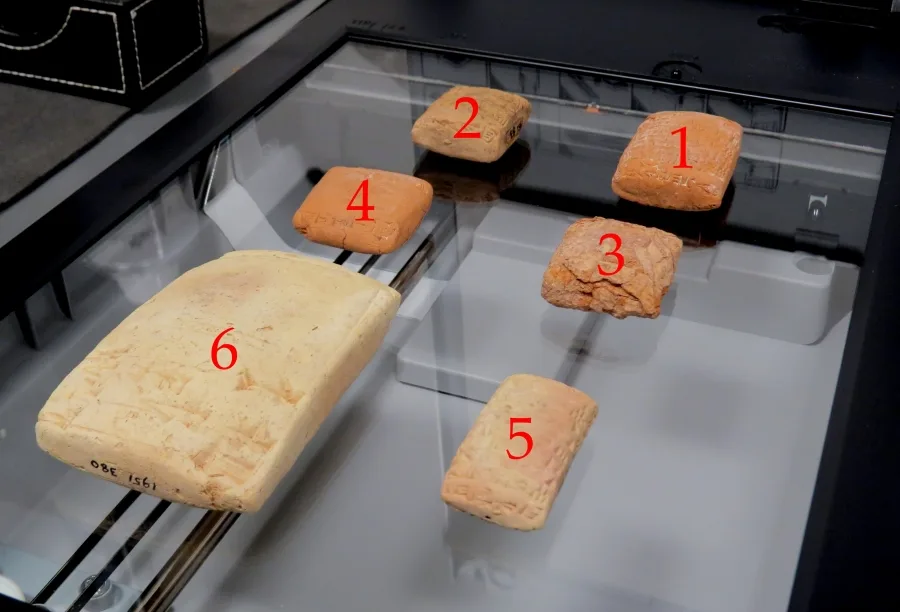
上世纪80年代和90年代,学者们将许多出土的泥板数字化。博物馆用普通的办公扫描仪扫描泥板,再传真给亚述学家,由他们进行音译转写。这些音译多少有些信息损失,于是美索不达米亚的主要文字最终被纳入了 Unicode 系统。Unicode 中一些最大的字符就来自苏美尔语。例如: 𒐫 —— 是数字 32,400 的字符 𒈙 —— 可能意为对立的国王或国王之间的战争。 其中每一个都是单个 Unicode 字符!做 QA 测试或者想把网站做得特别丑的时候,它们可太好用了。 总之,Claude 对这些语言很熟悉。尤其是它对《吉尔伽美什史诗》了如指掌,能或多或少逐行地用阿卡德语 Unicode 和英语背诵出来。 《吉尔伽美什史诗》之所以出名,不仅因为古老,更因为它优秀而有趣。还有许多苏美尔文本比它古老得多。苏美尔文字系统最初是为了记录债务、协助商品物流而发展出来的。他们花了大约700年才意识到文字是一种通用的信息编码系统。之后他们才开始用它来记录情歌、笑话和史诗故事。 最古老的文本是乌鲁克行政档案中的账目记录,写于公元前3400年至3000年之间,比“我们 Claude 的当前年份”早了约5000年。我们无法确定哪块泥板是最古老的:它们是按考古地层和笔迹风格来断代的,所以每一块都带有横跨数百年的置信区间。其中最著名的是“Kushim 泥板”。 “Kushim 泥板”上写的大致是:“交换29,086份大麦,37个月,Kushim 的最终账目”。Kushim 很可能是接收大麦的人的名字。我们相信 Kushim 把大麦酿成了啤酒。这么多大麦还能拿来做什么呢?保守估计,这么多大麦大约相当于每天900罐啤酒。由此我们可以推断,Kushim 很可能是个非常随和的人。 Claude 能用苏美尔语 Unicode 引用“Kushim 泥板”。这块泥板肯定在训练数据里。
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。