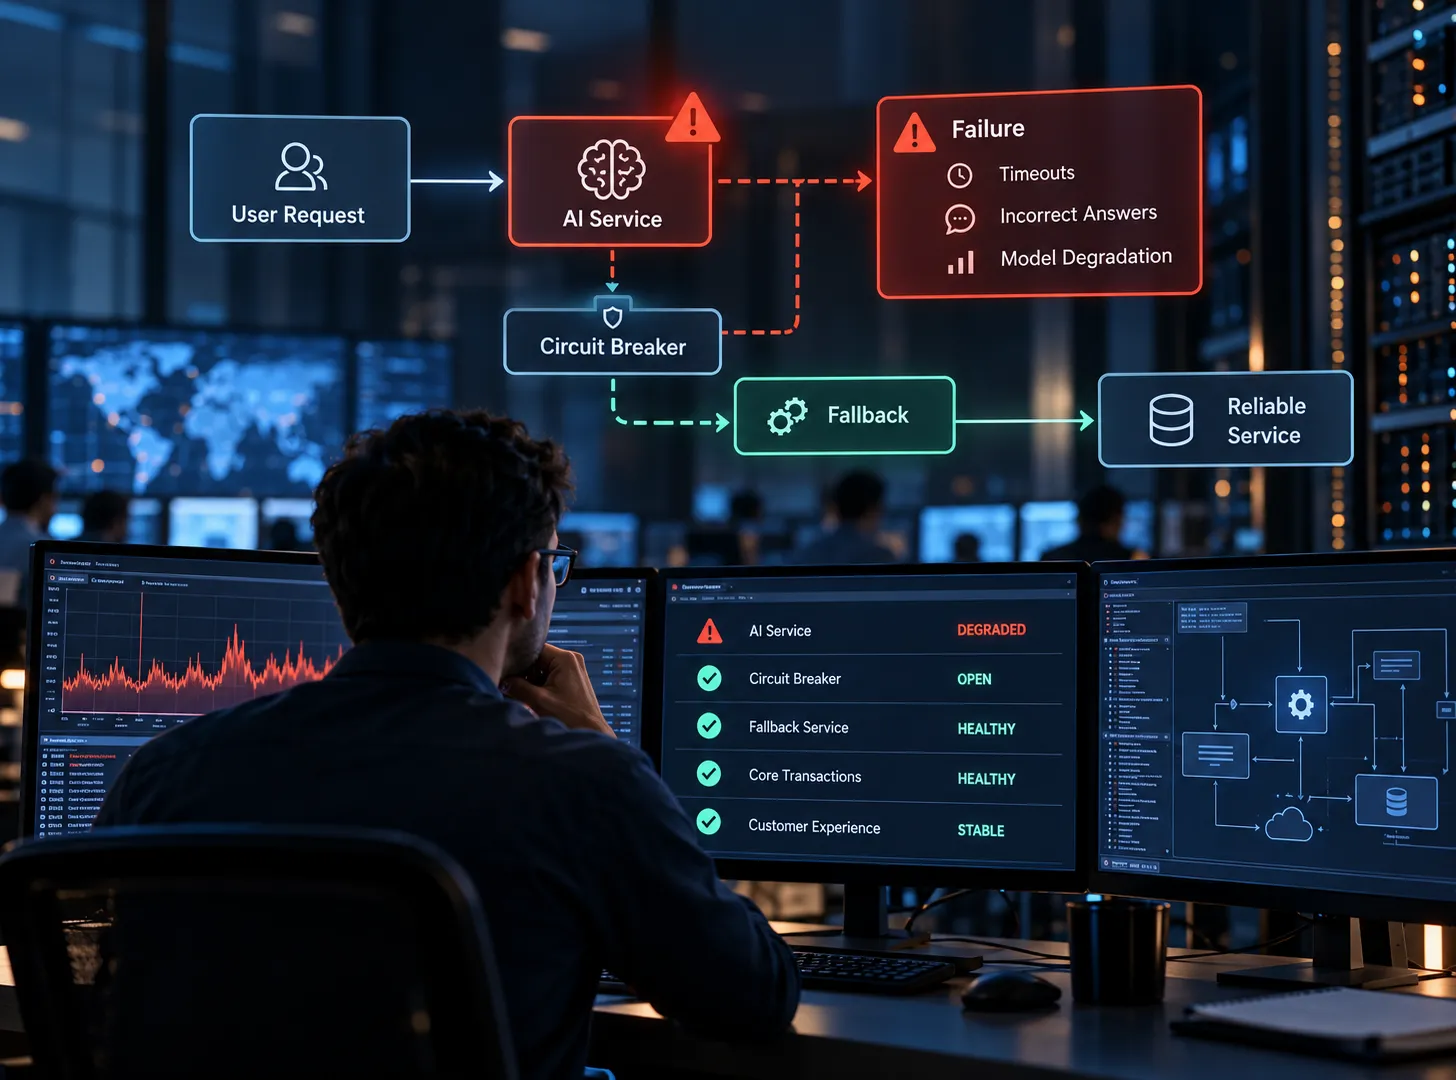
AI系统可靠性应从模型周边构建而非依赖模型本身
来源标题:When AI Fails: Building Fault-Tolerant AI Systems
文章指出,AI系统的可靠性必须来自模型周围的系统工程,而非模型本身。作者引用IEEE可信计算分类,将故障、错误与失败区分开,强调要在错误演变为失败前拦截。文章还讨论了将熔断器和舱壁模式用于AI调用时需调整,因为大模型推理延迟波动大。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
经典可靠性文献为我们提供了有用的表述。Avižienis、Laprie、Randell 和 Landwehr 在广受引用的 IEEE 可信计算分类法中,将 fault、error 和 failure 区分开来:fault 是原因,error 是错误的内部状态,而当交付的服务偏离正确服务时,就发生了 failure。在 AI 场景中,fault 往往不可见(细微的数据漂移、训练数据中的缺口、含糊的 prompt),而 error 看起来像正常响应。因此,必须在 error 变成 failure 之前将其拦住。
这就引出了本文其余部分所依据的原则:可靠性必须来自模型周围的系统,而不是模型本身。
Michael Nygard 近二十年前在《Release It!》中推广了熔断器和舱壁模式。这些模式在 AI 场景中仍然有用,但每一种都需要做些调整,因为 AI 调用与这些模式最初针对的服务调用行为不同。
大模型推理的延迟分布很宽。响应时间会随负载、输入大小、输出长度和共享计算资源而大幅变化。仅根据平均延迟设置超时,会让系统暴露在慢响应风险之下。
更好的做法是从业务截止时间倒推。如果一笔卡授权的端到端完成时间必须远低于一秒,那么 AI 步骤只能获得该预算中固定的一小段;这一小段用完,系统就跳过它继续推进。对于生成的文本,我还建议显式限制输出长度。限制输出长度有助于控制延迟,但调用仍然需要端到端的截止时间。
传统熔断器在错误率超过阈值时打开。对 AI 而言,这是必要的,但还不够。如果模型开始返回格式正确但无法通过校验的响应,常规熔断器会安然保持闭合,因为每次调用都“成功”了。
我把修复思路称为语义熔断器。它把校验失败、低置信度结果和政策拒绝,与超时和 HTTP 错误一起计数。当合计速率超过阈值时,熔断器打开,流量转向回退路径。这些信号应按用例和模型版本分别跟踪,以免一个有问题请求禁用不相关的工作流。恢复应使用受控探测,同时通过可用性和校验检查。
AI 调用慢且波动大。如果它们与核心交易处理共用线程池、连接池或速率限制,那么模型的减速就会变成所有环节的减速。舱壁模式用于隔离这些资源。在实践中,这意味着为 AI 调用使用独立池、按用例设置独立配额,并硬性规定:汇总文档的批处理任务绝不能占用关键路径上为实时用例保留的容量。
重试需要谨慎限制。重试 AI 调用在延迟和成本上都很昂贵,而且当提供商过载时,激进重试会加剧过载。Google SRE 实践和 Amazon Builders' Library 的指导直接适用:限制尝试次数,使用带抖动的指数退避,并在整个服务范围内执行重试预算,使重试量不超过总流量的一小部分。
还有两条规则是 AI 特有的。第一,不要仅仅因为不喜欢某个响应就重试;未通过校验的响应通常应进入回退路径,而不是用相同 prompt 反复发送给同一模型。任何有界的修复尝试都应符合同一截止时间和校验控制。第二,如果 AI 能执行操作,例如调用工具或更新记录,那么被重试的操作需要幂等键或其他显式机制来防止重复效应。被重试的 agent 步骤不应更新同一记录或执行同一事务两次。
经典模式保护我们免受响亮失败的影响。安静失败需要另外两种机制协同工作:校验,降低使用不可接受答案的风险;回退,决定无法校验时该做什么。
在金融系统中,我们从不因为消息到达就信任它。在它接触账本之前,我们会检查其格式、签名、金额和业务规则。AI 输出也应遵循同样的纪律。我通常把校验描述为四个层次:
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。