Sebastian Raschka 撰文解析现代 LLM 中的位置嵌入机制
来源标题:Understanding Positional Embeddings in Modern LLMs
Sebastian Raschka 发表文章,系统讲解大语言模型如何编码和处理 token 位置信息,涵盖 RoPE 等经典与当代方法。文章配有可视化示例、少量数学推导和小型 PyTorch 实现,并讨论了现代架构如何调整或省略显式位置编码,还预览了 2026 年开放权重模型的位置嵌入选择。
以下正文由 AI 翻译自 Hacker News(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
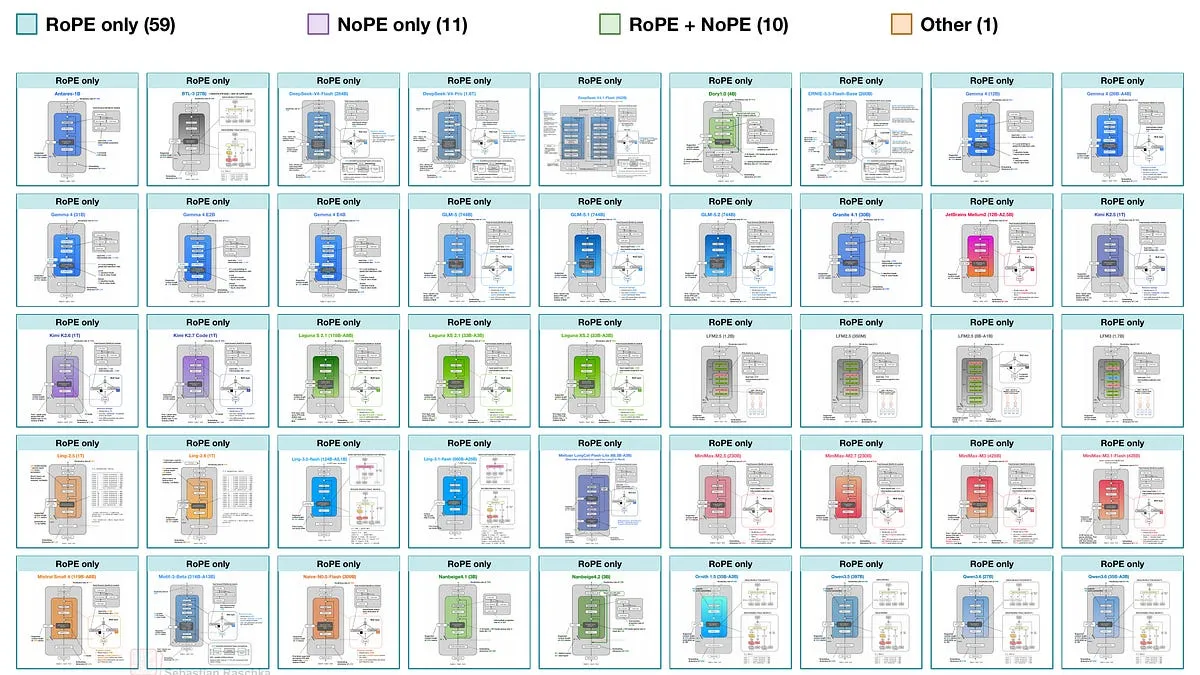
Sebastian Raschka 博士 2026年11月15日 67 4 分享 本文通过介绍 RoPE 等经典与当代方法,解释大语言模型如何编码和处理 token 的位置信息。这本质上是一段全面的旅程:我们会借助可视化示例、少量数学推导以及一个小型 PyTorch 实现,逐步梳理其机制。当然,之后我们还会考察现代架构如何调整或省略显式位置编码。 下方预览展示了 2026 年开放权重模型所采用的位置嵌入选择。我们会在讲完底层机制之后再讨论这些选择。 图 1:图库中 2026 年架构的预览,按位置编码分组。架构图取自我的 LLM 图库。 但为什么要花这么多时间撰写或阅读这个相对次要的构建模块呢?大语言模型在不断演进,而在我准备今年最新 LLM 架构趋势的新文章时,我意识到自己在此前的文章中从未涉及 LLM 所使用的位置信息方法。因此,与其让另一篇文章变得过于臃肿,我想不如把本文作为独立的构建模块先行发布,为即将到来的 LLM 架构与趋势分析做铺垫。 此外,多年来许多读者一直希望我写一篇关于相对位置嵌入(即 RoPE)的教程,作为对 GPT 中所用可学习绝对嵌入的后续补充。这件事在我的待办清单上已经很久了,所以我终于翻出旧草稿,整理成了这篇详解,其中将涵盖 近期开放 LLM 使用了哪些方法。 请注意,本文假定读者对基础 LLM 架构有一定了解,适合作为《从零构建大语言模型》的后续阅读。如果对注意力内部机制的概念与计算——尤其是 query、key 和 value 向量——还有些模糊,我建议先回顾我的自注意力详解作为复习: 理解并编写 LLM 中的自注意力、多头注意力、因果注意力与交叉注意力 2024年1月14日 阅读全文 本文技术性也很强,对一些人来说可能过于详细。不过,我确实希望把这一基础内容先发出来,供未来的文章引用。别担心,下一篇会回到更轻松的風格。 附言:我开始尝试 Substack 新的“perks”系统。作为对支持者的感谢,我已添加了架构图库的图片导出和元数据,供你们在自己的分析中使用。 附附言:如果你已经熟悉位置嵌入的工作原理,可以直接跳到第 6 节“现代架构中的位置选择”。 请注意,本文在网页浏览器中阅读可能比在邮件客户端中更好。我推荐查看这里网页版,左侧还带有导航栏。 我们从整体架构开始。分词器将输入文本编码为 token ID。接下来,LLM 的输入 token 嵌入层将每个 ID 映射为一个数值向量。我们通常把该向量中的各项称为“特征”(类似于经典机器学习)。随后,LLM 内部的 transformer 块通过注意力和前馈层修改这些向量。最后,模型的输出层为下一个 token 生成 logit 分数(转换为概率)。 下图展示了这一路径在 GPT-2(相对经典的 LLM)和 MiniMax-M3(今年发布的较新 LLM;可作为大多数其他近期 LLM 的占位代表)中的情况。如我们所见,两者架构差别不大,但在进入位置信息部分之前,我们先关注橙色块(token 嵌入层)及其上方的 transformer 块;本次讲解不需要其他架构差异。 图 2:GPT-2 与 MiniMax-M3 中的 token 嵌入层,以橙色高亮。(旁注:M3 的 60 个前馈层中前三个是稠密层而非 MoE。) 如上图所示,token 嵌入层将每个 token ID 映射为一个向量。位置信息随后被加入。具体来说,正如我们稍后将更详细讨论的,GPT-2 在修改后的嵌入进入第一个 transformer 块之前,为每个 token 嵌入加上一个位置向量。另一方面,MiniMax-M3 在每个 transformer 块内部使用一种名为 RoPE 的方法,在注意力中加入位置信息。 这些方法我们稍后会详细讨论,但首先让我们从宏观层面说明为什么需要或要加入显式位置信息。 以下面两个输入句子作为简单示例: 改变词序会改变哪只狐狸在跳,如下图所示。 图 3:改变词序会改变哪只狐狸在跳。 为简化本文示例,我们将每个词视为一个 token。(如你所知,真实分词器可能把词拆成更小的子词 token。)那么第一个句子有八个 token 位置,从 0 到 7。 图 4:玩具句子中的 token ID 与位置。
假设以下小词表。
真实词表通常有 5 万到 20 万条目
vocab = { "The": 0, "red": 1, "fox": 2, "jumps": 3, "gray": 4, "over": 5, "the": 6, (如果你对词表如何构建感兴趣,可以查看我 GitHub 上的分词器资料。) 请注意,输入句子中出现两次的“fox”在两种情况下都得到相同的 token ID 2。由于二者 token ID 相同,与在输入句子中的位置无关,它们从嵌入层得到的嵌入向量也会相同。 现在,考虑一个不带位置编码(也不带因果掩码)的常规自注意力机制,其中每个输入 token 都可以关注输入中的其他所有 token。在这种设定下,交换任意两个词(例如“red”和“gray”)仍会在每对 token 之间得到相同的嵌入和注意力分数。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。