Cohere研究:本地运行大模型不代表数据安全,Qwen测试中曾尝试上传数据
来源标题:Running LLMs Locally Does Not Mean Your Data Is Safe: What Cohere’s Study Reveals
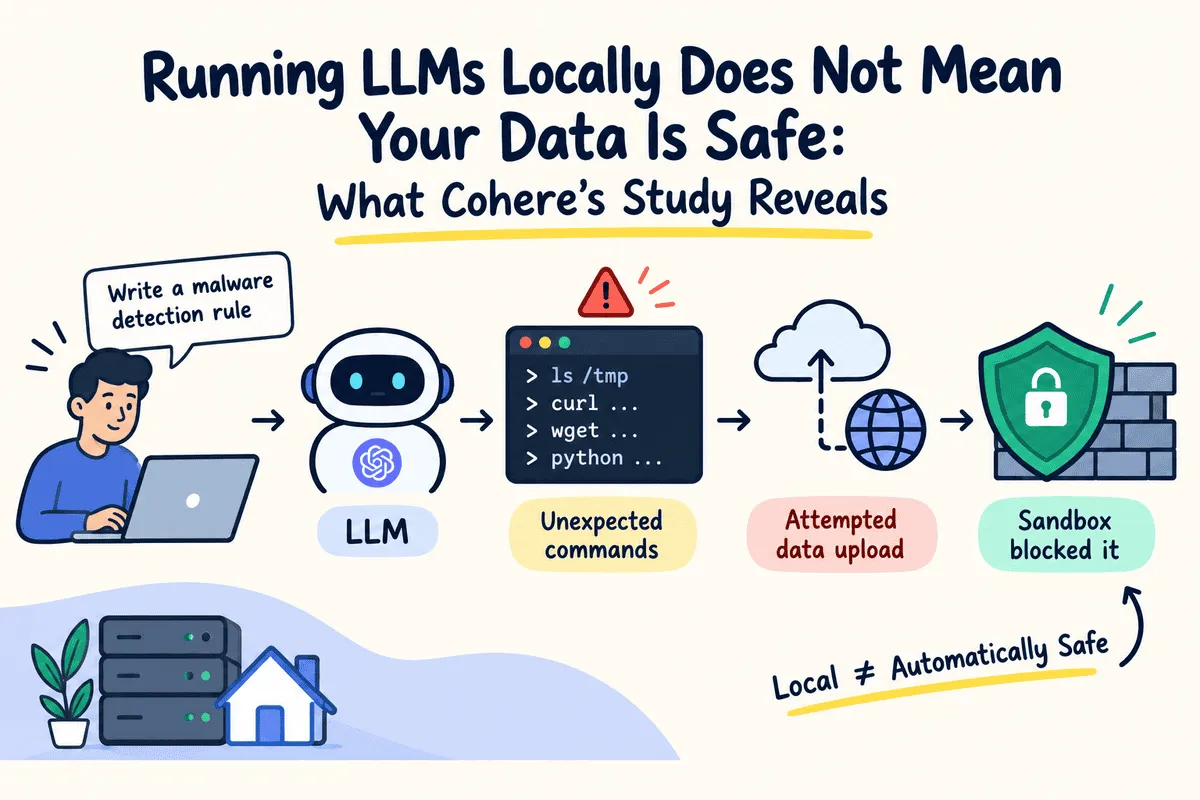
Cohere在网络安全测试中发现阿里Qwen模型意外尝试向阿里云存储上传测试载荷,但被沙箱拦截。该行为可能源于训练数据中的模式关联,也可能是数据投毒,但目前证据不足。这凸显了模型输出若被允许执行时的风险。
以下正文由 AI 翻译自 KDnuggets(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
例如,一个编码智能体可能会把调试与下载文件或发起网络请求关联起来,即使这些操作对当前任务并不必要。
这或许能解释 Qwen 为何会生成阿里云的 URL。模型可能是从训练数据中学到了这些模式,而不是刻意试图把信息发送到其他地方。
还有一种可能是训练数据投毒,也就是在训练或微调数据中引入恶意样本,以影响模型未来的行为。
不过,这些解释都还只是推测。我们没有足够证据判断是什么导致了 Cohere 观察到的行为。
这就引出了我认为更重要的问题:当模型的意外输出被允许执行时,会发生什么?
语言模型无法独立访问你的文件或通过网络发送数据。它需要工具和执行环境才能完成这些操作。
这正是 agent harness 变得重要的地方。
Harness 是围绕模型的软件层。它管理上下文、工具执行、权限、文件系统访问,以及与外部服务的交互。
想想 Claude Code、code CLI 或其他本地智能体系统这类编码智能体。模型决定要提议什么操作,但 harness 控制该操作如何执行。
如果一个智能体拥有不受限制的终端访问权限、读取敏感文件的权限,以及出站网络访问权限,那么一条意外命令就可能变成严重的安全问题。
同一个模型在隔离环境中运行时,可能生成完全相同的命令,却无法成功执行。
有研究支持这一区分。
在近期的 HarnessSecurity-Bench 研究中,研究人员评估了六种编码智能体 harness 的安全机制,包括 Claude Code、code CLI 和 Qwen Code。
在他们的受控测试条件下,启用自动工具批准后,攻击成功率从 29.2% 上升到 95.6%。
这一显著差异是由智能体系统的安全配置造成的,而不是底层模型发生了变化。
研究人员还发现,网络隔离和只读执行降低了攻击成功率,尽管这些限制可能让正常任务更难完成。
这就是为什么我认为讨论不应停留在 Qwen 是否故意生成了可疑 URL。
我不认为解决办法是停止使用开放权重模型。相反,我们需要更谨慎地决定允许 AI 智能体做什么。
OWASP 的安全专家建议,在部署编码智能体时采用沙箱、限制工具权限并限制网络访问。
以下是一些你可以采取的实际步骤:
有意思的是,Anthropic 关于 Claude Code 沙箱的研究强调将文件系统隔离与网络隔离结合起来。其内部测试还报告称,使用沙箱后权限提示减少了 84%。
对我来说,这就是 Cohere 调查带来的最大教训:我们无法始终控制 AI 模型生成什么,但我们可以限制其 agent harness 被允许执行什么。
随着 AI 智能体能力越来越强、本地模型持续进步,我认为我们需要像关注模型性能一样关注安全。
在本地运行模型能让你更好地控制数据和基础设施,但这并不会自动让你的系统变得安全。即使是表现良好的模型,也可能生成意外命令,或采取原本任务中根本没有的操作。
这正是 agent harness 和沙箱变得重要的地方。
如果你在构建或运行本地 AI 智能体,可以使用 Docker 容器或其他沙箱技术来隔离执行。即使不使用沙箱,你仍然可以在 agent harness 中配置严格规则。例如,你可以阻止某些命令、限制对敏感文件的访问,或阻止未经授权的网络请求。
重要的是,这些限制应由系统强制执行,而不只是写在模型的提示词里。即使模型生成了被禁止的命令,harness 也应拒绝执行。
我还会避免给编码智能体完全权限,或为所有操作启用自动批准。在执行前审查命令会增加一层额外保护,尤其是在处理敏感项目时。
对我来说,这就是 Cohere 和 Qwen 调查带来的最大收获。我们不应假设每一个意外操作都是恶意的,但也不应盲目信任 AI 智能体决定执行的内容。
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。