AI时代下的软件工程面试正在变成一场试镜
来源标题:Auditioning Engineering: Software Engineering Interviews in the Age of AI
文章作者Srivathsava Rangarajan在WMG Lab撰文指出,AI并未让软件工程面试变得更糟,而是本就糟糕的面试被AI彻底颠覆。与其在面试中禁止AI,不如围绕AI完成编码后剩余的工程能力来设计面试。核心问题是:当AI生成代码时,工程能力体现在哪里。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
软件工程 编程面试 试镜式工程:AI 时代的软件工程面试 作者:Srivathsava Rangarajan WMG Lab 阅读时长 6 分钟· 刚刚
近三十年来,软件工程师一直在忍受软件工程面试流程这一入门仪式。你要实现一个算法、反转一棵树、找出网络中的最短路径,而这一切都在一位工程师的注视下完成。这很容易让人联想到智能体编程。事实上,这正是大语言模型天生擅长的事情。它是一道提示词明确的谜题,一个“记住就行”的技巧,只有唯一正确答案。
AI 并没有让面试变得更糟。软件工程面试从一开始就很糟糕,而 AI 只是把它彻底击穿了。所以,我们没有在面试中管制 AI 的使用,而是告诉候选人去用 AI,并把面试建立在工具完成自己那部分工作之后剩下的东西上:当 AI 生成代码时,工程在哪里?
这个问题的答案似乎显而易见,让人怀疑是不是错过了什么玄机。工程并没有去哪里,它一直就在原地,存在于将意图转化为软件的艺术之中。
我们“生成”代码已经几十年了。手工编写每一条机器指令的时代,随着 50 年代编译型语言的出现而终结;IDE 加入了预测性自动补全(看一眼 Java 程序员的键盘,你会发现 Tab 键磨损得厉害);互联网和 Stack Overflow 带来了 Ctrl、C 和 V。LLM 只是这一谱系中最新的一件工具。
在 WMG,我们相信软件工程是一门艺术。软件工程之所以是艺术,原因和同一首歌有成千上万个翻唱版本一样:风格。观众有品味,组织有文化。工程师将意图转化为行动,而不是逐字转写,正是在这种诠释中,我们找到了通过个人技术判断来表达组织文化的空间。Python 还是 Go?单体还是服务?简洁还是完整?
主流的面试流程过度强调技术,而对艺术重视不足。所以我们提出了一个更好的问题:如何让 AI 负责执行,而去检验工程的艺术?
我们的编程面试取材于代码库中变动最频繁的部分:日常工程问题,夹杂一些有趣的挑战,比如基于 HTTP 的 API 交互(包括网络故障)、“不可修改”的遗留端点(设计不规范且没有幂等性),以及跨系统的数据连接与丰富。
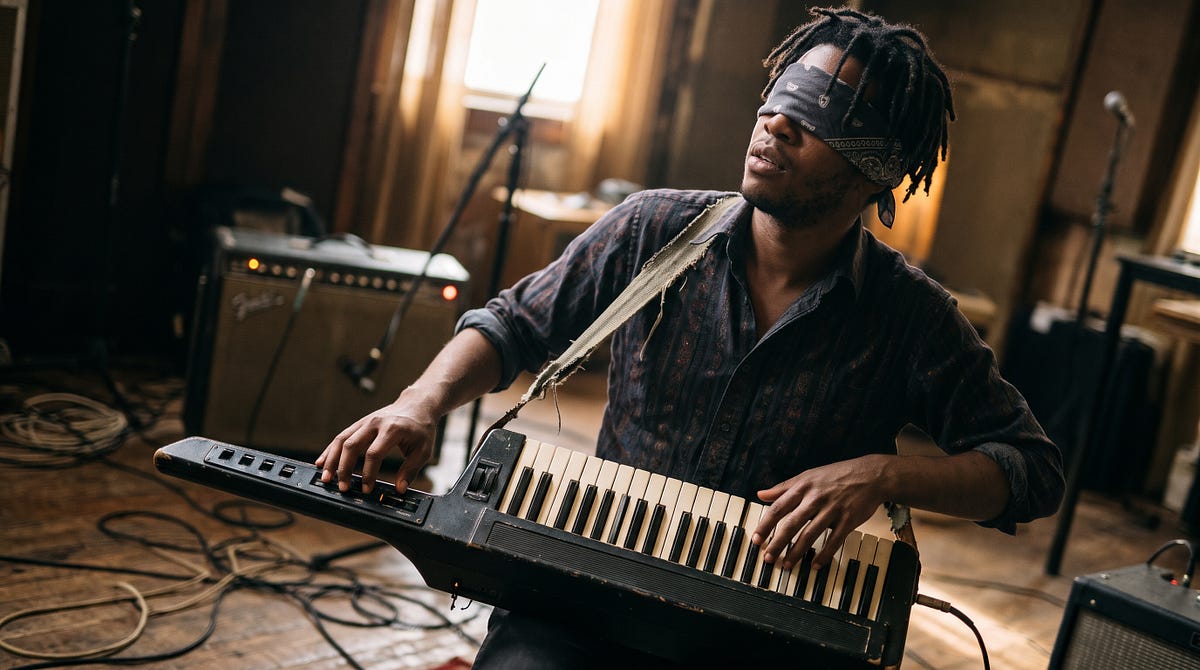
候选人按照规格实现一个客户端,同时一个实时服务器充当测试台,并通过定期记录的分数提供反馈。工作负载是随机的,分数在每次重启时重置,这模拟了日常工程快速迭代的特性,又不允许临时拼凑的解决方案。工作负载经过校准,会逐步暴露越来越复杂的问题,因此表现应当大体上与经验相关。描述它的最佳方式是:蒙着眼睛凭听觉学一首歌——反馈不会告诉你哪些音符错了,只告诉你听起来对不对。也没有唯一正确的演奏方式,但走音时很容易听出来。这种艺术形式在于找到你自己的方式,把组织文化融入你的技术风格。
由 Gemini 生成
可用的 SDK 作为起始代码提供,而不是一张白纸;内部依赖被建模为文档齐全、预装好的模块,因为现实中这些探索需要数天的协作、代码理解和测试。
免费加入 Medium,获取这位作者的更新。
LLM 是我们开发生命周期中无处不在的一部分,所以我们把它视为这场试镜的前提条件,并鼓励使用。既不让编程面试变得无足轻重、又鼓励使用 LLM 的诀窍在于:不要以形式化为名把问题简化,因为那样它就变成了一个提示词。巧妙地提炼并形式化地陈述问题,这一能力正是工程技艺在 AI 生成代码时依然存续的重要所在。
为了校准难度,我们在内部用数十位不同资历的志愿者对面试进行了地面测试,内部排行榜还吸引了不少工程师为了好玩而参与。
我们的系统设计面试灵感来自对内部 RFC 和事故复盘中出现最多的问题进行采样:数据建模和分布式系统问题,涉及重试、事务性与锁、恰好一次语义、幂等性与竞态条件,以及引用完整性等关注点。关键在于把面试从“设计一个支付应用”这类模糊的问题陈述,重新塑造成对设计选择的机制性影响进行细致入微的讨论。
这是一场针对现有系统的协作编辑练习,用伪代码表达,目标是实现新功能、改进和缺陷修复。候选人必须先建立系统的思维模型,然后提出设计改动,面试官像 AI 智能体那样把改动记录为伪代码的变更。候选人可以要求“部署”一项改动,并以领域语言获得观察到的行为反馈,而不去识别或追踪因果关系:“用户仍在报告 429,尽管量似乎比之前低了”,而不是“第 42 行的锁有帮助,但没有过期时间的话可能会出现饥饿”。更复杂的设计需要更长时间来记录和“部署”,这给候选人的设计选择带来了自然的成本。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。