资讯与观察
AI 行业动态、工程实践、产品方法和社区故事。

开发者用JIT技术在RP2350微控制器上实现超快位图文字渲染
开发者为其RP2350上的复古电脑项目vic-2350实现了一种超快位图文字渲染技术。该方法核心是JIT,可在运行时为渲染字符串动态生成高度优化的代码,从而支持比例间距和字距调整。该技术已集成到其race-the-beam渲染器中,同样适用于framebuffer写入。


LATEST STORIES
最新内容
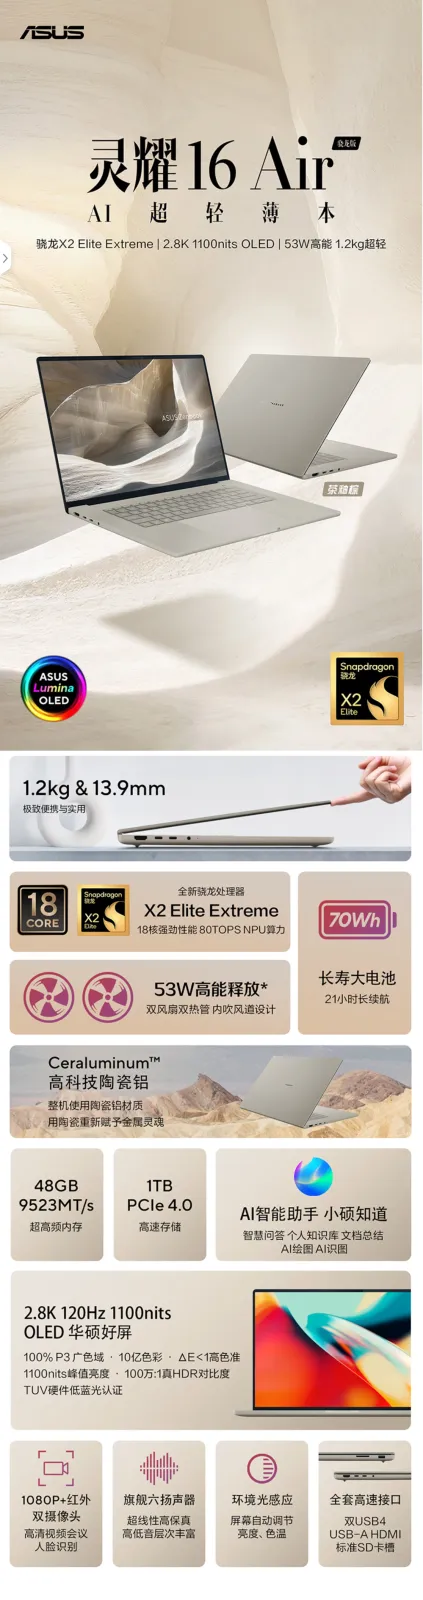
24G+1T 版 12499 元,华硕灵耀 16 Air 骁龙版笔记本上架精选导读
IT之家 11 月 8 日消息,华硕灵耀 16 Air 骁龙版 AI 超轻薄本现已在电商平台上架,24GB+1TB 版本定价为 12499 元。 京东华硕灵耀 16 Air 骁龙 X2 Elite Extreme 版 12499 元直达链接该机型搭载全新骁龙 X2 Elite Extreme 处理器,采用 3nm 先进制程,配备 18 核 CPU,最高加速时钟频率达 4.7GHz,NPU AI 引擎算力为 80TOPS,CPU 性能释…
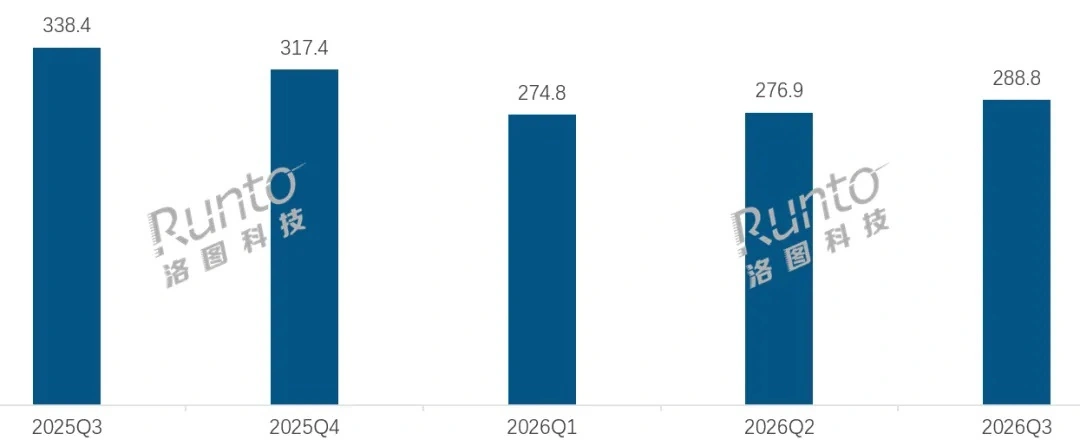
洛图科技:2026 年第三季度中国家用路由器线上主流市场量额齐跌 15%,零售均价 239 元精选导读
IT之家 11 月 8 日消息,洛图科技数据显示,2026 年第三季度,中国家用路由器线上主流市场(含京东、天猫等电商平台)的销量为 288.8 万台,同比下降 14.7%;销额为 6.9 亿元,同比下降 14.9%;零售均价为 239 元,同比减少 0.3%。 从前三季度累计看,线上主流平台的总销量为 840.5 万台,同比下降 11.6%;销额为 20.4 亿元,同比下降 11.2%。销量的降幅略高于销额维度,表明价格结构仍在下探…
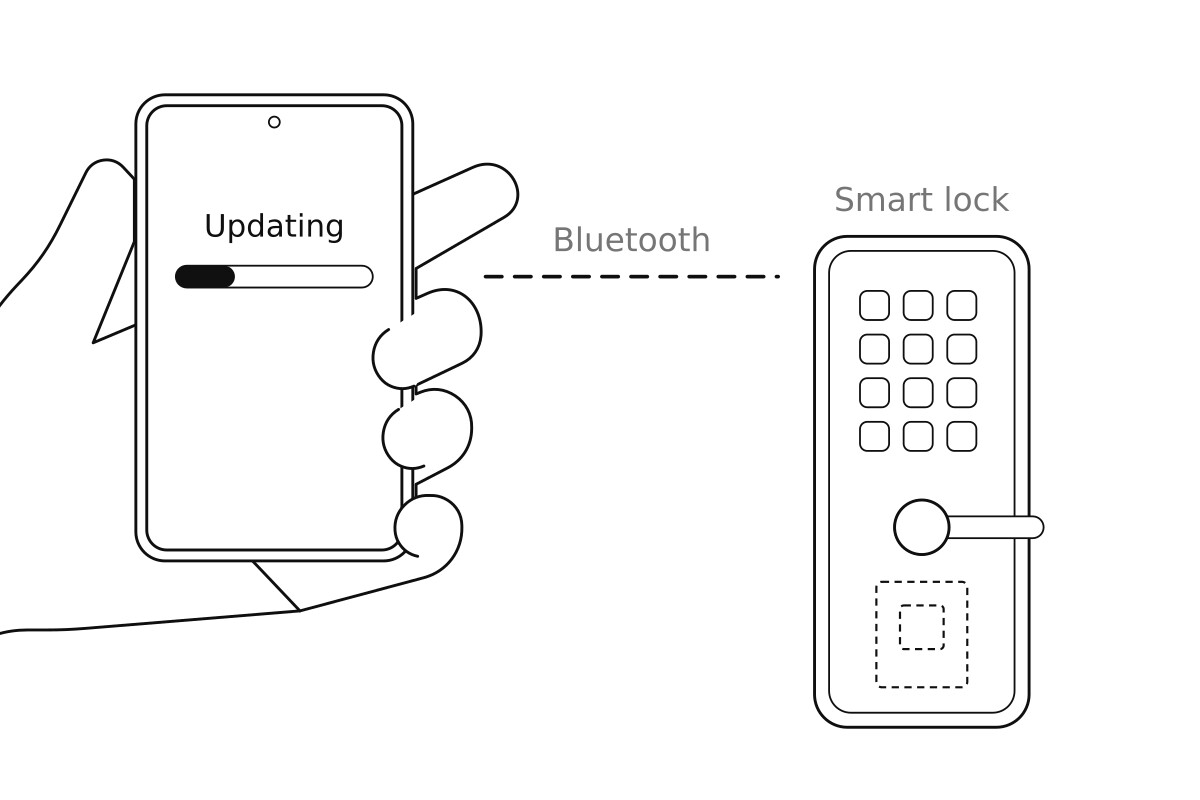
AI编程代理将ESP32蓝牙OTA更新从8分钟缩短至22秒精选导读
AI编程代理把ESP32芯片的蓝牙OTA更新耗时从超过8分钟缩短到22秒,实现过程耗时11.8小时。这些代理最初在理想实验室环境中开发,忽略了真实无线环境的复杂性,导致实际部署失效,意识到问题后才修复。作者由此强调,AI编程代理必须同时接入硬件在环和真实环境在环。
数学家解决悬置55年的数学猜想,灵感源自杂耍精选导读
一群年轻数学家通过随机性和友谊,解决了一个悬置55年的数学猜想。该猜想最早由Graham于1971年提出,可能受杂耍启发,核心问题是:任意一组不含零的不同整数,是否总能重新排列,使所有部分和互不相同。研究者在论文中给出了肯定答案。
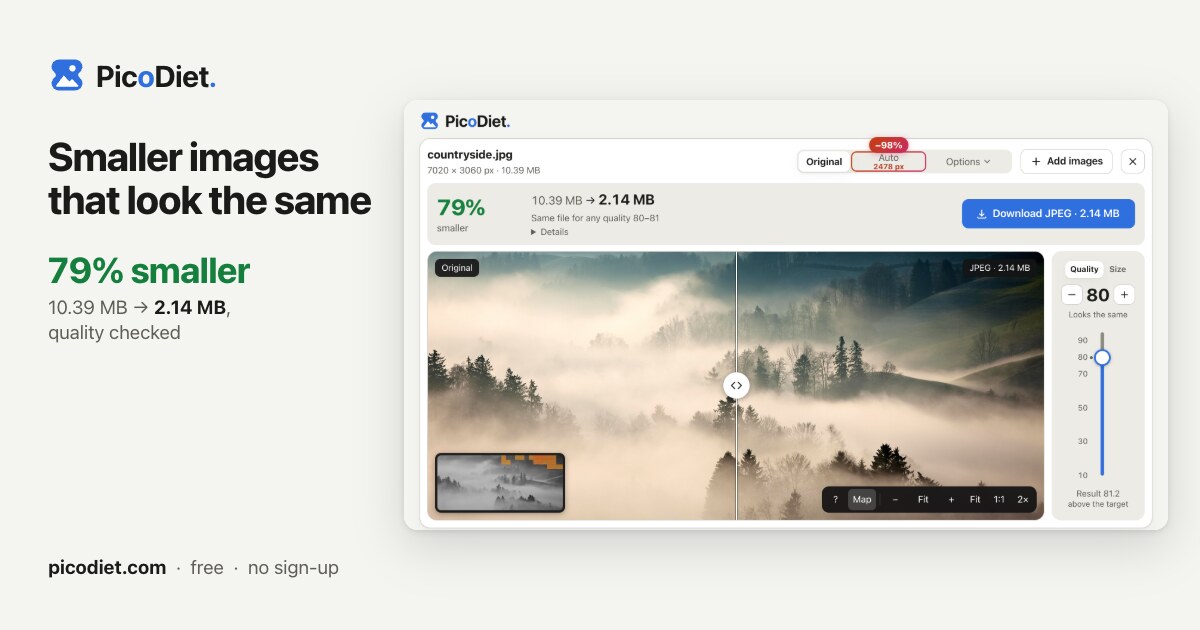
PicoDiet 按目标视觉质量分数压缩图片,而非固定参数精选导读
PicoDiet 改变图片压缩方式:先设定目标视觉质量分数,再为每张图自动寻找能达到该分数的最小文件。它用 SSIMULACRA2 指标给每次尝试打分,并检查人脸模糊、文字损坏等局部问题;每张压缩图都会显示分数,可与原图对比。默认模式保持原格式和尺寸,Auto 模式则按图决定:照片转为 JPEG,大图长边缩至约 1920 像素,截图和图形保持原样。
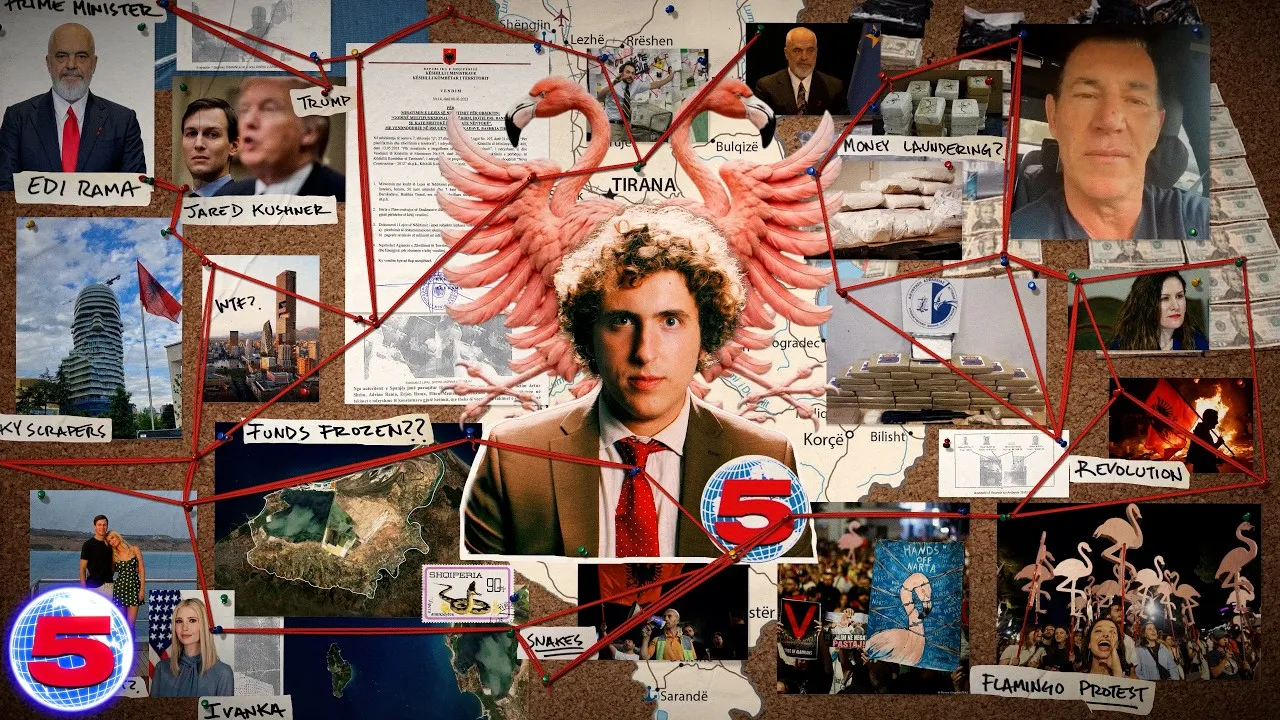
调查报道:贾里德·库什纳的欺诈与腐败网络精选导读
视频调查梳理贾里德·库什纳的商业与政治活动,指其存在欺诈与腐败行为。内容涉及库什纳在房地产、白宫任职期间及卸任后的相关交易与运作。该视频为调查性报道,提出对库什纳商业帝国运作方式的质疑。

研究对比DeepSeek、Qwen、Mixtral、Llama 4、gpt-oss等10款开源MoE模型的路由配置精选导读
一项基于配置文件的对比梳理了10款开源MoE模型的路由设计,专家数从8到384不等,top-k在1至8之间,部分模型保留常驻共享专家。路由稀疏度从Mixtral的4倍到Llama 4 Maverick的128倍;Kimi K2在相同验证损失下,稀疏度48比8所需FLOPs少1.69倍。Llama 4 Maverick和gpt-oss未在config.json中公开门控或负载均衡方法。
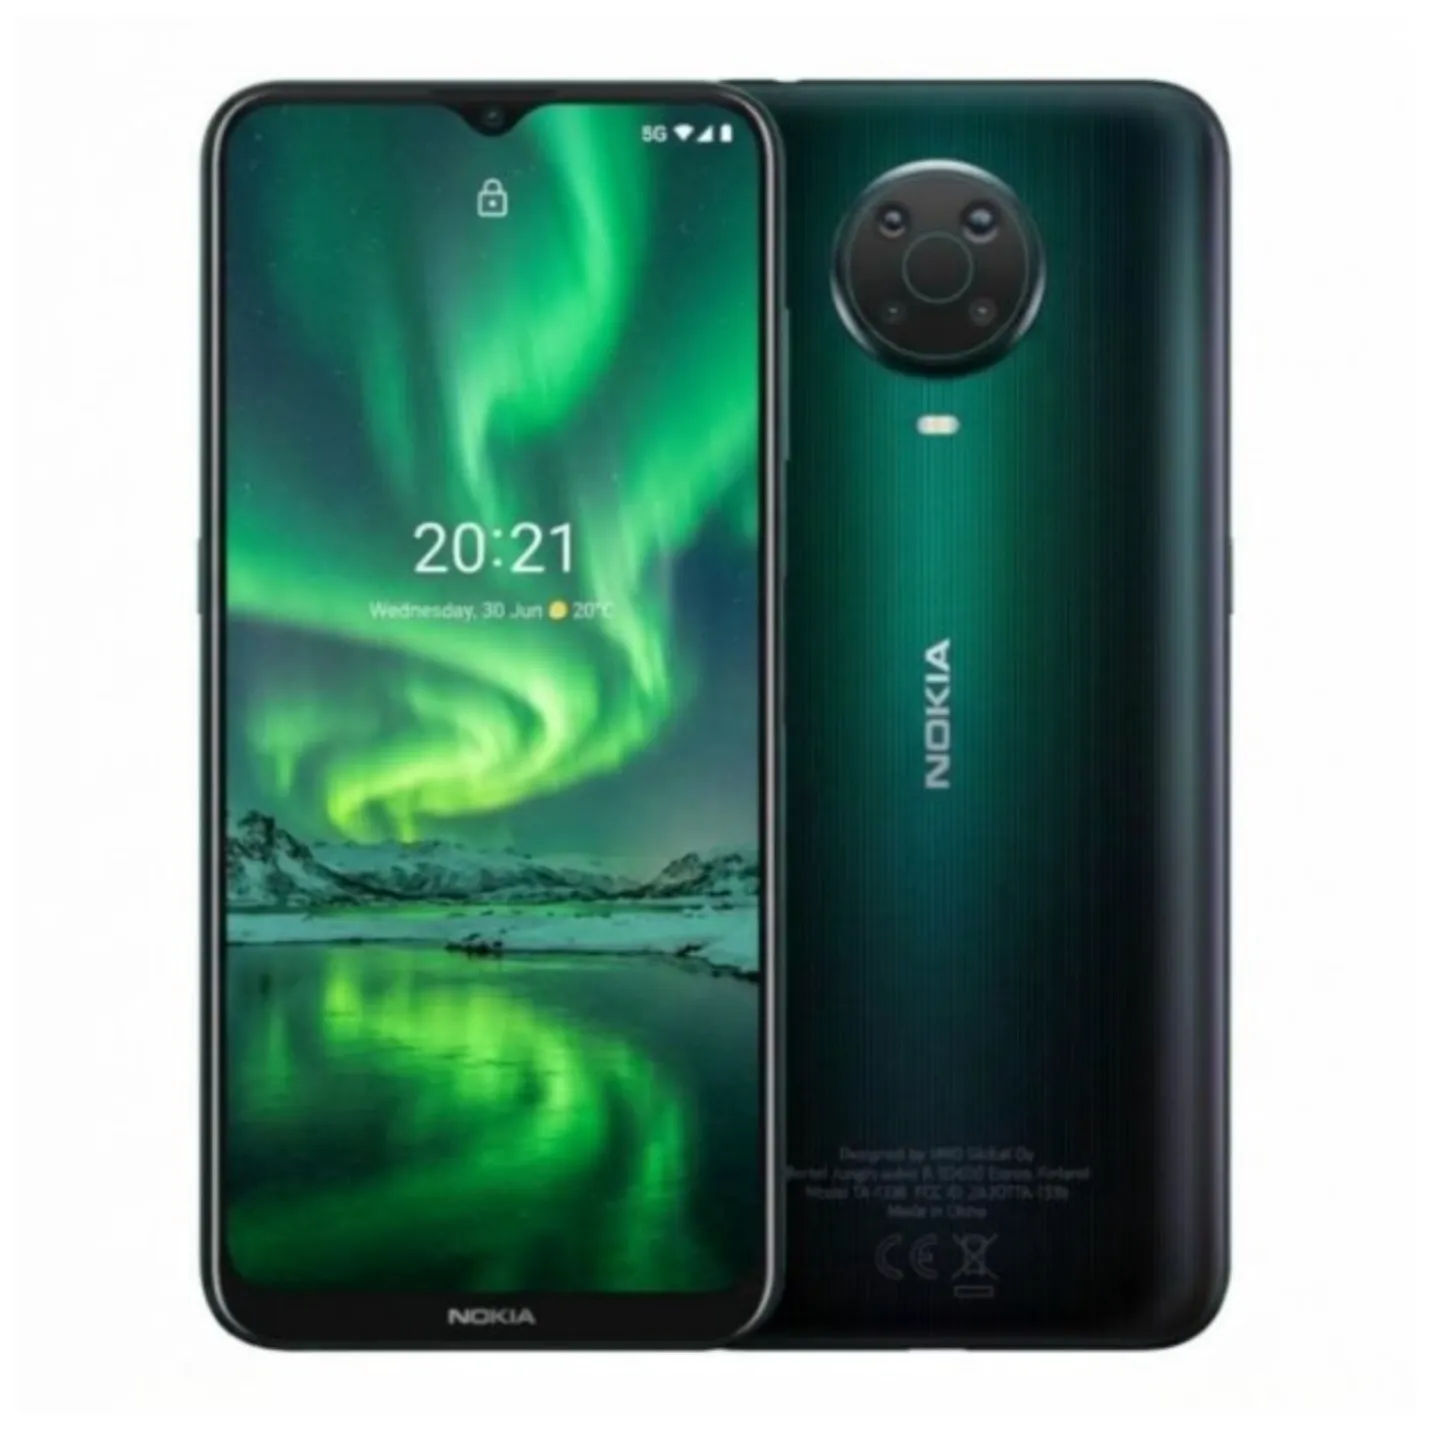
被砍的 2021 款诺基亚 G20 5G 手机曝光:展锐 T7520 + 4G RAM精选导读
IT之家 11 月 8 日消息,消息源 smashx_60 发文,曝光了被砍的 HMD Global 旗下 2021 款诺基亚 G20 5G 手机。 参考其介绍,该机配备一块 6.52 英寸 1612x720 分辨率 IPS LCD 水滴屏面板,匹配 8Mp 自拍摄像头;该机后置圆形摄像头,匹配 48Mp 主摄 + 5Mp 超广角 + 2Mp 辅助摄像头 + 2Mp 辅助摄像头。 该机配备紫光展锐 T7520 处理器,搭载 4GB R…

开发者用Llama-modchip在64GB内存无GPU设备上运行284B参数DeepSeek模型精选导读
开发者通过Llama-modchip项目在仅64GB内存、无GPU的设备上成功运行284B参数的DeepSeek模型。该项目依托llama.cpp的量化与内存映射技术,实现大模型在消费级硬件上的本地推理。