Nvidia量产Rubin GPU并更新规格:内存与NVLink带宽下调
来源标题:Nvidia Updates Rubin GPU Specs as First Production Hardware Arrives
Nvidia在首批量产Rubin GPU到位时悄然修订了硬件规格,Rubin GPU的内存和NVLink纵向扩展带宽较此前宣传有所降低,但横向扩展带宽增加。更新规格于2026年9月发布在Nvidia官网和架构数据表中,首批NVL72系统已由超大规模云厂商向客户提供。Nvidia此前说明这些规格为初步数据,所有数值可能变动。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
随着2026年第四季度到来,NVIDIA及其合作伙伴正处于Vera Rubin产能爬坡阶段,其中超大规模型云服务商已开始向客户普遍提供首批NVL72系统。随着Vera Rubin进入量产铺开的临界点,NVIDIA也终于锁定了硬件出货规格。结果发现,该公司已悄然修订了这些规格:Rubin GPU现在的内存和scale-up网络(NVLink)带宽低于NVIDIA此前宣传的水平,但scale-out带宽有所提高。
据IT Home最初发现,NVIDIA在9月于其网页和NVIDIA架构数据表中发布了Rubin GPU及多款基于Rubin的产品的更新规格。需要说明的是,服务器硬件规格在产品发布前发生变化并不罕见,尤其是像Vera Rubin这样提前近一年宣布的产品。NVIDIA的情况也不例外,该公司当时曾指出这些规格是初步的,且“所有数值均可能变更”。
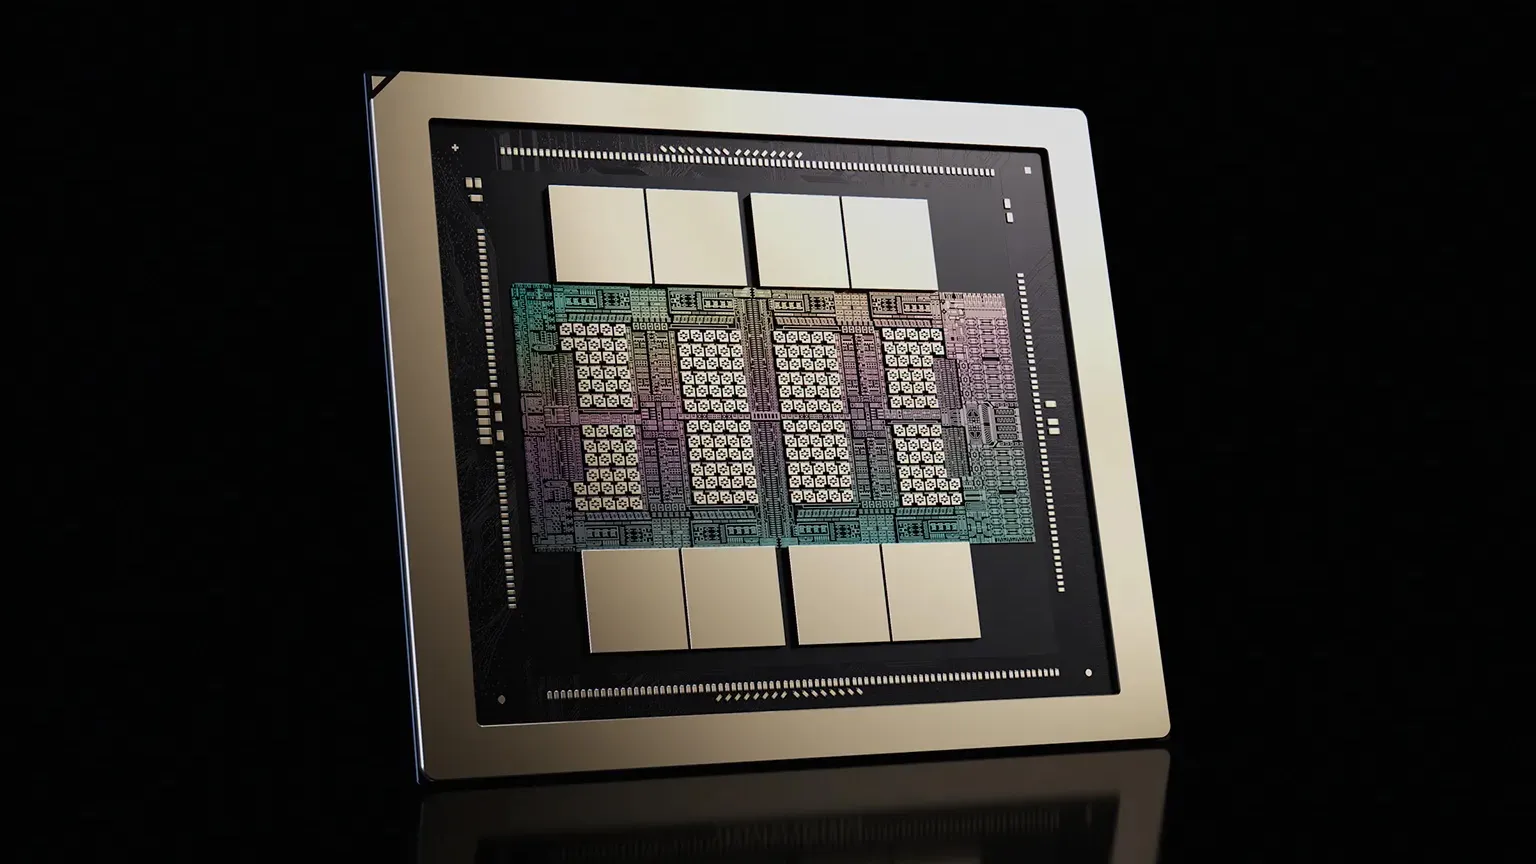
首先,我们来谈谈NVIDIA的Rubin GPU。作为NVIDIA这一代雄心壮志的基石,NVIDIA的Rubin服务器GPU将应用于大大小小的系统,并成为更大规模项目的构建模块。
与NVIDIA的初步规格相比,单个Rubin GPU的HBM4内存带宽已被显著下调。NVIDIA最初的目标是每个Rubin GPU提供22TB/s的内存带宽。按8个HBM4内存堆栈计算,这意味着每个堆栈的运行速率约为10.75Gbps/pin。但根据这些修订后的出货规格,单个Rubin GPU现在将提供19.2TB/s的带宽,数据速率约为9.375Gbps/pin,净损失1.375Gbps,约11%。
这一规格变化发生之际,NVIDIA一直为HBM4规划了非常激进的数据速率。这一超大版本的高带宽内存规范已将每个堆栈的内存总线宽度从1024位翻倍至2048位。与此同时,官方规范要求HBM4堆栈的运行时钟频率略低于HBM3E,目标为8Gbps/pin。NVIDIA的10.75Gbps速率显著高于原始HBM4规范,即便此次下调后的9.375Gbps数据速率仍远高于该规范。
作为参照,NVIDIA的竞争对手AMD将在MI455X上以仅7.6Gbps/pin的速率运行其HBM4堆栈。因此,NVIDIA修订后的目标显著高于其他一些HBM4使用方。即便消息传出后,NVIDIA也未说明为何下调内存带宽规格。在缺乏解释的情况下,最直接的假设是NVIDIA及其内存合作伙伴无法兑现这些规格,原因可能是内存控制器速度、内存堆栈速度、内存堆栈良率(多少堆栈能以目标速度运行),或这些因素的组合。无论原因如何,最终结果是客户可用的GPU内存带宽减少,并将带来性能影响。
与NVIDIA最初的预期相比,NVLink互连带宽也受到了影响。NVIDIA多GPU连接与scale-up互连结构的初步规格是每个Rubin GPU提供3.6TB/s的NVLink带宽。现在这一数字降至3.0TB/s,减少了600GB/s(即17%)。NVLink是NVIDIA着力推动让众多物理GPU像单个GPU一样协同工作的领域,因此通常会推动可能性的极限。
虽然NVLink(scale-up)带宽有所降低,但scale-out网络带宽现在表现超出预期。对于单个Rubin GPU,NVIDIA提供450GB/s的网络带宽,高于初步规格的400GB/s。
除这些变化外,NVIDIA未更改Rubin GPU的任何其他规格。理论(纸面)计算吞吐量保持不变,FP4推理为50 PFLOPS,FP4训练为35 PFLOPS。因此NVIDIA达到了该GPU的时钟速度和内存容量目标。
Rubin的规格变化还将影响所有采用它的产品,最引人注目的是NVIDIA的旗舰产品Vera Rubin NVL72机架。NVL72展示了NVIDIA的所有技术,集成了其Vera CPU、BlueField-4 DPU,当然还有Rubin GPU。
对于NVL72,其规格已随单个Rubin GPU的变化同步修订。这意味着该机架级系统的累计GPU内存带宽从1,580TB/s降至1400TB/s,净损失180TB(11%)。不过,与单个Rubin一样,NVL72的GPU内存容量保持不变,仍为20.7TB HBM4。
该系统scale-up域的NVLink带宽也进行了调整。NVIDIA原计划在整个机架提供260TB/s带宽,现已下调至216TB/s,降幅17%,与每个Rubin GPU新的3TB/s速率一致。
对NVL72而言,一线希望是它获得了与单个Rubin芯片相同的scale-out网络带宽提升。因此,NVL72原本计划提供28.8TB/s的网络带宽,现已提升至32.4TB/s(双向)。这意味着对于大量使用scale-out网络的大型部署,现在可用的带宽(以及理想情况下更高的性能)比NVIDIA最初预测的更多。
除此之外,Vera Rubin NVL72的其余数据与早先规格保持不变。NVL72机架在内存和NVLink带宽低于最初设想的情况下能否达到同样水平的AI性能似乎值得怀疑,但GPU计算硬件(及其对应的CPU)正按规格出货。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。