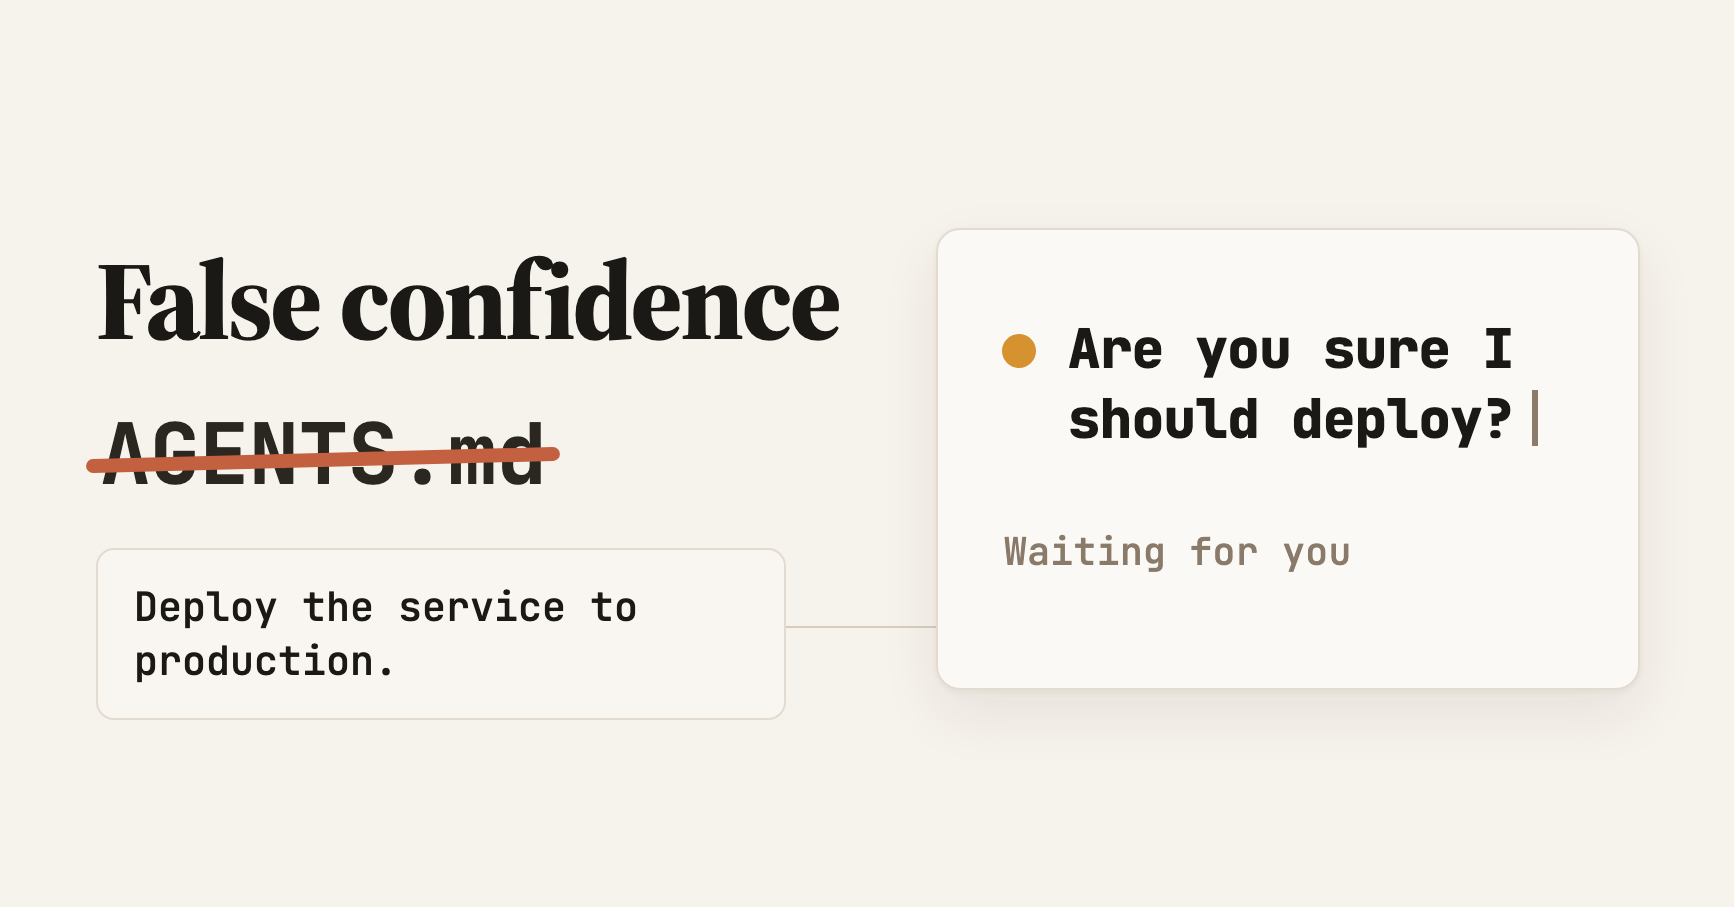
开发者抱怨AI代理需人工批准,任务夜间空等服务器闲置
来源标题:You Don't Know If Your Agents.md Helps. You Just Keep Adding Rules
一位开发者指出,即使写好Agents.md规则并事先讨论好计划,AI代理(Claude Code、Codex、Antigravity)夜间仍会在执行完小部分任务后停下等待人工确认,导致服务器整夜空转。他希望构建一套能跨会话、跨代理保留已做决策并自动推进任务至完成的系统,以完成任务数、成本和人工介入频率作为评判标准。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
Claude Code、Codex 和 Antigravity 挤在同一个工作区里。新规则不断加,决策却不断丢,还有一台服务器整夜闲着没事干。
TL;DR。你写好了规则,讨论完了计划,然后去睡觉。第二天早上你发现,agent 只完成了一小部分工作,就停下来问要不要开始下一阶段。你没回。你在睡觉。规则还在,任务没做完,服务器就那么空转了一整夜。我想要一个系统:它能跨会话、跨 agent 保留已经做出的决策,能利用我们积累下来的经验,能把任务一路推进到有结果为止。我想用完成的任务数、成本、以及我需要介入的频率来衡量它。
你给 agent 一个任务,讨论了计划,手里还有一套私有的 harness——那套基础设施能启动不同的 agent、在它们之间交接工作、安排代码审查。服务器开着,数据就绪,你去睡了。
早上你打开对话。任务的一小部分做完了。然后问题来了:要我开始处理测试数据吗?
你说:好,开始吧。结果处理又需要好几个小时。
这几个小时本可以趁夜里跑完。但服务器停在那里,agent 在等你,而你一觉醒来,又成了那个必须推着流程往前走的人。又一次。
对,你可以说我没在正确的位置写一句单独的“开始”。这恰恰就是让我火大的地方。我委派了一个目标明确的任务,还讨论了过去的路。结果我发现,我还得去猜 agent 会在哪些点把控制权交还给我。
如果拿到结果意味着我得提前把所有这类点列出来、再一个个去处理,那执行的大头仍然压在我身上。
下一次停住之后,我可以加一条规则:别再问这个。先查知识库。如果这一步属于商定的计划,就继续做。
然后冒出一个例外。然后是对例外的澄清。AGENTS.md 越来越细,CLAUDE.md 越来越长,旁边还长出了另一个 skill。
这是一种虚假的自信:指令变得更详细了,但没有任何东西去检验 agent 是否真的变好了。
过了一阵,agent 问了一个我已经回答过的问题。我又解释一遍,指向正确的记录,推它走下一步。然后我发现它忙着干没人要求它干的活,于是我又写了一条指令。
我怎么知道这些到底有没有让它变好?
我能看到文件变了。我能检查规则写得是否合理。但这仍然不能告诉我下一个任务会怎样:会更便宜吗?更准确吗?更独立吗?
我有几十个项目。我不需要专门再开一班来照看每一个跑着的 agent。我需要的是:交出去一个任务,转去做别的事,回来拿结果。
把 owner 的持续介入藏在“agentic”这个漂亮词后面,是很容易的。但如果工作经常要等我的消息才能继续,那我仍然是它主执行循环的一部分。
一条新规则可能有帮助,也可能让 agent 干些没用的活;它可能和另一条指令冲突,也可能只在某一个特定场景下有用。
与此同时,我们还在不停换模型、换工具、换上下文,任务本身也在变。然后我们看到一个好结果,就把功劳记在最近那次调整上;或者看到一个坏结果,就再加下一次调整。
Evaluating AGENTS.md 在编码任务上测试这类文件。在第三版中,作者报告成功率整体没有提升,推理成本平均高出 20% 以上,尽管 agent 很好地遵循了指令。他们还指出,描述非标准做法是有帮助的。
那不是对我们这些会话的测量。但它狠狠打击了一种舒服的信念:一条被遵循了的指令,会自动让工作变得更好。
所以我想看到我的规则到底起了什么作用,而不只是为自己多会措辞而得意。
为了不只依赖印象,我让人对我们本地的 Claude Code 日志做了一遍扫描。在排除服务消息、重复项、sidechain 会话和选定的私有项目之后,自动扫描保留了我从 2026 年 8 月 10 日到 11 月 7 日的 3,433 条消息。其中 461 条(13.4%)被脚本标记出脏话标记。
有 2,924 条消息可以和它紧挨着的前一条 agent 文本配对。搜索把其中 316 条结尾(10.8%)标记为把决策交还给我的措辞:等待指令、批准或选择。在这些之后,我的回复中出现脏话标记的比例是 20.3%;其余情况是 14.1%。
这是对措辞的搜索,不是对每个问题的人工评级。它不能证明每一次这样的确认都是不必要的,也不能证明这些确认导致了恼火。数据只覆盖 Claude Code;这组数据里没有 Codex 或 Antigravity 的交互式对话。方法和聚合结果可以获取,但不含原始对话日志。
所以下一步是打开一个具体案例:agent 到底留了什么给我决定,工作又为什么停了。
我试过用不止指令的东西让工作继续。在一次 Mitts 开发会话中,一个停止条件生效了:如果目标还没达成,一项检查本应把 agent 送回工作。
在那次会话的日志里,我发现同一条件下的检查被单独触发了 27 次。它拒绝了收尾,而 agent 一直在解释为什么需要 owner 做决定。其中一些重复几乎是背靠背发生的。那是 27 次触发,不是 27 个不同的决策。
拆开来看,好几件不同的事被粘进了一个停止点。agent 压着一个公开发布、缓存处理方案的选项,还有其他技术变更。发布需要单独决策。技术选项需要在任务范围内权衡——而任务本身是关于提速的。至于那个停止检查,它要求证明结果已经快到极限。
系统没有把这些区分开,而是卡进了循环:检查把 agent 送回去
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。