开发者修复浏览器OCR识别防晒霜瓶身失败问题
来源标题:My browser OCR couldn't read a sunscreen bottle. Here's what fixed it
开发者发现其基于Tesseract.js的浏览器图片转文字工具在识别手机拍摄的防晒霜瓶身时输出乱码,并定位出四个叠加的问题。该工具此前处理截图时置信度达94%至96%,但实际手机拍照场景下识别效果大幅下降。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
截图一直没问题。然后有人把手机对准了一瓶防晒霜,我的图片转文字工具吐出了“EB ewraone”。这就是问题所在,以及我做了哪些修改。
我运营着 devpack,一个提供 500 多款免费工具的网站,这些工具都能在浏览器里直接使用。其中一个是图片转文字工具,用的是 Tesseract.js——也就是编译成 WebAssembly 的 Tesseract OCR 引擎,所以图片永远不会离开你的设备。我很喜欢这一点,而且对截图和扫描页面来说,它工作得非常好。我的大多数测试结果置信度都在 94% 到 96%。
然后我试着像人们平时用手机那样去用它。我拍了一张儿童防晒霜瓶子的照片。蓝色塑料瓶身,白色字母,一个大大的黄色太阳图案,里面写着“SPF 50”。返回的结果是这样的:
| FA Be NO k Jody ; " | Diana i Collection Kid i “protect & care v4 oR. a 7 SPF ... EB ewraone
里面有那么几个真词,埋在垃圾里。第二张照片是一个婴儿古龙水瓶,结果更糟。返回了七行短文字。其中一行只是一个 & 符号,另一行是“& TED”。
结果发现,问题不止一个。有四个,而且它们层层叠加在一起。
这个问题我花了比我想承认的更长时间才看出来,因为在我的屏幕上,那张照片看起来完全正常。
手机摄像头在你竖着拿手机时,往往不会旋转实际的像素。它们按传感器看到的样子保存图像,然后加一小段元数据——EXIF 方向标签——意思是“显示的时候把它旋转 90°”。你的相册应用会遵守这个标签。浏览器在显示 <img> 时也会遵守它。但我当时是把原始的 File 直接交给 Tesseract,而 Tesseract 只读取像素。
所以引擎是在试图读取躺倒的文字。难怪它读出了“ING”和一个 & 符号。
修复很简单。用 createImageBitmap 解码文件,并要求应用方向信息,然后把它画到 canvas 上,之后的一切都基于这个 canvas:
async function uprightCanvas(file) { const bmp = await createImageBitmap(file, { imageOrientation: 'from-image' }); const c = document.createElement('canvas'); c.width = bmp.width; c.height = bmp.height; c.getContext('2d').drawImage(bmp, 0, 0); bmp.close(); return c; }
现在预览缩略图我也用同一个 canvas。以前,工具什么都不显示,你甚至不知道它在看什么。现在你能确切看到 OCR 看到的内容,如果不对,还有一个旋转按钮。
还有一种情况:有些照片确实是横着的,而且完全没有任何标签。比如旋转过的照片的截图,或者经过了会剥离元数据的应用的图片。对于这些情况,如果第一次读取的置信度很低,工具会在 0°、90°、180° 和 270° 四个方向分别读取一个小副本(约 1000 px),给每个方向打分,如果某个方向明显更好,就旋转图像。我用的这个 Tesseract.js 构建版本只有 LSTM 引擎,所以它自带的方向检测用不了。改为在小副本上快速跑四遍,就解决了问题。
旋转问题修复后,古龙水瓶的结果好了一些,但防晒霜仍然很糟糕。再看看那个标签。大多数重要的词,比如“UVA / UVB PROTECTION”和“NET WT 200 ml”,都是深蓝底上的白色或浅蓝色。
Tesseract 主要是在浅色纸张上的深色文字上训练的。它能处理一些反色文字,但在有混合颜色、反光和曲面的照片上,它基本上就放弃了。
所以我额外制作了两份图像副本。第一份是普通的灰度图加上对比度拉伸:我构建直方图,丢掉最暗和最亮的 1% 像素,把剩下的铺满 0 到 255 的整个范围。第二份是同样的东西,但反色。蓝底白字变成白底黑字。
// a: ImageData 像素,已经灰度化;lo/hi: 1% 和 99% 分位点 for (let i = 0; i < a.length; i += 4) { let g = (a[i] - lo) * 255 / (hi - lo); g = Math.max(0, Math.min(255, g)); if (invert) g = 255 - g; a[i] = a[i + 1] = a[i + 2] = g; }
对于这些处理,我还把 Tesseract 切换到页面分割模式 11(“稀疏文本”)。默认的模式 3 期望的是一页带有段落和分栏的文字。而产品标签更像是散落在图片周围的一些词,模式 11 就是为这种情况设计的。
这是我没预料到的部分。我以为其中一个变体总会胜出。但并不是这样运作的。
在防晒霜瓶子上,正常的那一遍找到了“Diana”和“Collection”。反色的那一遍找到了“UVA UVB PROTECTION”和“NET WT 200 ml”。而原始彩色图像按文档读取,在我的一次测试中是唯一捕捉到“Water Resistant”的。每一遍也都加上了自己的垃圾:“Ag”、“as”、“©DDL”、“CJC)”。那是太阳和卡通小孩被读成了字母。
所以我没有挑一个结果,而是逐词合并它们。Tesseract 会给你每个词的边界框和置信度分数,这让合并成为可能:
小字有它自己的修复方法:对于本来就不大的图像,我会在放大 1.6× 的副本上再跑一遍灰度和反色处理。古龙水瓶上的“MOISTURISING”和“ALCOHOL FREE”终于就是这样出现的。
这是经过所有这些处理后的防晒霜瓶子,平均置信度 92%:
Diana Collection Kid protect & care UVA UVB PROTECTION face & body sunblock lotion NET WT 200 ml
对比一下最初的输出。那个标签上每一行普通印刷文字都在了。
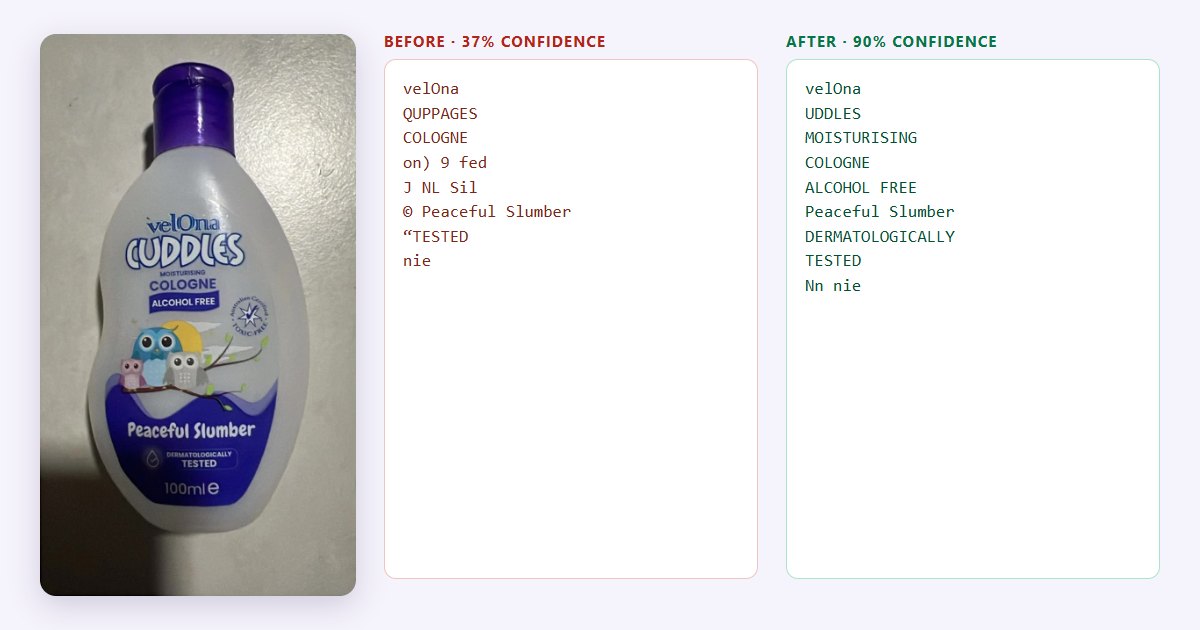
古龙水瓶就是封面上的那个。我在桌子上、普通光线下重新拍了一张,并在同一张照片上跑了两个版本。旧的单遍处理得到 37% 的置信度,给了我“QUPPAGES”、“on) 9 fed”和“J NL Sil”。新版本得到 90%:
velOna UDDLES MOISTURISING COLOGNE ALCOHOL FREE Peaceful Slumber DERMATOLOGICALLY TESTED Nn nie
不完美。“Nn nie”是小水滴图标和标签边缘,气泡字母仍然丢了开头的 C。但每一行你真正想要复制的文字都在了。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。