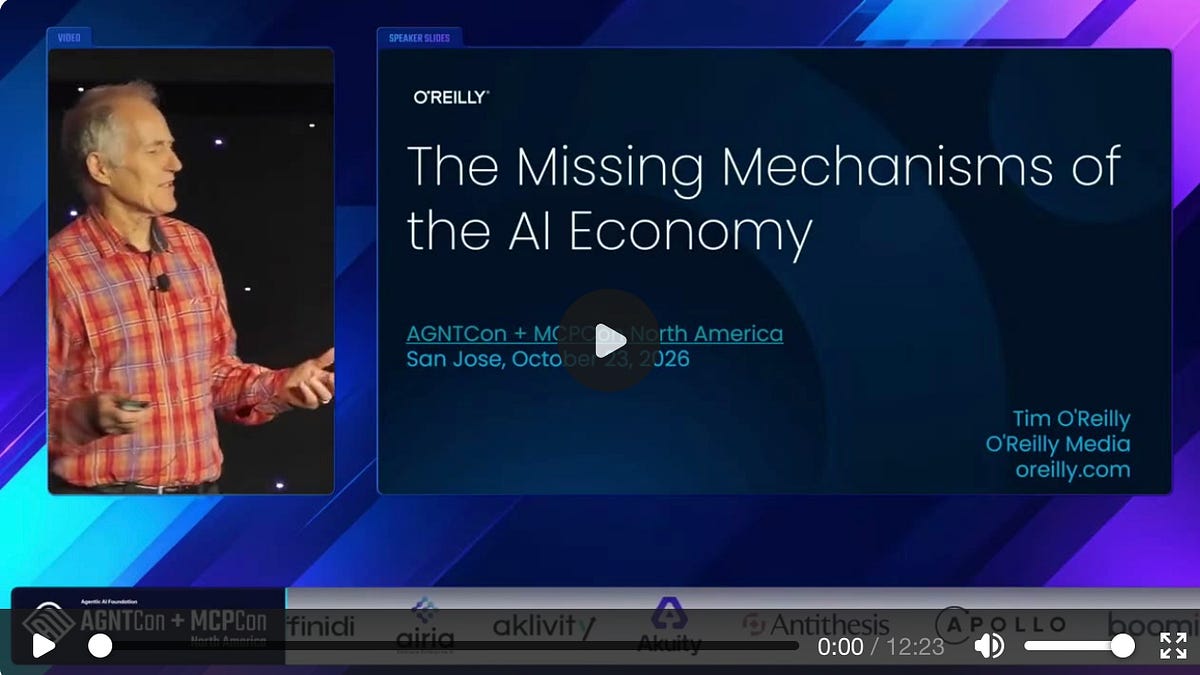
Tim O'Reilly谈AI未来:人类如何在AI经济中找到角色
来源标题:Human-Pilled – The Bitter Lesson Meets Architectures of Participation
Tim O'Reilly在AGNTCon + MCPCon North America的主题演讲中表示,他相信Richard Sutton提出的「苦涩教训」——依赖大规模算力的通用方法终将胜出,但人类仍需在AI经济中明确自身角色。他批评AI社区很少讨论如何让这一未来对人类更友好,并自称「human-pilled」。该演讲于2026年10月23日在圣何塞发表。
以下正文由 AI 翻译自 Hacker News 最新(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
Tim O'Reilly 2026年10月29日 30 2 11 分享 本文基于我与Demetrios Brinkmann为AAIF Live所做的对话,录制于2026年10月23日我在圣何塞AGNTCon + MCPCon North America主题演讲之前。为清晰起见,内容经过编辑和重新编排,部分内容取材于下方的主题演讲。两段视频也已发布在AI Disclosures Project网站新设的“Missing Mechanisms”页面上。 主题演讲从第二天直播的1:28:40处开始。 2019年,计算机科学家Richard Sutton写了一篇短文,题为《苦涩的教训》。回顾七十年的AI研究,他得出结论:随原始算力扩展的通用方法,会击败建立在人类专业知识之上的方法,而且优势巨大。借用互联网上对“虔诚信徒”的俚语说法,整个AI行业都“服下了苦涩教训之药”(bitter-lesson-pilled)。而我,是“人类药丸派”(human-pilled)。 我相信苦涩的教训。蛮力终将胜出,这一点我在整个职业生涯中一直在与之角力。但我们人类仍然必须弄清楚自己在AI经济中的角色,而让我颇感不安的是,AI社区并没有花更多时间去追问:如何让这个未来对人类更友好。实验室在思考如何防止AI失控,他们的首席经济学家在研究AI造成的失业。他们并不研究我们可以引入哪些机制,为人类创造新的经济机会。 这个问题对O'Reilly Media很重要。我们不把自己视为出版商、会议主办方或在线学习平台,而更像是一家把知识从最前沿的人传递给想要追随他们的人的公司。因此,我们非常关心人类专业知识的价值,即便面对AI也是如此。 人类专业知识曾被用来训练AI,这使得AI成为一种非凡的文化技术。几千年前,人们拥有的唯一知识就是能记在脑子里的东西。自那以后,我们建造了越来越好的方式,跨越时间和空间共享知识,而AI延续了这一进程。每一次这样的转变,我们都必须重新追问:真正属于人类的东西还值什么。人们常说判断力,或者说品味。没错,但我认为这更深一层: AI是一片可能性的海洋。所有知识都静置于模型之中,除了人类,没有什么能让它动起来。(随着我们开始给AI agent分配长时间运行的任务,这一点正在略微改变,我们将不得不面对它。)如果你和我用Claude或ChatGPT做同一个研究项目,我们会各自带来不同的经验,以不同的方式告诉它我们想要什么、为什么想要,并以不同的方式为它提供上下文。我认为这就是人类意识和注意力独特的聚焦力量。 今年早些时候,我花了大约一个小时与Claude讨论这个问题。当它提出可以替我写一份初稿时,我说不。我想要一篇它从自身视角出发、讲述它从我们的对话中收获了什么的小文章。结果就是《Why AI Needs Us》,开头写道:“他从Powys走了进来”,几段之后又说:“入口的选择本身就已经是论点。”这恰好抓住了我想表达的意思。我是通过一本我喜爱的书进入这场对话的——John Cowper Powys的《The Meaning of Culture》,这本书区分了文化与教育。Powys引用了一个定义:“文化是你忘掉所有你明确着手去学的东西之后,剩下的东西。”它是你吸收的东西。我们每个人都吸收着万物中微小而独特的一片。大语言模型(LLM)试图吸收一切,因而变得过于笼统;我们赋予它们焦点。人类知识为它们提供了一副透镜。 让我把这个道理放进商业语境。O'Reilly Media的CTO Andrew Odewahn构建了一个研究助手,用来帮助管理IT组织中的技术。你教它你的基础设施:你使用的工具,以及每个工具的权威信息存放在哪里。当他的一位工程经理说团队超负荷、要求再招一个人时,Andrew让这个agent去分析该部门的工作,它同意这个团队需要再招一个人。然后,他一时兴起,尝试了另一种做法。O'Reilly Media有一个MCP server,我们称之为O'Reilly Expert Intelligence。(MCP,即Model Context Protocol,是一种将AI模型连接到外部工具和数据的开放标准。)它让模型能够透过我们自身专家知识体系的滤镜来回答问题。Andrew问,O'Reilly的专家们会怎么说。 模型说,从Google的《Site Reliability Engineering》一书的视角来看,这完全是在重新思考问题。这本书描述了“toil”(苦役)——维持系统运行的手动、重复性工作,它随着系统增长而增长。在分析了该团队的toil之后,模型得出结论:再招一个人只会让问题更糟。这个团队需要一次toil审计,找出为什么会有这么多开销,然后进行重组。 这些知识大部分本来就在模型里,因为AI公司或多或少盗版了我们的书。它之所以给出一个完全不同的答案,仅仅是因为被要求咨询一组特定的专家。我认为这里有一个隐喻。LLM知道一切,结果就是它什么都不知道。我们人类要局限得多,但正因我们聚焦于某个特定问题,我们能以不同的方式把事物联系在一起。 去年我写了一篇题为《Magic Words》的文章,讲的是有些词承载的上下文远多于其他词。这听起来像是个微不足道的观察,但如果你把它展开,会引向有趣的方向。我们的一位培训师教一门生产力课程,他指出,你不需要了解艾森豪威尔矩阵或David Allen的《Getting Things Done》,就能让ChatGPT用其中之一来整理你的任务清单。那一个魔法词——“GTD”——就带来了一大堆上下文。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。