IBM发布Quantum Nighthawk r3处理器,计划2027年实现千比特级系统
来源标题:IBM Quantum Nighthawk Demonstrates New Levels of Speed and Quality
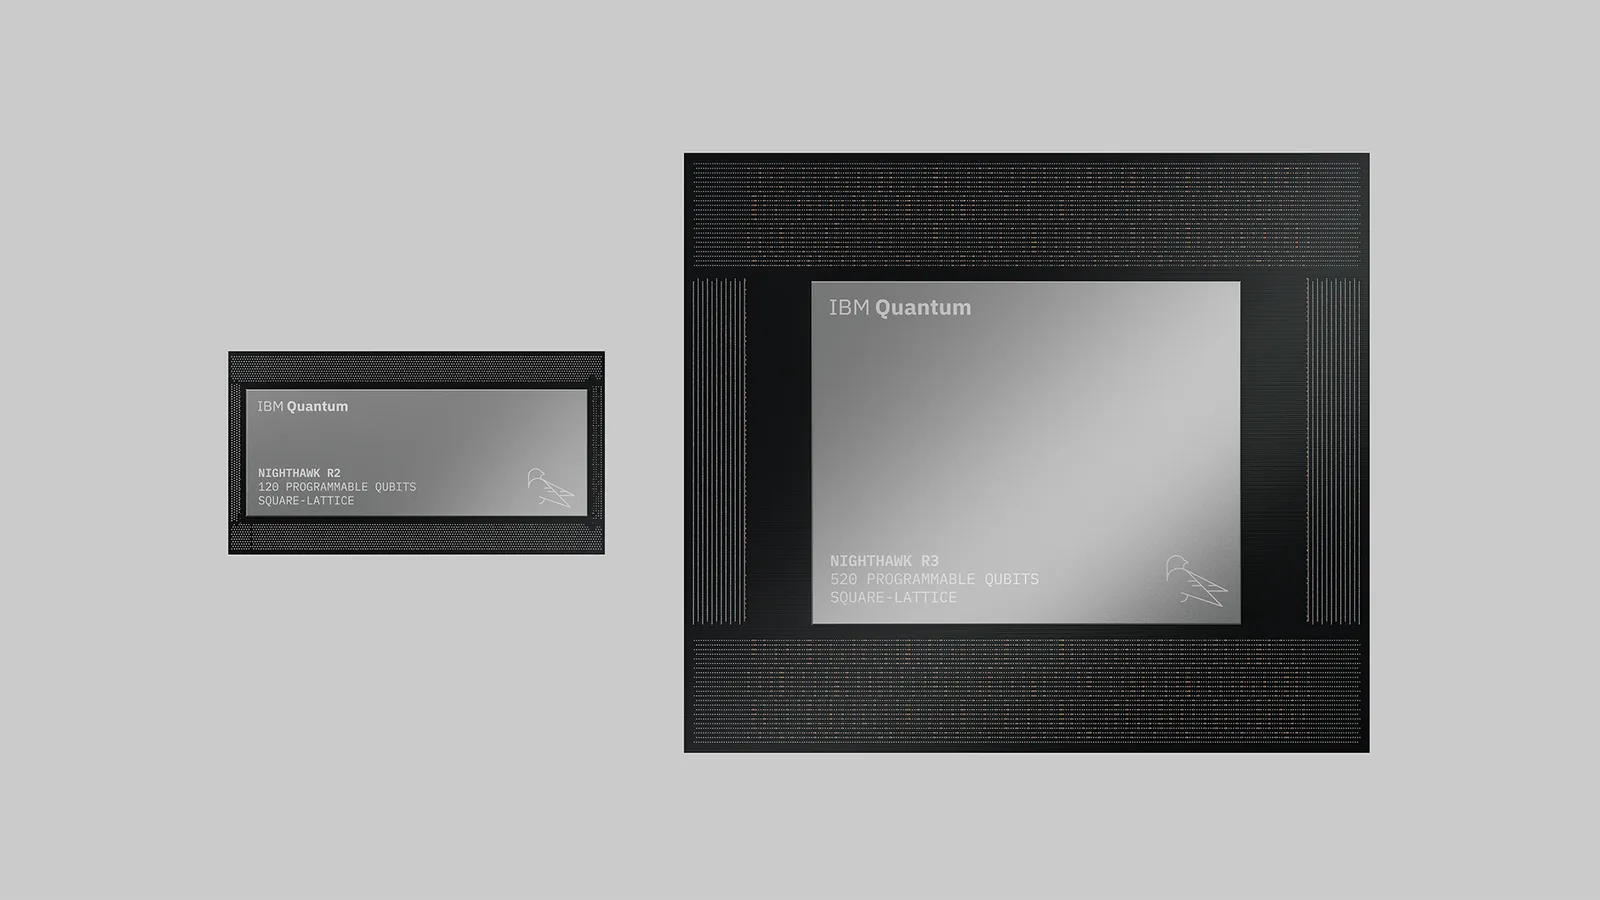
IBM宣布下一代处理器IBM Quantum Nighthawk r3将能在520个量子比特上准确执行1万次量子操作,在保持现有Nighthawk速度与质量的同时处理更大更复杂的问题。IBM计划于2027年将两个Nighthawk r3处理器连接为单一系统,量子比特数超过1000。此前9月推出的Nighthawk r2可在真实工作负载下提供最多10万个采样。
以下正文由 AI 翻译自 Hacker News(原文版权归原站所有),可能存在偏差,重要内容请以原文为准。
纽约州约克敦海茨,2026年11月11日——IBM(纽约证券交易所代码:IBM)今日宣布,其下一代处理器IBM Quantum Nighthawk r3将能够在520个量子比特上精确执行10,000次量子操作,以应对更大、更复杂的问题,同时保持当前已上市的Nighthawk所展现的速度与质量。2027年,IBM计划将两个Nighthawk r3处理器连接为单一系统,量子比特数超过1,000个。
要站在量子计算的前沿,与行业相关的应用既需要计算质量,也需要速度。速度之所以重要,是因为量子计算机以采样方式给出答案:量子电路每运行一次返回一个结果。应用日益需要在约100个或更多量子比特上执行数千次量子操作的电路,产生数百万到数十亿个样本。规模和质量使计算日益复杂成为可能,但速度决定了这些高负载工作能否在切实可行的时间框架内、以合理成本完成。
Nighthawk r2:为真实工作负载提供速度
IBM Quantum Nighthawk r2于今年9月推出,每秒可提供多达100,000个样本,同时支持在120个量子比特上执行超过7,500次量子操作的精确计算。其高速量子比特复位技术大幅缩短了电路执行之间的间隔时间,使应用能够以高得多的效率收集复杂计算所需的数百万或数十亿个样本。
包括E.ON、Algorithmiq和Q-CTRL在内的客户与合作伙伴迄今已在Nighthawk r2上执行了340亿个电路,报告性能提升最高达19倍,同时保持了科学计算所需的质量。
这些成果已在多个行业展现出价值。E.ON报告称,在用于能源电网优化的量子机器学习中,Nighthawk r2实现了15倍加速。IBM使用Nighthawk r2,将今年早些时候与Oak Ridge National Laboratory开展的一项实验加速了12倍,该实验模拟了真实磁性材料,所得结果与中子散射实验一致。这两项加速均是相较于此前在IBM Quantum Heron上的工作实现的。Quantum Elements和ParityQC也是报告其自身Nighthawk r2工作负载性能显著提升的合作伙伴之列。
IBM及其合作伙伴于7月发表的量子优势实验最初在IBM Quantum Heron上运行,其电路和结果通过社区主导的Quantum Advantage Tracker公开提供,供独立测试。与Algorithmiq合作开展的一项模拟异质量子材料的实验现已扩展到Nighthawk r2,借助其速度和连接性,电路执行速度比最初在Heron上的实验快8倍。与此同时,新电路对经典计算机的模拟难度显著提高——使用领先的经典张量网络方法要达到可比精度,估计需要多出240倍的内存。
Nighthawk r3:扩展至超过1,000个量子比特
在Nighthawk r2所展现的性能基础上,Nighthawk r3将把同样的高速架构扩展到更大的量子计算机。新处理器设计为在520个可编程量子比特上支持10,000次量子操作,物理量子比特总数为2,034个。它保留了r2的方形晶格连接性和快速操作,同时引入10个名为l-coupler的芯片间互连,旨在将处理器连接成更大的系统。
IBM已经展示了实现这一模块化方法的两项关键技术。今年,IBM使用四个l-coupler连接了Nighthawk r1处理器,实现了99.3%的量子态传输保真度,并向99.9%的目标推进。IBM还首次将两个低温模块连接为单一系统,在不到五天内达到工作温度,并冷却至15毫开尔文以下。
这些进展共同展示了模块化方面的关键进步,并增强了人们对IBM将Nighthawk扩展至更大规模量子计算机能力的信心。2027年,IBM计划将两个Nighthawk r3处理器连接为单一的1,040量子比特系统,将其高性能架构扩展到更大、更复杂的计算。
量子与经典在IBM Quantum Platform上融合
推进量子计算机的发展,需要它们在如何与经典计算协同处理错误方面持续取得进展。与行业相关的工作负载将需要多层量子纠错和错误缓解技术,以及噪声学习和后处理。随着量子工作负载规模扩大,它们将需要更多经典资源,而当前的挑战在于如何最好地扩展这种集成。
为统一这些范式,IBM Quantum Platform正在将高性能(HPC)经典计算与量子计算整合到一个统一管理的环境中。用户现在可以将量子工作流直接与一系列经典计算资源集成——无论是自己的笔记本电脑还是强大的超级计算机——或者与平台上新提供的HPC和经典资源集成。
用户正从这些集成中看到令人鼓舞的成果。例如,利用新环境,IBM和RIKEN*的科学家执行其原始的基于采样的量子对角化(SQD)工作流的速度提高了约5倍,同时执行的计算量比原始研究多100倍。Cleveland Clinic和RIKEN还利用该平台自动处理了6.08亿个样本,用于建模具有生物学意义的结构,速度比没有工作流自动化时快33倍。
(原文较长,此处译出前 6000 字,完整内容请点「打开原文」。)
正文由 探How 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。