资讯与观察
AI 行业动态、工程实践、产品方法和社区故事。
高考出分才找AI?这家黑马把升学规划提前到了小学
2026年夏天,AI填志愿彻底火出圈了。 千问、豆包、Kimi轮番上阵,各家通用大模型恨不得在高考出分那三天把全中国家长的焦虑一口气吞下。
CoMaps 发布 10 月更新:暗色地图改进、轨迹导航上线
CoMaps 公布 10 月开发进展,新版应用预计一周内发布。更新包括改进暗色地图样式、Android 端新增路线预览模式,并实现用户长期呼吁的已保存轨迹导航功能。
8 分钟 · Hacker News 最新
Meta、Google、TikTok 起诉加州总检察长,试图阻止未成年人社交媒体限制法
Meta、Google 和 TikTok 分别起诉加州总检察长 Rob Bonta,试图阻止原定明年生效的 AB 1709 法案。该法禁止向 16 岁以下用户提供自动播放视频和个性化信息流,违规平台可能按每位受影响用户被罚最高 5 万美元。三家公司均主张该法违反第一修正案,并受 Section 230 保护。
15 分钟 · TechCrunchLATEST STORIES
最新内容
Claude Code女掌门人光速投OpenAI!昨天才告别Anthropic,今天就倒戈精选导读
昨天宣布离职的Claude Code产品一姐,居然去OpenAI了? 昨天,她发完告别信,还跟网友开玩笑说「等实现AGI之后再休吧」,大家还以为她要去创业了。
视频解析日本人为何在名字后加「-san」称呼精选导读
一段视频解释了日本人为什么习惯在名字后加「-san」这一称呼。内容围绕该敬称的用法与文化背景展开。
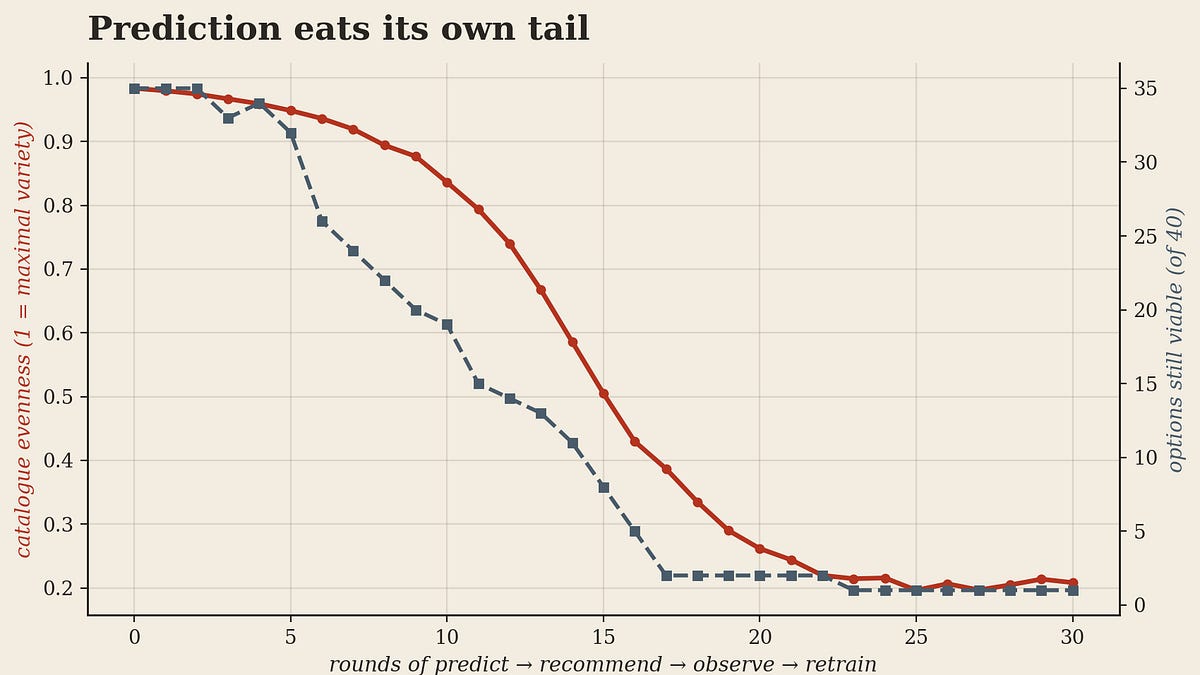
个性化算法为何让世界趋于同质化精选导读
算法越了解个体,人们的生活场景反而越趋同,而非更加多元。作者以自身在多国找房经历为例,发现各地公寓与咖啡馆都收敛为同一套模板,指出推荐算法在高度个性化数据下制造出千篇一律的世界。
OpenAI收购神秘团队!奥特曼要在Codex里再造一个GitHub精选导读
今天的硅谷,太热闹了! 刚刚,OpenAI官宣收购了一家神秘初创团队——Pierre Computer。
Thinking Machines 发布 Inkling 2 Small,594B 参数 MoE 模型精选导读
Inkling 2 Small 是第二代模型,采用 MoE 架构,总参数 594B、激活 17B,支持图像输入和可变推理强度,在 Artificial Analysis 智能指数上得分 31,超过上一代。模型先在 Tinker 平台以闭源权重提供,计划下周外部安全测试完成后以 Apache 2.0 许可开放全部权重。
Thinking Machines 发布第二代模型 Inkling 2 Small精选导读
Thinking Machines 推出第二代模型 Inkling 2 Small,这是一个总参数 594B、激活参数 17B 的混合专家模型,支持图像输入和可变推理强度。该模型在 Artificial Analysis 智能指数上得分 31,明显超过前代,在智能体编程、视觉、知识工作和推理方面均有提升。模型目前通过 Tinker 以闭权重方式提供,完整权重计划在外部安全测试完成后于下周以 Apache 2.0 许可证开放。
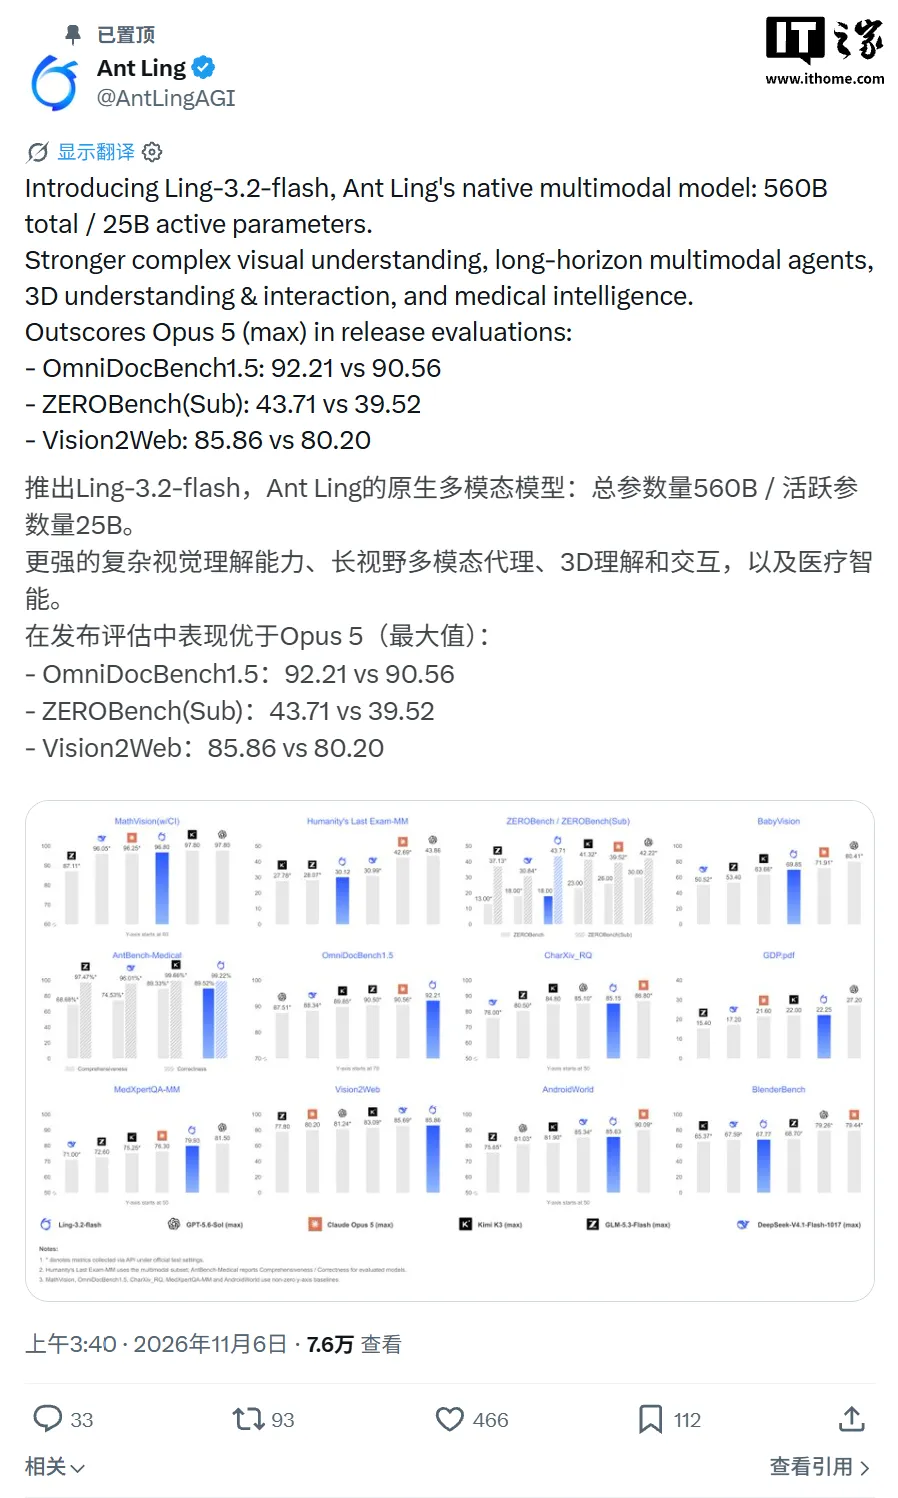
蚂蚁百灵大模型 Ling 3.2 Flash 发布:三项基准超越 Claude Opus 5,前两周限时免费精选导读
IT之家 11 月 6 日消息,蚂蚁百灵官方团队今日宣布推出原生多模态模型 Ling-3.2-flash,拥有 560B 总参数、25B 激活参数、1M 上下文窗口。 该模型从架构层面原生融合视觉与语言能力,支持图像、文本与视频输入,重点强化复杂视觉理解、多模态长程 Agent、3D 理解与交互、医疗多模态四大能力。 在蚂蚁官方公布的评测结果中,Ling-3.2-flash 在三项基准上超过 Anthropic Claude Opus…
Open ASR 排行榜新增埃及与尼日利亚英语口音数据精选导读
Open ASR Leaderboard 与 Liva AI 合作,新增埃及和尼日利亚两种英语口音的非公开测试数据,以提升 ASR 评测的代表性和可信度。此前该榜单已加入 Appen、DataOceanAI 的 11 个非公开数据分片,以及 Voice Arena 的印度口音英语数据。

OpenAI 联合 Ligo 推出 BioBasicsBench,评测 AI 智能体处理湿实验室日常任务的能力精选导读
OpenAI 与生物科技公司 Ligo 合作推出 BioBasicsBench,用于衡量 AI 智能体解读原始实验数据、应对湿实验室日常任务的能力。该基准包含 100 项常规湿实验室任务,覆盖失败实验、模糊图像和相互矛盾的观察结果等现有基准容易忽略的场景。测试显示 GPT-6 Astra 相较 GPT-5.6 Sol 有所提升,但模型在某些方面仍存在不足。