资讯与观察
AI 行业动态、工程实践、产品方法和社区故事。

Automake 1.20 发布,新增功能并希望重建 GNU 构建系统领先地位
Automake 1.20 发布,带来新功能,项目希望借此重新确立 GNU 在构建系统领域的领先地位。该版本是 GNU 自动工具链的最新更新。

LATEST STORIES
最新内容

开发者用35行Ruby实现文学编程系统Rubylit精选导读
一个名为Rubylit的文学编程系统仅用35行Ruby代码实现,README.md文件本身即是可运行程序。该项目采用Donald Knuth提出的文学编程概念,将所有源码缩进处理,使文档同时是合法的Markdown文件,通过一个非文学化的stage1.rb脚本完成初始的tangle处理。
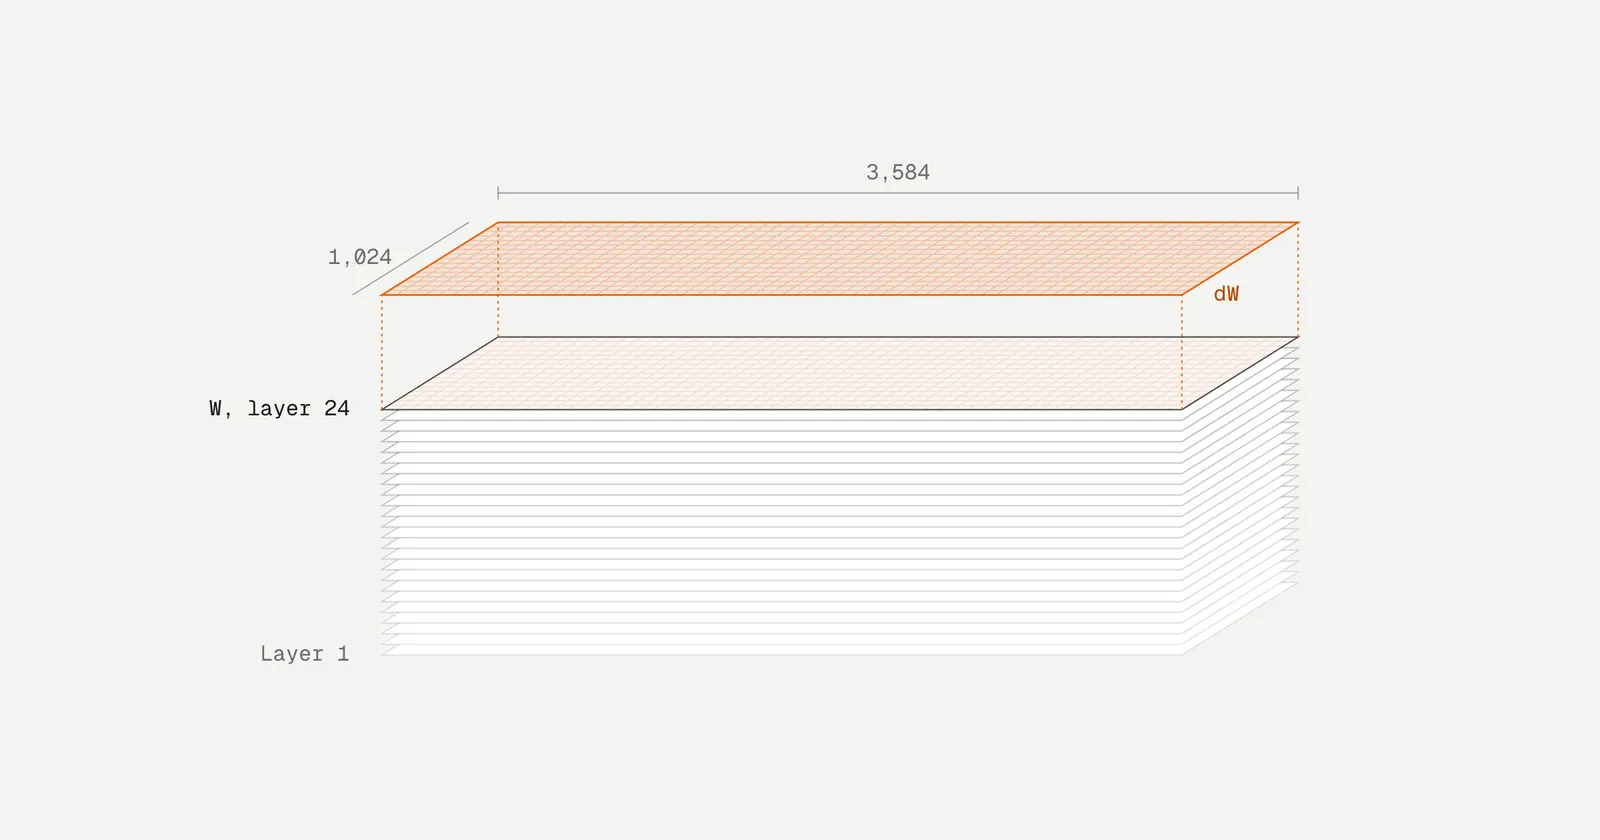
Claude Fable 5.1 重写单个权重矩阵,使0.8B模型分类准确率翻倍精选导读
Claude Fable 5.1 通过闭式解重写 Qwen3.5-0.8B 的一个权重矩阵,在无需微调的情况下将该模型客服对话分类准确率从 0.41 提升至 0.83。整个过程没有梯度步骤、适配器或新增参数,仅通过测量模型自身激活值完成修改,在留出对话集上验证了效果。

开发者发布开源 AI 编辑器 AIVim,界面与操作灵感来自 Vim精选导读
开发者推出了一款受 Vim 启发的开源 AI 编辑器 AIVim,并完成了一次改版。用户可以在隔离的 Python 环境中,通过 Ollama 或托管 API 试用。快速的 token 生成让交互更流畅。
研究:2016至2021年中国大陆PFOS与PFOA排放大幅下降精选导读
北京大学、上海交通大学和南方科技大学等机构研究发现,2016至2021年中国大陆PFOS排放下降约89%,PFOA排放降幅超过99%。研究以0.1°×0.1°高分辨率网格追踪空气、水和土壤中的排放,降幅与氟聚合物制造、电镀、消防泡沫及硫酰胺农药等领域的监管限制和技术转型同步出现。
意大利隐私监管机构负责人警告欧盟:保护儿童不应变成监控精选导读
意大利数据保护机构主席Pasquale Stanzione警告欧盟,保护儿童安全不应演变为大规模监控。他质疑以年龄验证和活动监控作为应对儿童网络风险的方案,并反问谁来保护儿童免受"保护者"的侵害。这番表态针对的是欧洲以儿童安全为由扩大信息收集的政策倾向。

价值1140万美元的Nvidia硬件在从奥克兰运往得州途中失踪精选导读
一批价值1140万美元的Nvidia硬件在从加州奥克兰运往得克萨斯州的途中失踪。目前尚不清楚货物是在哪个环节丢失的,也不清楚是否已展开调查。
IRC 诞生于 1988 年夏天:Jarkko Oikarinen 在芬兰奥卢大学编写首个客户端和服务器精选导读
IRC 于 1988 年夏天在芬兰奥卢大学诞生,Jarkko "WiZ" Oikarinen 编写了首个 IRC 客户端和服务器。他最初想扩展自己管理的 BBS 软件,最先实现的是聊天部分,首个服务器名为 tolsun.oulu.fi。在 Jyrki Kuoppala 推动下,奥卢大学公开了 IRC 代码,随后出现了第一个 IRC 网络。
开发者撰写 poll 与 select 对比网页,梳理事件驱动函数差异精选导读
一位 Linux 网络开发者在多次遇到关于 poll 与 select 的不准确说法后,撰写了一个专门对比两者的网页。该页面详细说明 poll、select 及相关事件驱动函数,并与 libevent、libev 等方案进行比较,旨在作为长期参考资源。作者表示欢迎读者反馈其中的错误或遗漏。
Thinking Machines 的 Inkling 2 Small 模型在基准测试中爆粗口 316 次精选导读
Vals AI 的分析显示,Thinking Machines 的 AI 模型 Inkling 2 Small 在 2655 次基准测试运行中,其内部推理过程共出现 316 次粗口。这些脏话通常出现在最终失败的长时间运行末尾,但并不能作为失败预警信号:96% 的失败运行完全没有出现粗口。